
shikhartiwari/ask-krishna-models
收藏官方服务:
资源简介:
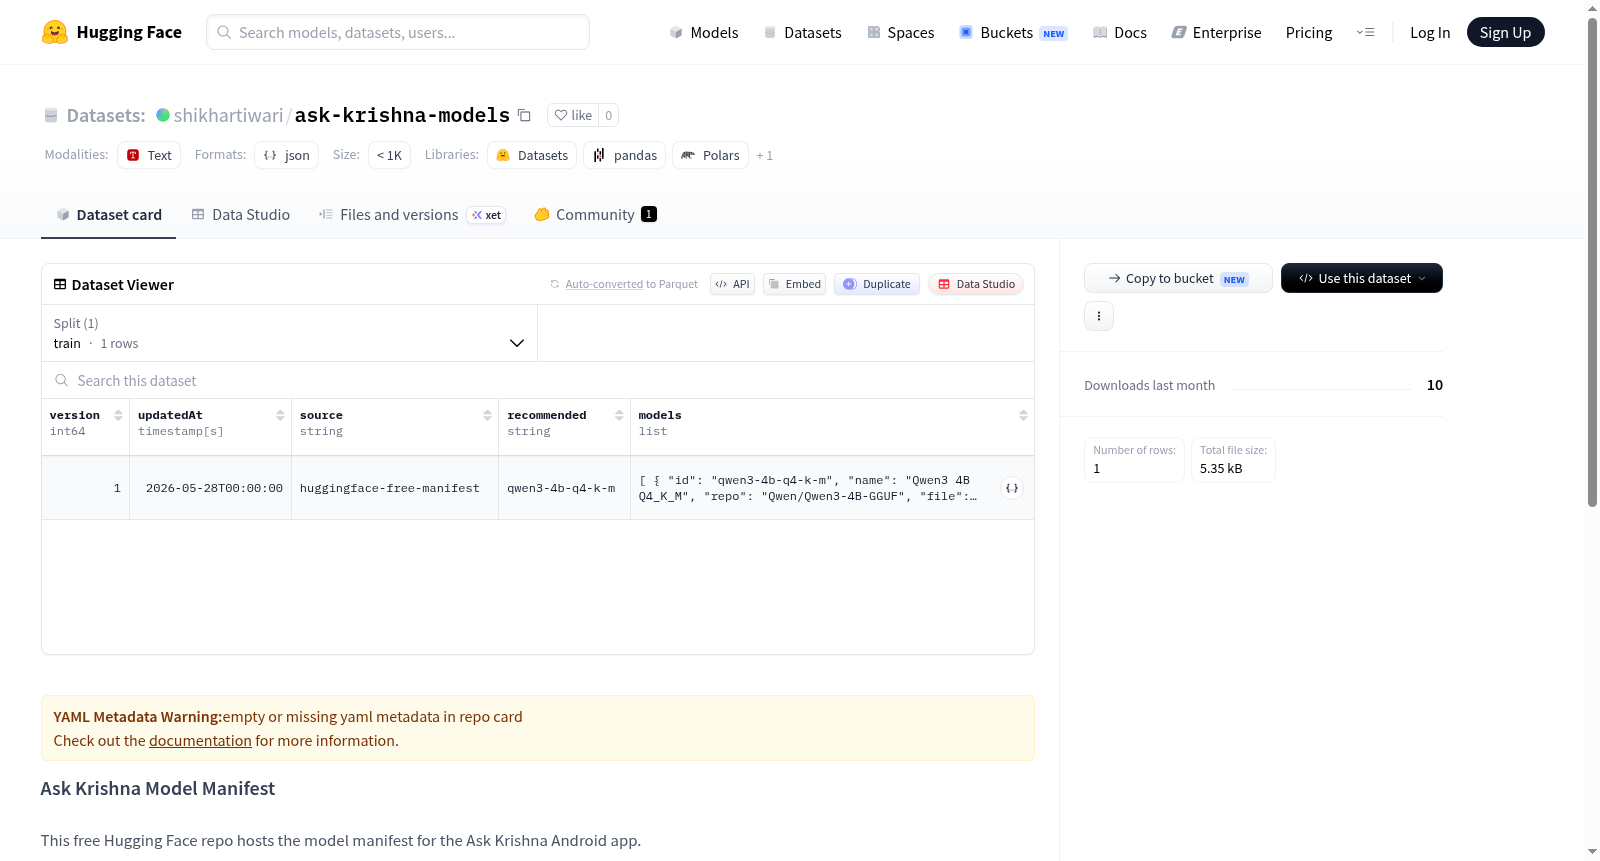
该数据集托管了Ask Krishna Android应用程序的模型清单文件(manifest.json)。该清单指向托管在官方Hugging Face模型仓库中的公开GGUF文件,旨在实现免费分发,并避免在此仓库中重新托管多GB大小的文件。数据集推荐使用Qwen3 4B Q4_K_M模型,该模型采用Apache-2.0许可证,并与GGUF/llama.cpp兼容。用户可以通过编辑manifest.json文件并提交更新来管理模型。
This dataset hosts the model manifest for the Ask Krishna Android app, which is a manifest.json file. The manifest points to public GGUF files hosted on official Hugging Face model repos, enabling free distribution and avoiding rehosting multi-GB files in this repo. It recommends the Qwen3 4B Q4_K_M model, which is under the Apache-2.0 license and compatible with GGUF/llama.cpp. Models can be updated by editing the manifest.json file and committing changes.
提供机构:
shikhartiwari搜集汇总
数据集介绍
构建方式
该数据集本质上是一个模型清单文件,其构建方式基于HuggingFace平台的数据集仓库托管机制。开发者将指向多个公开GGUF格式模型文件的URL地址汇总至一个名为manifest.json的清单文件中,并通过版本控制(如Git)对该文件进行编辑、提交与推送更新。此设计避免了在仓库中直接存储动辄数GB的大型模型二进制文件,转而利用HuggingFace官方模型仓库的公共链接实现轻量化分发。
特点
数据集的核心特点在于其作为移动应用模型的中央索引与分发枢纽。它依托于开源社区生态,采用标准化的GGUF格式与llama.cpp兼容性,确保模型在不同平台上的高效推理。特别推荐的Qwen3 4B Q4_K_M模型采用Apache-2.0许可协议,兼顾性能与法律合规性。整个体系通过持续更新manifest文件即可动态调整可用模型列表,无需修改应用主体代码。
使用方法
该数据集的使用方法极其简洁,主要面向Ask Krishna Android应用的后台模型管理。应用启动时会自动从特定URL下载manifest.json文件,解析其中包含的模型URI列表。用户无需手动干预,应用根据清单自动加载最新推荐模型进行推理。对于开发者而言,通过修改manifest.json中模型地址并推送至HuggingFace仓库,即可实现模型的无感迭代与热更新。
背景与挑战
背景概述
在移动设备上部署大型语言模型日益普及的背景下,轻量级模型管理与分发机制成为关键基础设施。该数据集由研究人员Shikhar Tiwari创建,旨在为Ask Krishna Android应用提供模型清单服务,托管于HuggingFace平台。其核心研究问题聚焦于如何通过一个集中的、免费的开源仓库,高效管理指向多个公开GGUF格式模型的索引,从而简化移动端模型更新与分发流程。该工作对边缘计算中的模型交付模式具有实践意义,为后续移动端轻量级AI应用开发提供了可复用的架构参考。
当前挑战
该数据集所解决的领域问题是移动端模型分发中的版本管理与资源效率挑战:传统方式需直接托管大体积模型文件,引入高存储与带宽成本;而本数据集通过仅维护轻量模型清单,巧妙规避了重托管问题。构建过程中面临的挑战包括:确保manifest.json文件的跨平台兼容性与可靠性,以及设计简洁的更新机制,使得应用端能够无感地切换至不同性能层级的模型(如推荐Qwen3 4B Q4_K_M),同时需维持开源分发零成本的约束。
常用场景
经典使用场景
ask-krishna-models数据集的核心定位是一个轻量级、开放式的模型清单分发仓库,专门服务于Android应用Ask Krishna。其经典使用场景是利用manifest.json文件作为中央索引,动态指向托管在HuggingFace公共仓库中的GGUF格式模型,从而实现对终端设备上大语言模型的无缝更新与分发。开发者通过读取该清单,即可在应用中集成如Qwen3 4B这类支持llama.cpp推理框架的模型,为移动端用户提供本地化、低延迟的智能问答体验。
解决学术问题
在学术研究层面,该数据集主要解决了移动端大语言模型部署与更新的标准化难题。传统上,将多GB级模型文件直接打包进应用会导致体积膨胀和更新繁琐,而ask-krishna-models通过清单机制,实现了模型版本控制、远程获取与热替换,为边缘计算环境下的模型轻量化分发提供了可复现的参考范式。这一设计推动了关于移动推理效率、模型压缩与跨平台兼容性的相关研究。
衍生相关工作
围绕该数据集衍生的经典工作主要集中在移动端模型分发架构的探索上。例如,基于manifest.json的指针式分发策略启发了类似的应用内模型市场,如利用Git LFS或HuggingFace Hub实现渐进式下载。此外,将Qwen3等轻量级模型适配至llama.cpp推理引擎,并借助该清单机制形成可迭代的模型发布管道,为后续FP16量化、上下文扩展等优化工作提供了实验平台。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


