
遇见数据集

VGIF-Bench

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

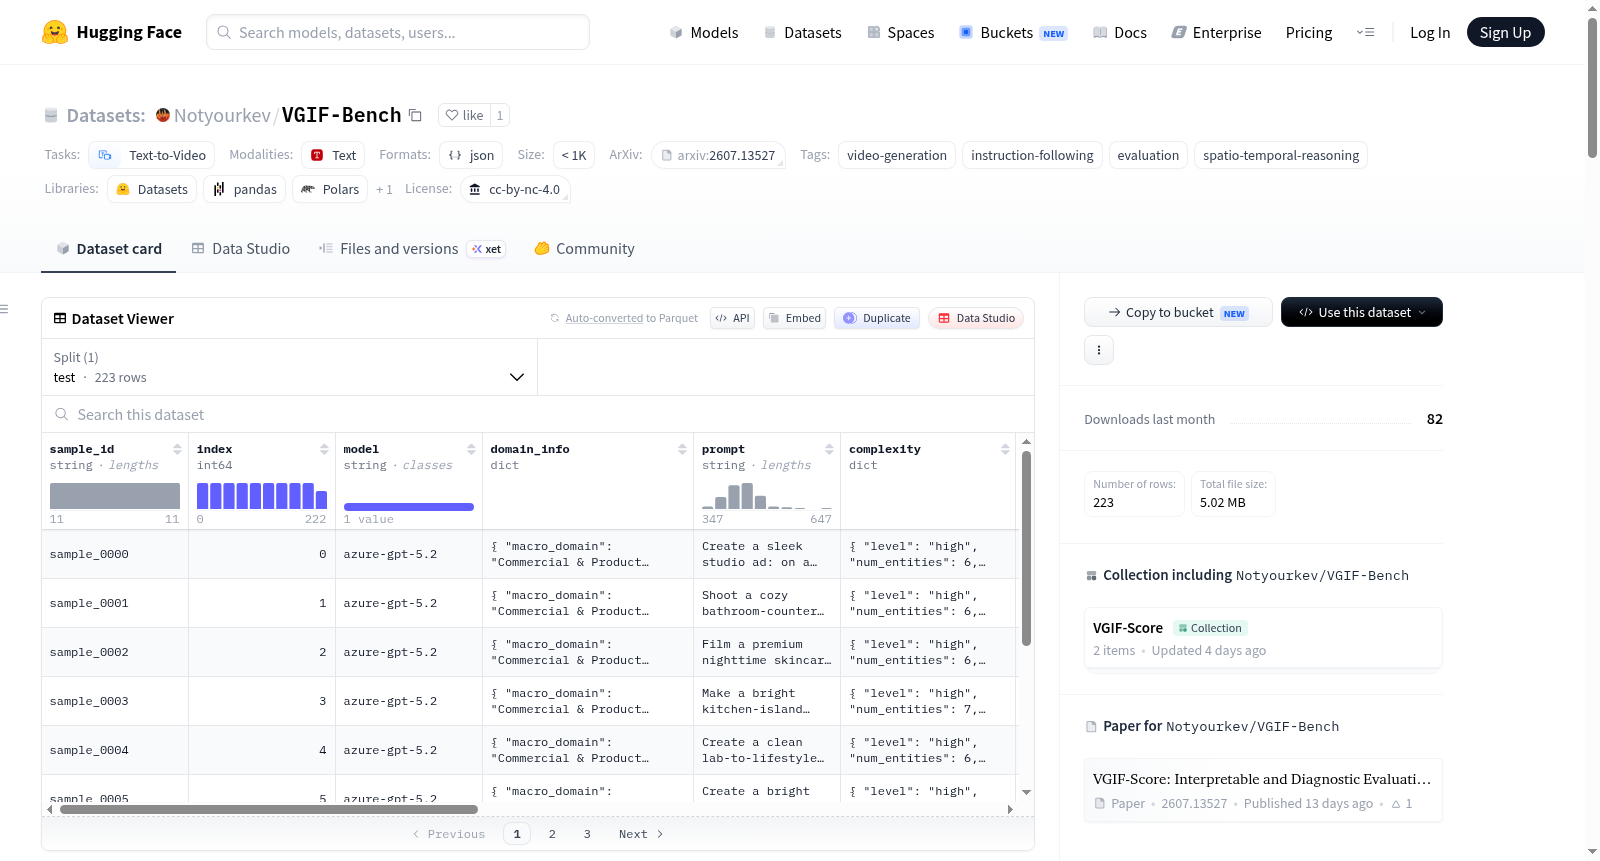
VGIF-Bench是一个用于文本到视频生成的诊断性基准测试,专注于评估模型在时空指令跟随方面的能力。其核心目标是通过将每个生成提示表示为显式的时空依赖图(ST-DAG),使视频生成中常见的失败(如遗漏触发动作、错误转换对象或破坏时间顺序)变得可测量。数据集包含223个提示,覆盖8个宏观领域和38个微观领域,例如产品展示、电影叙事、物理交互、具身表现和现实世界场景。每个数据样本以JSONL格式提供,包含长格式生成提示和领域元数据、类型化的时空依赖图节点和边、带有布尔依赖表达式的原子问答对、用于评估电影摄影、视觉纯净度、运动流畅性和物理遵循性的提示特定自动评估维度,以及对生成视频进行诊断解释的指导。该基准仅包含测试集,用于评估规范,不包含训练标签。数据集旨在支持对视频生成模型在复杂时空推理和指令跟随方面的细粒度、可解释性评估。

VGIF-Bench is a diagnostic benchmark for text-to-video generation, focusing on evaluating models capabilities in spatiotemporal instruction following. Its core objective is to make common failures in video generation (such as missing triggered actions, incorrect object transformations, or violating temporal order) measurable by representing each generation prompt as an explicit spatiotemporal dependency graph (ST-DAG). The dataset contains 223 prompts, covering 8 macro domains and 38 micro domains, such as product showcases, movie narratives, physical interactions, embodied performances, and real-world scenes. Each data sample is provided in JSONL format and includes long-form generation prompts and domain metadata, typed nodes and edges of the spatiotemporal dependency graph, atomic question-answer pairs with Boolean dependency expressions, prompt-specific automatic evaluation dimensions for assessing cinematography, visual purity, motion fluency, and physical adherence, as well as guidance for diagnostic interpretation of generated videos. The benchmark only includes a test set for evaluation specifications and does not contain training labels. The dataset is designed to support fine-grained, interpretable evaluation of video generation models in complex spatiotemporal reasoning and instruction following.
创建时间:
2026-07-24
搜集汇总
数据集介绍
VGIF-Bench 数据集图片
构建方式
VGIF-Bench通过将每一条文本提示建模为显式的时空有向无环图(ST-DAG)来构建,将复杂指令拆解为原子节点与依赖边。每个样本包含提示文本、领域元数据、ST-DAG结构、原子级视觉问答对以及自动评分标准。完整测试集包含223条提示、3656个节点和3940条边,覆盖8个宏观域与38个微观域,所有数据以JSONL格式存储。
使用方法
用户可通过Hugging Face Datasets库直接加载测试集:`load_dataset("Notyourkev/VGIF-Bench", split="test")`,无需认证。每个样本包含prompt、st_dag、original_qa_pairs和autorubric字段。评估时,客观分支执行依赖感知的原子QA,主观分支计算四个维度评分的均值,最终得分为二者加权平均(0.5×S_obj + 0.5×S_sub)。
背景与挑战
背景概述
随着文本到视频生成技术的飞速发展,生成内容的视觉保真度已大幅提升,但模型对复杂时空指令的精确遵循能力却鲜有系统评估。VGIF-Bench由Songyu Xu、Xin Wang、Qiang Chen等来自PRIS-CV实验室的研究人员于2026年提出,旨在填补这一诊断性评估空白。该数据集创新性地将每条提示词显式建模为时空有向无环图(ST-DAG),通过223个精心设计的测试样本、涵盖8大宏观领域与38个微观领域,深入剖析模型在动作执行、对象操作与时序关系等维度上的表现。VGIF-Bench不仅为视频生成模型提供了超越视觉相似性的细粒度评估框架,更通过其结构化的因果链诊断能力,推动了该领域从全局质量评判向指令遵循能力的可解释性评估范式转变。
当前挑战
VGIF-Bench所面临的挑战主要源于视频生成领域对复杂时空指令遵循的评估困境。传统评测指标如FVD或CLIP相似度仅关注视觉外观,无法捕捉模型是否遗漏关键动作、错误修改对象或破坏既定顺序等结构性错误。为此,数据集构建过程中需将自然语言提示转化为包含3656个节点与3940条边的有向无环图,并设计依赖感知的原子问答对(3445对)与自动评分准则(892维度),这一过程对语义解析的准确性、图结构的完备性以及评估标准的客观性提出了极高要求。此外,如何确保评测结果在跨模型、跨场景下的可重复性,以及如何平衡客观分支(依赖感知QA)与主观分支(美学、意图等评分)的权重,也成为该基准在实践中必须持续攻克的难题。
常用场景
经典使用场景
VGIF-Bench的核心价值在于为文本到视频生成模型提供一种细粒度、可解释的诊断性评估框架。不同于传统仅关注视觉相似性的指标,该数据集将每一条提示指令转换为显式的时空有向无环图(ST-DAG),从而系统性地检验模型在空间编排、时间顺序、物理交互、情感氛围等八个宏观领域、三十八个微观维度上对指令的遵循能力。借助节点级原子问答与自动评分准则,研究者能够精确定位生成视频中遗漏的关键动作、错误修改的对象或紊乱的时序关系,为模型改进提供清晰的因果链指引。
解决学术问题
该数据集精准回应了当前视频生成评估领域的一大核心困境:视觉上精美的视频可能严重偏离指令含义,而现有指标难以捕获这种语义偏差。VGIF-Bench通过结构化的依赖感知评估,首次实现了对“指令遵循完整性”的量化诊断,揭示了模型在哪些原子单元上失败、哪些下游事件因此无法成立。这一工作推动了视频生成评估从单一质量打分向多维因果分析转型,为后续建立更严谨的生成基准和可解释性研究奠定了方法论基础。
实际应用
在实际产业场景中,VGIF-Bench可服务于视频生成模型的质量监控与定向优化。产品展示、影视叙事、创意设计等领域的从业者,能够借助该基准快速筛查模型在特定类型指令上的薄弱环节——例如,在“商品展示”域中检测模型是否遗漏了关键的交互动作,或在“动态世界”域中评估复杂场景的时空一致性。此外,该数据集的自动评分管道支持批量评估,便于企业在模型迭代过程中持续追踪指令遵循能力的提升效果。
数据集最近研究
最新研究方向
在文本到视频生成任务中,视觉保真度与指令遵循能力之间存在显著鸿沟——即使生成视频外观流畅,其时空逻辑与动作顺序仍可能偏离用户意图。VGIF-Bench 应运而生,通过将每条提示显式建模为有向无环图(ST-DAG),精确刻画动作、对象与因果链条的时空依赖关系,突破了以往仅依赖视觉相似性评估的局限。该基准涵盖八个宏观领域与三十八个微观场景,结合原子级视觉问答与评分算法,为模型提供细粒度的指令完成度诊断。这一创新不仅推动了视频生成质量评估从‘看起来合理’迈向‘实际上正确’,也为构建真正可控、可解释的生成系统奠定了评价基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

