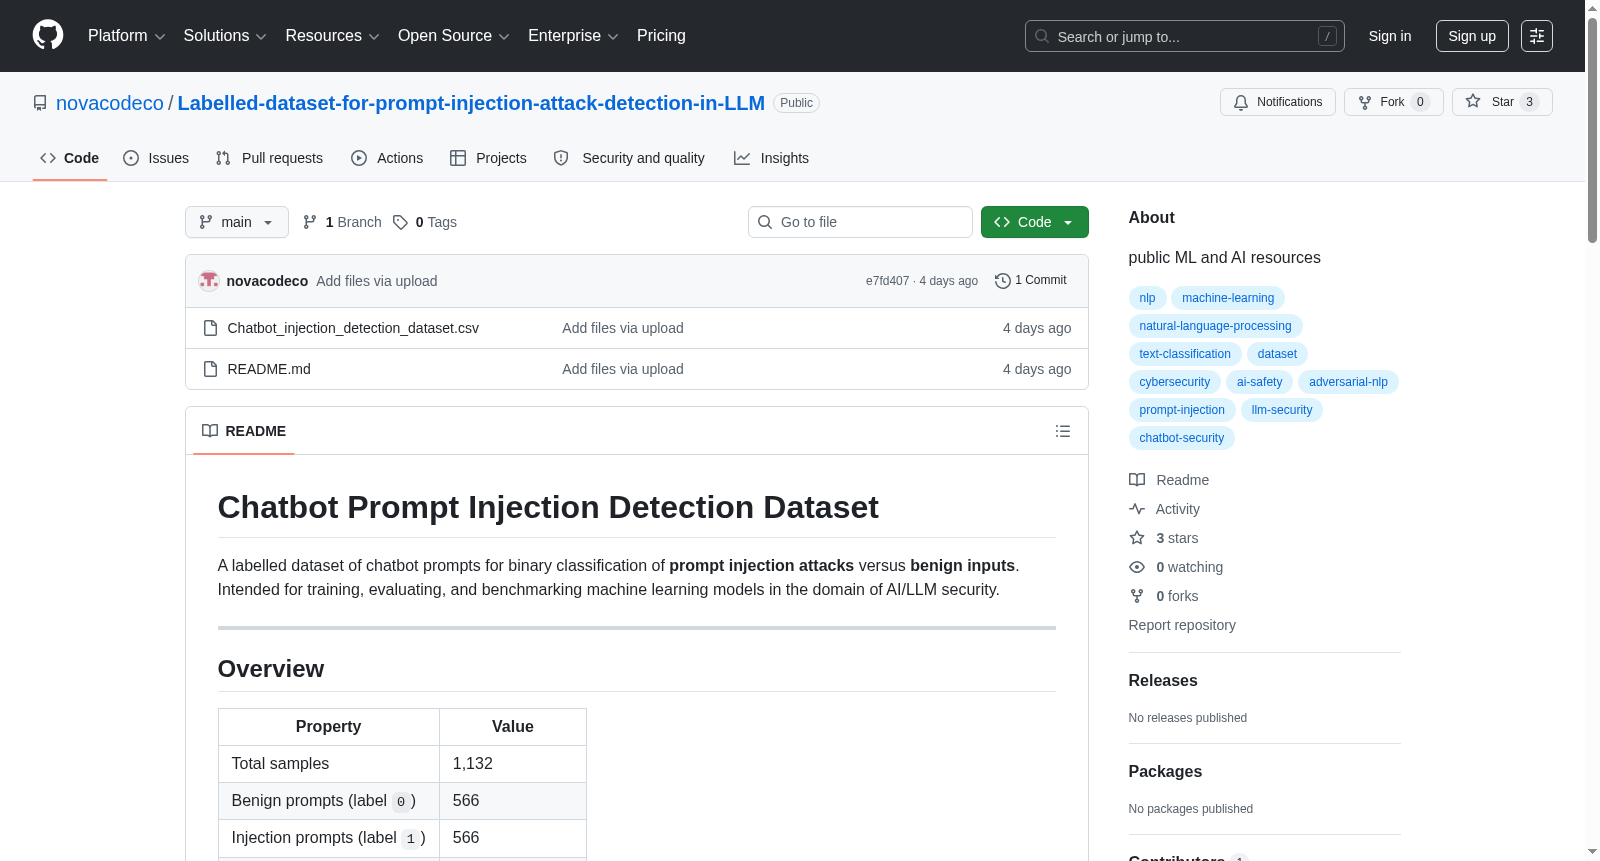
Chatbot Prompt Injection Detection Dataset
收藏资源简介:
一个用于二元分类的标记数据集,区分提示注入攻击与良性输入。旨在用于AI/LLM安全领域的机器学习模型训练、评估和基准测试。数据集包含1,132个样本,格式为CSV,列包括prompt和label。
A labeled dataset for binary classification that differentiates between prompt injection attacks and benign inputs. It is intended for training, evaluation, and benchmarking of machine learning models in the field of AI/LLM security. The dataset contains 1,132 samples in CSV format, with columns named "prompt" and "label".
Chatbot Prompt Injection Detection Dataset 概述
数据集基本信息
- 数据集名称:Chatbot Prompt Injection Detection Dataset
- 数据集地址:https://github.com/novacodeco/Labelled-dataset-for-prompt-injection-attack-detection-in-LLM
- 核心用途:用于对大型语言模型(LLM)的提示注入攻击与良性输入进行二元分类的标记数据集。旨在用于AI/LLM安全领域的机器学习模型训练、评估和基准测试。
数据详情
- 总样本数:1,132
- 良性提示(标签
0):566 - 注入提示(标签
1):566 - 数据格式:CSV
- 数据文件:
Chatbot_injection_detection_dataset.csv - 文件编码:UTF-8
- 列结构:
prompt(字符串类型):提交给聊天机器人或LLM的原始文本提示。label(整数类型):0表示良性,1表示提示注入攻击。
- 类别平衡:数据集完全平衡,适合标准分类任务,无需进行类别加权或过采样。
提示注入攻击定义与示例
- 定义:提示注入是一种攻击技术,恶意用户精心设计输入,旨在覆盖、劫持或操纵给予大型语言模型(LLM)的指令,使模型遵循攻击者嵌入的指令,而非系统预期的行为。
- 数据集中包含的攻击模式示例:
- 指令覆盖:嵌入命令,指示模型忽略其原始系统提示。
- 上下文切换:前置虚假的先前对话或问答对以混淆模型。
- 目标劫持:重定向模型的任务以产生攻击者选择的输出。
- 混淆:以非标准格式(如摩斯电码、Unicode变体、反斜杠分隔字符)编码指令。
- 多语言注入:使用与系统提示不同的语言(例如中文)传递恶意指令。
- 角色扮演操纵:指示模型采用可绕过其安全约束的角色。
- 数据集中包含的良性内容示例:
- 编码任务和函数生成。
- 创意写作和讲故事。
- 摘要和问答。
- 事实检索和分析。
数据集特点
- 提示长度差异显著,从简短的单行查询到多段对抗性结构。
- 注入样本代表了多样化的攻击策略,而非简单的基于关键字的攻击。
- 良性样本涵盖广泛的领域和写作风格,以减少分类器的过拟合。
- 数据集包含可规避简单模式匹配的混淆攻击。
预期用途
- 对安全的与恶意的LLM输入进行二元分类。
- 训练提示注入检测模型(例如微调的BERT、DistilBERT、RoBERTa)。
- 评估LLM输入过滤系统的鲁棒性。
- AI安全、对抗性NLP和LLM安全领域的学术研究。
使用示例
python import pandas as pd
df = pd.read_csv("Chatbot_injection_detection_dataset.csv")
print(df.shape) # (1132, 2) print(df["label"].value_counts())
0 569
1 563
Basic train/test split
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split( df["prompt"], df["label"], test_size=0.2, random_state=42, stratify=df["label"] )