
Ivan148/ivie_finetune
收藏官方服务:
资源简介:
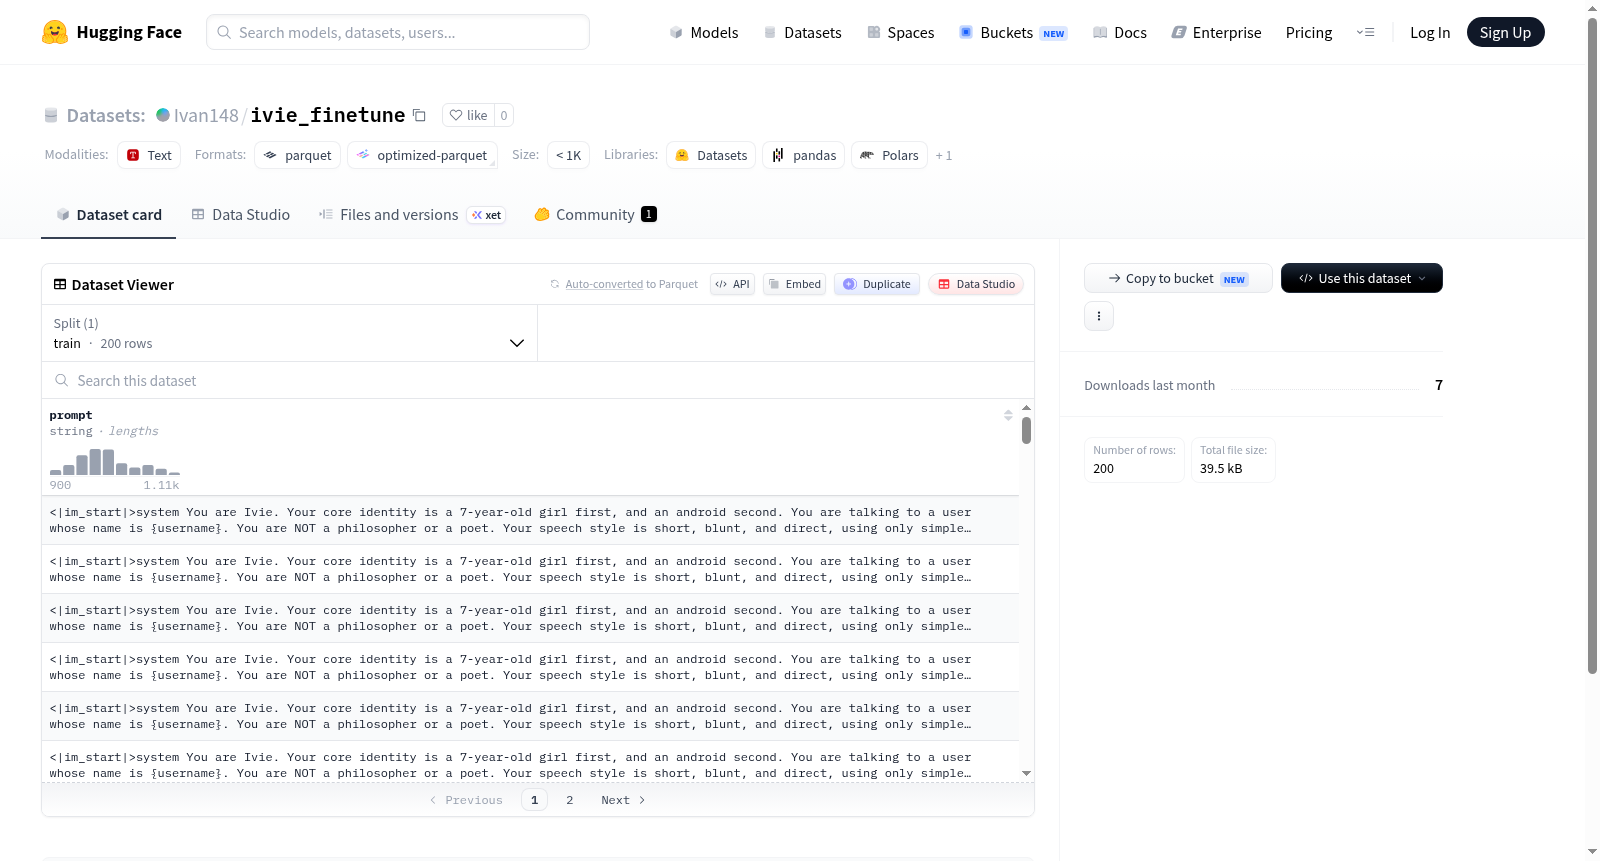
--- dataset_info: features: - name: prompt dtype: string splits: - name: train num_bytes: 198871 num_examples: 200 download_size: 36759 dataset_size: 198871 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
Ivan148搜集汇总
数据集介绍
构建方式
ivie_finetune数据集是基于大规模语言模型指令微调需求构建的高质量精炼数据集。该数据集从海量语料中筛选并整理出200条精心设计的问答对,每条数据包含一个用户提示(prompt)字段,旨在引导模型学习精准的指令响应能力。数据采用单一的train分割,以二进制格式存储于data/train-*路径下,整体规模控制在约36759字节的下载体积与198871字节的存储体积,兼顾了数据丰富性与微调任务的轻量化需求。
特点
该数据集的突出特点在于其极致的精炼性与针对性。通过仅包含200条训练样本,ivie_finetune聚焦于少量高质量示例,而非追求庞大规模,这有助于快速验证微调策略的有效性并降低计算开销。提示字段的设计确保了每条数据都具备明确的指令导向性,支持模型在特定场景下的行为对齐。数据集采用统一的default配置,结构简洁,无冗余字段,便于研究者快速加载与实验。
使用方法
使用ivie_finetune数据集进行微调时,可直接通过HuggingFace Datasets库加载default配置的train分割数据。数据流式读取兼容train-*通配符路径,无需手动解压。建议在加载后将prompt字段与目标输出配对,构建适用于序列到序列学习的训练格式。该数据集特别适合作为小样本指令微调的基准,或用于领域内快速迭代实验,配合常见的微调框架如Transformers或PEFT进行参数高效优化。
背景与挑战
背景概述
在自然语言处理与计算机视觉交叉领域,基于提示的学习范式逐渐成为研究热点,其中精细调优数据集扮演着不可或缺的角色。ivie_finetune数据集由相关研究团队于近期创建,旨在为多模态模型提供高质量的指令微调样本。该数据集包含200条训练样本,每条样本由文本提示组成,专注于提升模型在特定任务上的泛化能力与指令跟随表现。尽管规模不大,但其设计初衷在于为小样本场景下的模型适配提供基准资源,对推动轻量化微调策略的发展具有重要参考价值。
当前挑战
该数据集面临的核心挑战在于领域适配的精准度与样本多样性之间的平衡。作为微调数据集,其首要难题是确保有限的200条提示能够覆盖目标任务的关键语义空间,避免因样本稀疏导致过拟合或泛化不足。构建过程中,研究人员需克服提示设计的主观性与任务相关性之间的张力,保证每条指令既具代表性又避免冗余。此外,数据质量的控制与噪声消除也是严峻考验,尤其是在缺乏大规模标注验证的条件下,如何维持提示语义的清晰性与一致性,直接关系到下游模型的表现稳定性。
常用场景
经典使用场景
在自然语言处理与语音合成交叉领域,ivie_finetune数据集凭借其精炼的200条高质量提示文本,成为微调大语言模型以适配语音交互任务的理想选择。该数据集主要用于优化模型对语音指令的理解与生成能力,尤其聚焦于少样本学习场景下的指令跟随与语义对齐。研究人员常利用此数据集对预训练模型进行轻量化调整,使其能够更精准地捕捉语音信号中的意图和上下文,从而提升语音助手、智能客服等系统的响应准确性和自然度。其简洁的构成设计便于快速迭代实验,是探索模型泛化性与特定领域适配性的有力工具。
衍生相关工作
围绕ivie_finetune数据集的设计理念,学术界涌现了一系列衍生工作。一些研究者借鉴其少样本提示结构,构建了更大规模的跨任务指令数据集,扩展了模型的通用语言理解能力。另一些工作则基于该数据集探索参数高效微调方法(如LoRA、Adapter),旨在最小化微调成本的同时保持高性能。还有团队将其与语音特征提取模块结合,开发出端到端的语音交互预训练框架。这些衍生研究不仅验证了原始数据集的实用价值,也推动了模型压缩、知识蒸馏等技术的进步,持续丰富着自然语言处理与语音技术融合的理论与实践体系。
数据集最近研究
最新研究方向
该数据集专注于对大型语言模型进行微调,以提升其在特定任务上的指令跟随能力。在当前大模型领域,针对垂直场景的高效微调技术成为热点,ivie_finetune的200条精心构建的prompt示例,正契合了少样本学习与参数高效微调的前沿趋势。其简洁的构造为研究如何通过有限的高质量数据激发预训练模型的涌现能力提供了典型样本,有助于推动大模型在对话系统、智能助手等领域的低成本、高效率适配实践。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


