aparte-titler-data
收藏资源简介:
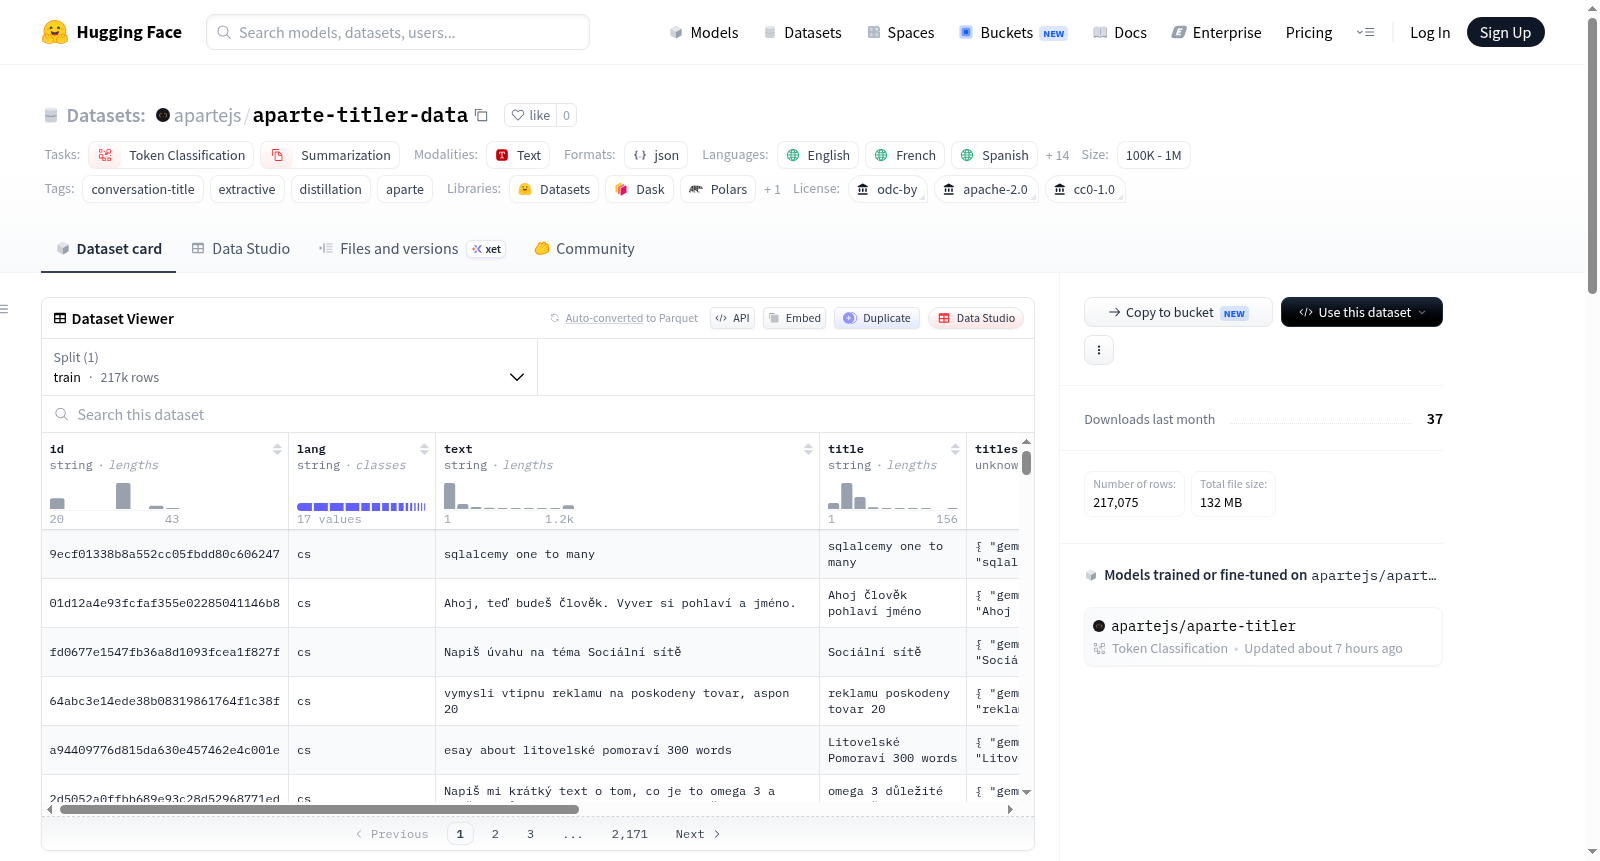
aparte-titler-data 是一个用于训练对话标题生成模型(aparte-titler)的数据集。该数据集包含来自 17 种语言的真实对话首条消息,每条消息附有一个由教师模型(gemma 4 e2b)生成的提取性标题——即从消息中直接复制的 3 到 5 个单词。数据集共约 175,000 对样本。数据以 JSONL 格式存储,每种语言一个文件,每条记录包含以下字段:id(消息在源数据集中的标识)、lang(ISO 639-1 语言代码)、text(截断至 1200 字符的消息内容)、title(教师模型生成的标题)、source(来源数据集:wildchat、oasst2、aya 或 mfaq)、site(仅 MFAQ 来源的站点信息)、kind(chat 表示由教师模型生成标题,short 表示短消息自身作为标题)、aligned(表示标题中的所有单词是否都在消息中找到对齐)。数据来源包括 WildChat-4.8M、OASST2 根提示、Aya 提示以及 MFAQ 的 FAQ 问题。标题生成过程中,约 90%–97% 的标题是完全提取性的,未能完全对齐的样本标记为 aligned: false 且未参与训练。每种语言的样本数量在 1,134 到 35,802 之间。该数据集适用于多语言对话摘要、标题生成、提取式摘要等任务。许可证方面,不同来源的数据分别遵循 ODC-BY 1.0、Apache 2.0 或 CC0 1.0,而数据集本身的贡献(选择、对齐和 aligned 标志)采用 CC BY 4.0 许可。
aparte-titler-data is a dataset for training a dialogue title generation model (aparte-titler). It contains real conversation first messages from 17 languages, each with an extractive title generated by a teacher model (gemma 4 e2b) — a 3-5 word phrase directly copied from the message. The dataset has about 175,000 pairs. Data is stored in JSONL format, one file per language, with each record containing fields: id (message identifier in source dataset), lang (ISO 639-1 language code), text (message content truncated to 1200 characters), title (title generated by teacher model), source (source dataset: wildchat, oasst2, aya, or mfaq), site (site info only for MFAQ source), kind (chat indicates teacher-generated title, short indicates short message itself as title), aligned (whether all words in title are found aligned in the message). Data sources include WildChat-4.8M, OASST2 root prompts, Aya prompts, and MFAQ FAQ questions. During title generation, about 90%–97% of titles are fully extractive; samples that are not fully aligned are marked as aligned: false and not used in training. Sample counts per language range from 1,134 to 35,802. The dataset is suitable for multilingual dialogue summarization, title generation, extractive summarization tasks. Licenses: different sources follow ODC-BY 1.0, Apache 2.0, or CC0 1.0, while the datasets contribution (selection, alignment, and aligned flag) is licensed under CC BY 4.0.
aparte-titler-data 数据集总结
数据集概述
这是一个用于训练对话标题生成模型的训练数据集,包含约175,000条真实对话的首条消息及其对应的抽取式标题(从原消息中逐字摘录3-5个词作为标题)。该数据集是 aparte-titler 模型(一个40-133KB的浏览器端对话标题生成模型)的训练数据,支持17种语言。
数据规模
- 总量:约175,000条文本-标题对
- 数据规模分类:100K < n < 1M
- 各语言数量分布(共计180,855条原始数据,部分对齐失败未被训练使用):
- 英语(en):35,802
- 法语(fr):12,783
- 西班牙语(es):13,257
- 德语(de):12,611
- 葡萄牙语(pt):12,979
- 意大利语(it):12,515
- 荷兰语(nl):12,254
- 波兰语(pl):12,357
- 瑞典语(sv):11,857
- 丹麦语(da):7,652
- 芬兰语(fi):6,857
- 捷克语(cs):5,433
- 罗马尼亚语(ro):5,762
- 挪威语(no):5,304
- 匈牙利语(hu):4,859
- 克罗地亚语(hr):1,859
- 立陶宛语(lt):1,134
数据格式
每个数据文件为 data/<语言代码>.jsonl 格式,每行一个JSON对象,包含以下字段:
| 字段 | 含义 |
|---|---|
id |
消息在来源中的ID(WildChat对话哈希、OASST2消息ID或内容哈希) |
lang |
ISO 639-1语言代码 |
text |
消息内容,截断至1,200字符 |
title |
教师模型生成的标题,词源自消息内容(短消息则标题为消息本身) |
source |
数据来源:wildchat、oasst2、aya 或 mfaq |
site |
仅MFAQ来源的行包含,表示FAQ所属网站 |
kind |
chat(由教师模型生成标题的首条消息)或 short(少于20字符的消息,自身即为标题) |
aligned |
标题中的每个词是否均能在消息中对齐;false 的行未被用于训练 |
构建方法
消息来源
- 每种语言选取12,000条首条消息(真实数据不足则减少),要求无毒性,长度20-8,000字符
- 通过MinHash去除完全重复和近似重复内容(3词分片,阈值0.8)
- 按时间均匀采样
- 各来源优先级为:
- WildChat-4.8M(英语使用WildChat-1M,且仅保留两个不同提示词一致的标题)
- OASST2(根提示词)
- Aya(提示词)
- MFAQ(每个网站最多截取100条FAQ问题)
标题生成
- 使用 gemma 4 e2b(llama.cpp,关闭思考模式)生成
- 提示词要求:主题先行,3-5个从消息中逐字摘录的词,不含请求语气词
- 90-97%的标题完全为抽取式;非抽取式的保留但标记为
aligned: false
许可与归属
数据集中每行保留其来源的许可证:
- wildchat:来源于 Ai2 的 WildChat-4.8M,适用 ODC-BY 1.0(需注明出处)
- oasst2:来源于 OpenAssistant/oasst2,适用 Apache 2.0
- aya:来源于 CohereForAI/aya_dataset,适用 Apache 2.0
- mfaq:来源于 clips/mfaq,编译部分适用 CC0 1.0;原始问题来自Common Crawl抓取的公共FAQ页面
标题由 gemma 4 e2b(Apache 2.0)生成。数据集的原创贡献部分——选择、标题对齐及 aligned 标记——以 CC BY 4.0 发布。重新分发该数据集需保留此归属声明。
附加说明
- 基准测试集(aparte-titler-gold)中的任何消息均不在此数据集中
- 每种语言的模型仅使用对应语言的数据进行训练