
links-ads/artic-dataset
收藏官方服务:
资源简介:
该数据集包含截至2026年5月27日芝加哥艺术学院的所有公共领域艺术品(元数据+图像)。数据集中的所有数据最初均以CC0或公共领域许可共享。
This dataset includes all public domain artworks (metadata+images) from the Art Institute of Chicago, as of 2026-05-27. All data included in this dataset is originally shared under CC0 or public domain.
提供机构:
links-ads搜集汇总
数据集介绍
构建方式
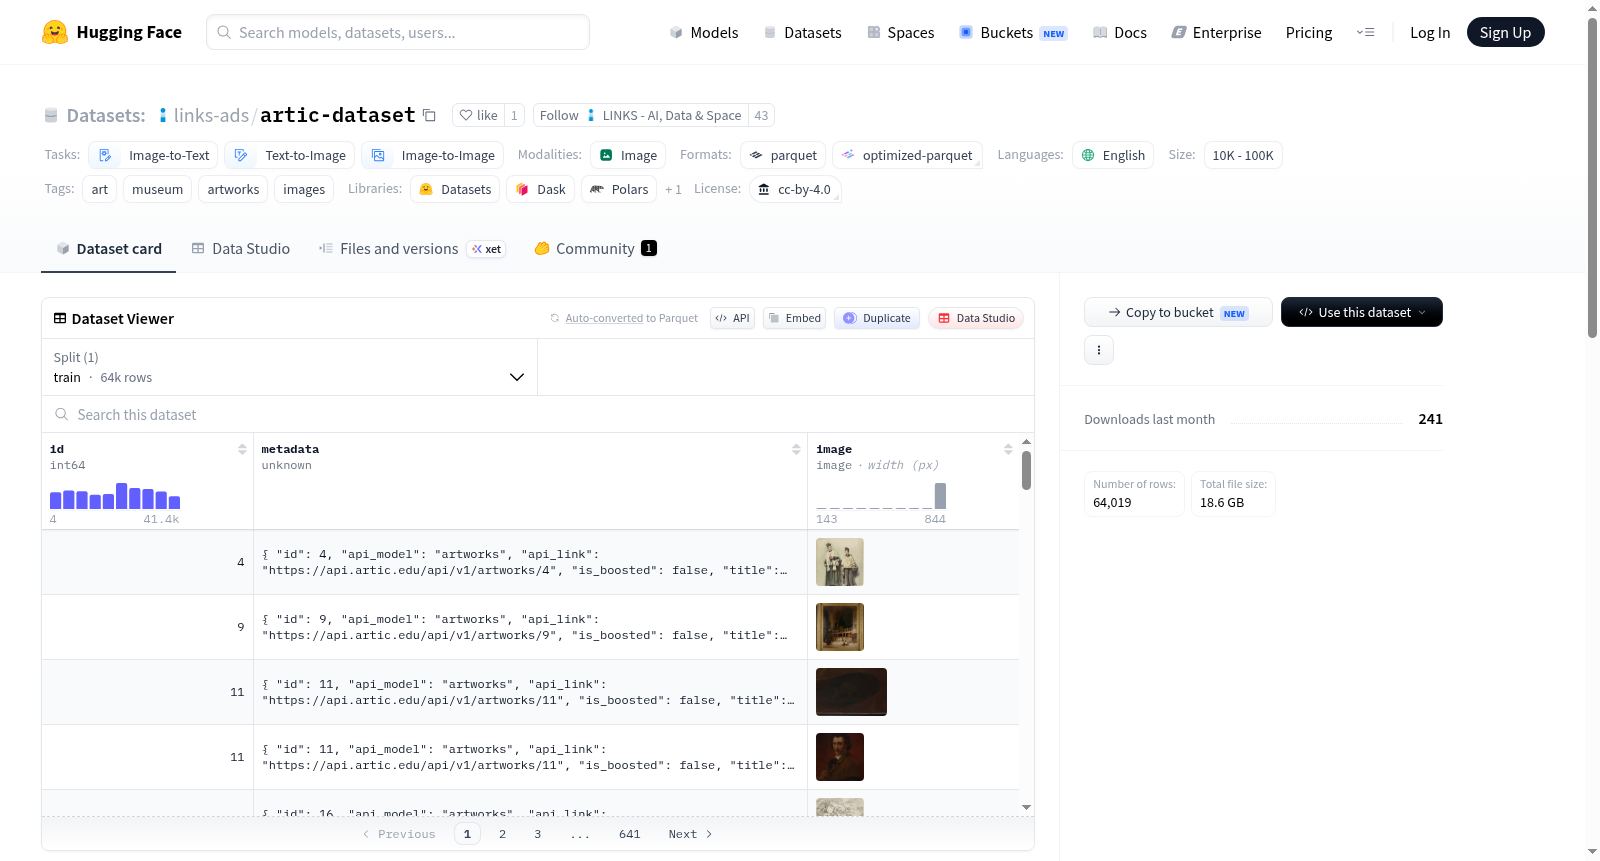
该数据集汇集了芝加哥艺术博物馆所有公有领域艺术作品的元数据与图像,数据取自博物馆官方开放获取平台。元数据来源于官方数据转储,图像则通过IIIF端点获取,选取其中宽度为843像素或原始尺寸的版本,以确保图像质量与存储效率的平衡。构建过程中仅纳入了明确标注为公有领域的作品,经过筛选与整合形成统一的数据集,并遵循CC0许可协议进行原始数据的共享。
特点
数据集共包含64,019张图像,对应57,257件艺术作品,部分作品附有多个视角的影像。每条记录由唯一标识符、结构化的元数据JSON字典以及高解析度图像构成,元数据涵盖作品名称、艺术家、创作年代等丰富信息。图像尺寸经过标准化处理,在保持宽高比的同时兼顾了视觉细节与数据规模,适用于多种视觉与多模态学习任务。
使用方法
数据集支持图像到文本、文本到图像及图像到图像等多类任务,可通过HuggingFace Datasets库便捷加载。用户可直接调用默认配置获取训练集拆分,利用'id'字段进行数据索引,解析'metadata'获取作品上下文信息,并将'image'字段作为视觉输入。建议在使用时依据CC BY 4.0许可协议进行合理引用,确保对原始数据提供者及数据整合机构的适当标注。
背景与挑战
背景概述
在数字人文与文化遗产数字化领域,大规模、高质量且开放获取的艺术品数据集是推动计算机视觉、多模态学习及艺术史研究的重要基石。Art Institute of Chicago公共领域数据集(artic-dataset)由LINKS基金会于2026年5月创建,汇聚了芝加哥艺术博物馆全部公共领域艺术品的元数据与图像,共计64019幅图像,覆盖57257件作品。该数据集以CC0许可的原始数据为基础,经系统化采集与处理,旨在为艺术图像理解、文本-图像生成与翻译等任务提供标准化资源。其发布填补了博物馆级开放艺术数据集的稀缺性,促进了跨学科研究,并成为连接文化遗产机构与人工智能社区的关键纽带。
当前挑战
该数据集所解决的核心领域问题包括:艺术图像的多模态理解(如视觉描述生成、风格迁移)与公共领域文化遗产的数字化可及性。构建过程中面临多重挑战:首先,需从博物馆官方API与IIIF端点精确筛选公共领域作品,避免版权争议,并通过元数据字段'is_public_domain'严格过滤。其次,图像采集需平衡质量与效率,依据博物馆建议对多数图像统一缩放至843像素宽度,同时保留较小原始尺寸,确保一致性与保真度。此外,元数据与图像的异构性(如部分作品关联多幅图像)要求设计健壮的数据结构,以JSON格式存储丰富属性并保证ID唯一性。最后,数据集的维护需持续应对博物馆数据更新的动态性,并提供反馈机制以修正潜在的授权问题。
常用场景
经典使用场景
在艺术史与计算机视觉交叉研究领域,artific-dataset为多模态学习任务提供了高质量的图像-文本配对资源。研究者常将其用于训练和评估艺术品图像描述生成、风格迁移以及跨模态检索模型,其丰富的元数据(如创作年代、流派、材质)可辅助构建细粒度艺术知识图谱。
实际应用
在实际落地中,该数据集被广泛用于博物馆智能导览系统的开发、艺术教育平台的教学素材库构建,以及商品化艺术品推荐算法的训练。其遵循CC BY许可的特性,也使其成为创意工作者进行二次创作、NFT艺术品生成等商业场景的理想数据源。
衍生相关工作
基于该数据集衍生了多项开创性工作,例如利用对比学习框架实现的艺术品跨时空关联分析、融合时空上下文的艺术品年代鉴定模型,以及结合扩散模型的艺术风格迁移方法。部分工作进一步扩展了元数据中的材质与技法标签,推动了数字化艺术修复技术的发展。
以上内容由遇见数据集搜集并总结生成


