
遇见数据集

PreTrain-HOI4-Modding-Assistant

收藏
Hugging Face2026-07-22 更新2026-07-23 收录
官方服务:

资源简介:

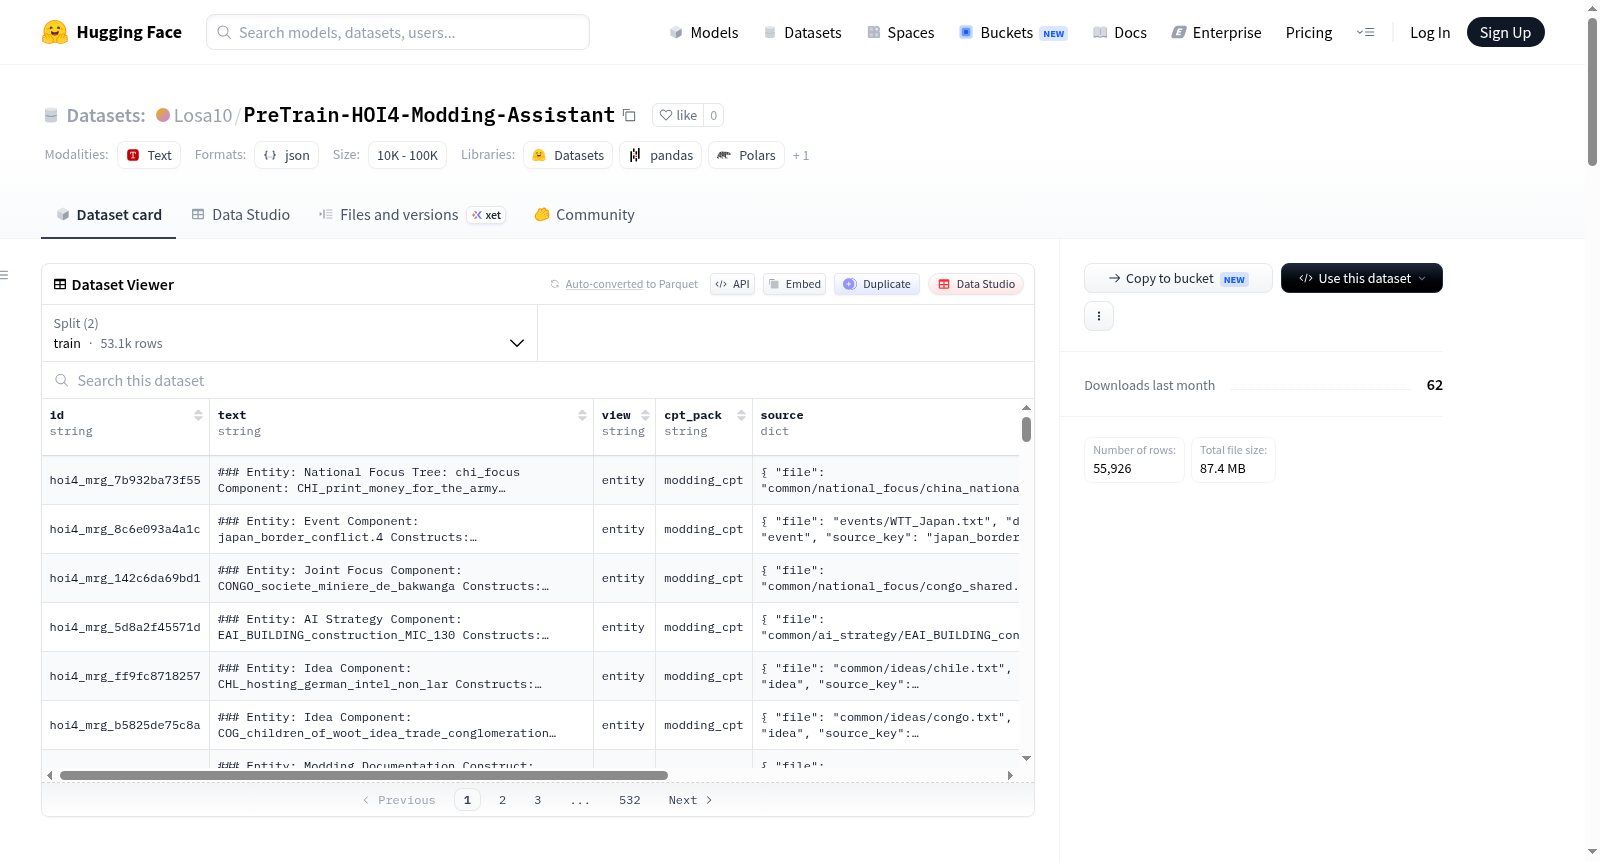
HOI4 CPT数据集是一个专为《钢铁雄心4》(HOI4)游戏Clausewitz引擎设计的持续预训练(CPT)协同语料库。该数据集旨在通过整合互补的实体模式数据、模组化CPT数据(通过‘Construct:’头部实现游戏脚本、文档与维基页面之间的交叉链接)以及采用优先级策略的小模型包,为游戏相关的大语言模型预训练提供高质量文本资源。数据集总计包含55,926个文档,划分为53,130个训练样本和2,796个验证样本,数据格式为JSONL。数据主要来源于两个处理包:modding_cpt包(输入58,833,保留55,562)提供了实体数据以及带有交叉链接的文档/维基内容;entity包(输入1,078,605,保留364)则提供了完整的按实体转储的数据。数据集按文档类型(doc_type)详细分类,涵盖‘焦点’、‘理念’、‘事件’、‘角色’、‘AI策略’、‘脚本效果’、‘国家历史’、‘维基’、‘文档’、‘科技’等40种不同的游戏内容与配置类型。每个数据样本包含以下核心字段:唯一稳定的合并文档ID(id)、干净的CPT训练文本内容(text)、数据表示视图(view)、获胜的协同包来源标识(cpt_pack)、来源元信息(source,包括文件路径、文档类型、源键、DLC、游戏版本)、语言标签(language)以及丰富的元数据(meta,包含字符数、词数、多种分词器的令牌数、哈希值、提取器信息等统计与标识信息)。数据集采用‘priority’合并策略,明确排除了‘本地化’类型数据,训练文本保持干净无前缀。该数据集主要用于游戏领域大语言模型的持续预训练、游戏内容理解、模组开发辅助以及游戏AI策略研究等相关任务。

创建时间:
2026-07-15
原始信息汇总

HOI4 CPT Dataset 数据集概述

该数据集是一个为《钢铁雄心4》(Hearts of Iron IV)游戏模组开发而构建的续预训练(Continued Pre-training)语料库,融合了实体模式、模组代码(脚本↔文档↔wiki)以及小型模型包。

基本信息

  • 数据集名称:HOI4 CPT
  • 许可协议:MIT
  • 总文档数:55,926 条
  • 数据格式:JSONL
  • 合并策略priority(优先级:modding_cpt > entity
  • 排除类型localization

数据集划分

划分 样本数
train 53,130
validation 2,796

数据特征

字段 描述
id 稳定的合并文档标识符
text CPT 负载(实体微上下文 + Code:/Doc:)
view 表示视图(重组后为 entity
cpt_pack 该文档所属的协同包
source 包含 filedoc_typesource_keydlcgame_version
language 语言标签(如 encode
meta 包含字符数、词数、token 统计、cpt_pack 等元信息

源包构成

包名 输入数量 保留数量 角色
modding_cpt 58,833 55,562 实体 + 文档/wiki + Construct 交叉链接
entity 1,078,605 364 全实体转储(可能包含本地化内容)

文档类型分布(部分)

类型 文档数
focus 13,096
idea 8,113
event 7,514
character 6,660
ai_strategy 2,992
oob 1,982
scripted_effect 1,885
decision 1,338
wiki 779
documentation 573

完整类型共包含 40 个类别,涵盖游戏脚本、文档、wiki、GUI 配置等多种内容类型。

数据加载

使用 Hugging Face datasets 库加载:

python from datasets import load_dataset

从 Hub 加载

ds = load_dataset("hoi4-cpt-synergy")

从本地文件加载

ds = load_dataset("json", data_files={ "train": "data/train-.jsonl", "validation": "data/validation-.jsonl", })

引用信息

@misc{hoi4_cpt, title = {HOI4 CPT Dataset}, year = {2026}, note = {Merged entity + modding-cpt + small-model packs for Clausewitz CPT}, }
搜集汇总
数据集介绍
PreTrain-HOI4-Modding-Assistant 数据集图片
构建方式
PreTrain-HOI4-Modding-Assistant数据集专为《Hearts of Iron IV》游戏模组开发场景构建,其语料库融合了多源异构数据,包含实体模式脚本、官方文档及Wiki页面,并通过Construct工具以headers为桥梁实现跨域对齐。数据集采用优先级合并策略,优先保留模组CPT数据,其次摄取实体转储,最终形成55,926篇结构化文档,其中训练集53,130篇,验证集2,796篇。所有文本均经过去噪处理,剔除本地化内容,保留完整的游戏版本、DLC归属及来源追踪元信息。
特点
该数据集的核心特色在于其精巧的协同架构:通过'cpt_pack'字段标注每个样本的来源包,并依据'priority'策略消除冗余,确保实体与模组信息互补共生。文档类型覆盖超过40种游戏对象,从国家焦点、国策树到脚本触发器与Wiki文档,全面表征Clausewitz引擎的语义网络。每条记录附带丰富的元数据,包括字符/词数、token统计、重复行比例及AST哈希值,便于下游模型进行数据质量筛选与内容去重。
使用方法
用户可通过HuggingFace的datasets库便捷地加载该数据集,直接调用load_dataset('hoi4-cpt-synergy')即可获取整个语料库。若需本地使用,也可指定JSONL文件路径,通过'data/train-*.jsonl'与'data/validation-*.jsonl'分片模式加载训练集与验证集。数据集以'jsonl'格式存储,每个样本包含纯净的文本内容与结构化元数据,适合用于语言模型的持续预训练、游戏脚本代码生成或模组文档自动补全等下游任务。
背景与挑战
背景概述
《Hearts of Iron IV》(HOI4)作为一款深度模拟二战历史的策略游戏,其丰富的游戏机制与庞大的模组生态催生了大量复杂的脚本代码与文档资料。然而,现有自然语言处理模型难以有效理解这类混合了游戏逻辑、文档描述与社区知识的专业语料。在此背景下,PreTrain-HOI4-Modding-Assistant数据集于2026年由HOI4模组社区与研究人员联合构建,旨在为Clausewitz引擎脚本语言提供持续预训练语料。该数据集整合了超过5.5万条来自游戏实体、开发文档及官方Wiki的语料,采用优先级合并策略,覆盖39种文档类型,显著提升了跨模态语料在游戏AI与模组开发中的可用性。其发布为策略游戏领域的神经网络预训练研究提供了领域特定的基准资源,推动了游戏自动化与智能辅助工具的发展。
当前挑战
该数据集构建面临双重挑战。在领域问题层面,现有通用语言模型在处理HOI4特有的Clausewitz脚本语法与游戏逻辑时表现不佳,缺乏对实体、事件、AI策略等复合语义的深度理解,难以支撑模组自动生成、Bug预测及代码补全等应用需求。在数据构建过程中,原始语料来源分散且格式各异,包括游戏脚本、非结构化文档与Wiki页面,需实现跨源去重与格式标准化;同时,大量本地化文本与低质量冗余条目需被过滤,实体模式与模组代码之间微妙的语义关联需通过构造性跨链接(Construct: headers)进行对齐,且整个合并流程需在保持训练文本纯净的前提下保留溯源信息,对数据处理管道提出了巨大挑战。
常用场景
经典使用场景
在游戏人工智能与自然语言处理交叉领域,PreTrain-HOI4-Modding-Assistant数据集作为《钢铁雄心IV》(Hearts of Iron IV)模组开发的持续预训练语料库,其经典使用场景聚焦于对Clausewitz引擎脚本语言、游戏维基文档及模组开发手册的深度语义建模。该数据集通过融合实体模式(entity-mode)与模组代码-文档-维基三元组(modding-cpt)的协同语料,构建了涵盖53,130条训练样本与2,796条验证样本的高质量注释集,每条记录均保留纯净文本及来源元数据(包括DLC归属、游戏版本及文件类型)。研究者可借助其丰富的文档类型(涵盖focus、event、character等40余种细分类别)开展多任务学习,例如从完整实体的上下文片段中学习脚本逻辑与自然语言描述的映射关系,为后续游戏内智能助手或自动化模组补全工具奠定数据基础。
解决学术问题
该数据集系统性地解决了游戏领域知识驱动型NLP研究中长期存在的两大瓶颈:一是缺乏大规模、多模态且经专业标注的Clausewitz脚本语言语料库,二是难以将非结构化的游戏维基与结构化的代码文档进行语义对齐。通过引入优先级合并策略(priority merge),数据集有效过滤了重复与冗余内容,并利用Construct机制实现了脚本、文档与维基三者在头部信息(headers)层面的交叉链接,从而为跨模态语义理解提供了标准化基准。这一框架促使学术界能够深入探索代码理解(code comprehension)、文档生成(document generation)及知识图谱构建等重要议题,尤其推动了对于特定领域编程语言(DSL)的持续预训练(continued pre-training)方法论创新,其影响延伸至程序合成(program synthesis)与低资源语言建模领域。
衍生相关工作
该数据集衍生出若干开创性工作,主要集中在领域特异性持续预训练与多源语料融合策略方面。基于其priority合并机制的启发,研究者提出了针对不同任务类型(如代码生成与文档摘要)的动态语料加权方法,有效提升了预训练模型在Clausewitz脚本上的零样本推理能力。在模型架构层面,利用该数据集训练的small-model pack为资源受限的模组开发场景提供了紧凑而高效的语言表示,推动了知识蒸馏与模型剪枝技术在游戏NLP领域的应用。此外,其交叉链接的Construct策略被应用于构建跨文档语义对齐的基准测试(benchmark),激励了后续关于游戏领域多模态翻译(如脚本→自然语言)与结构化知识提取的学术探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

