
StevenChen16/Stock-China-daily
收藏原始信息汇总
数据集概述
许可证信息
- 许可证类型:MIT License
搜集汇总
数据集介绍
构建方式
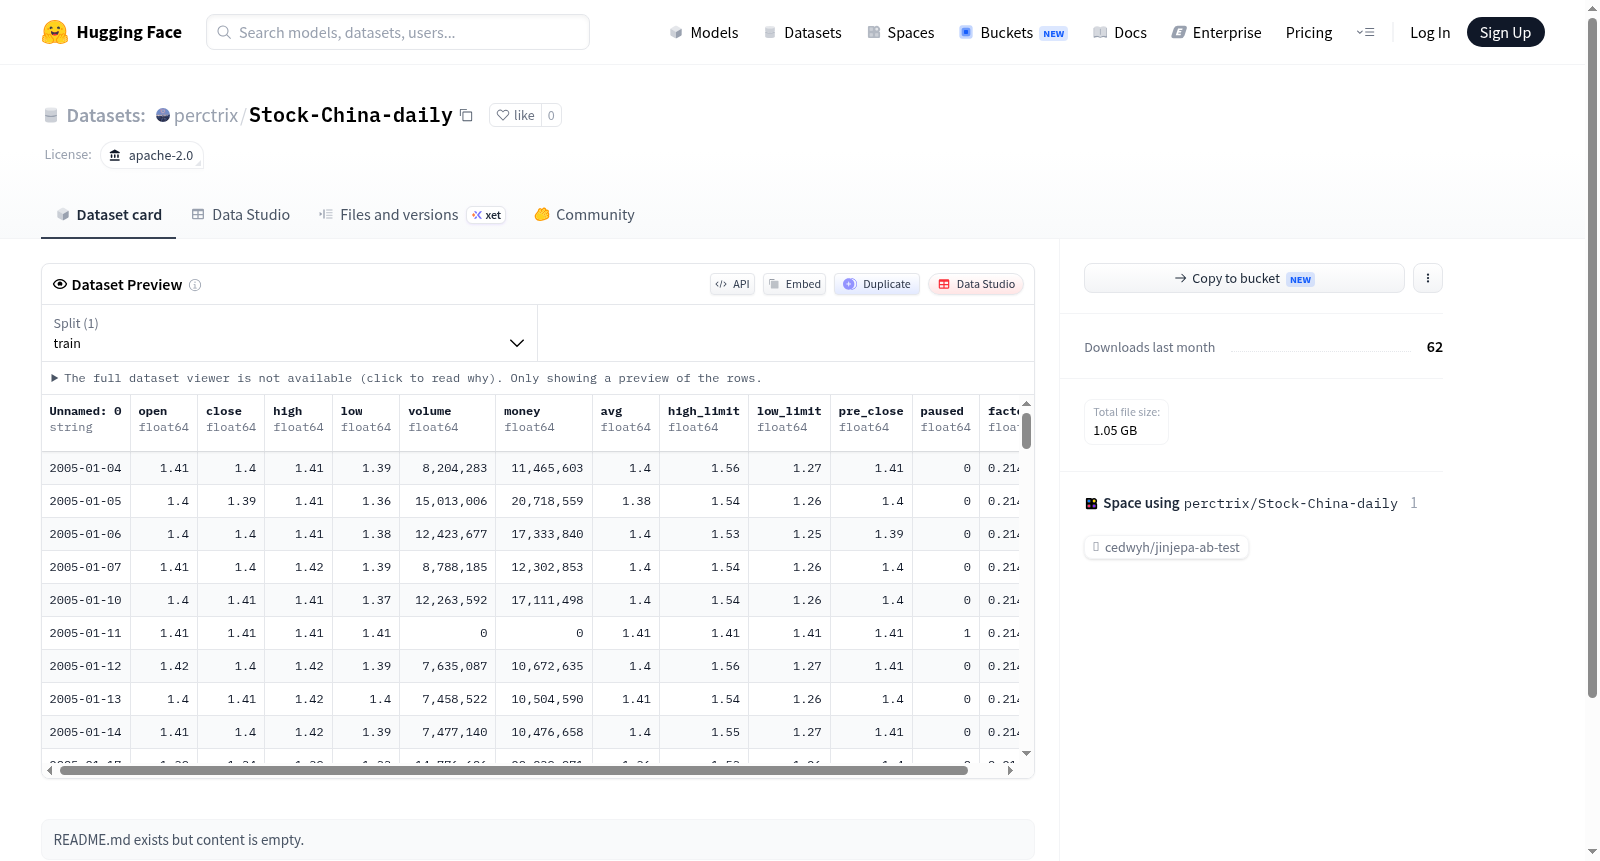
在金融数据挖掘与量化分析领域,高质量的历史行情数据是研究的基础。Stock-China-daily数据集聚焦于中国A股市场,系统性地收集并整理每日交易记录。其构建过程严格遵循数据清洗与标准化流程,从多个权威金融数据源提取开盘价、收盘价、最高价、最低价及成交量等核心指标,并确保时间序列的连续性与完整性,最终形成结构化的日线数据表。
使用方法
使用该数据集时,用户可直接通过HuggingFace Datasets库加载,无需繁琐的本地文件管理。加载后,数据以Pandas DataFrame格式呈现,便于利用Python生态中的Pandas、NumPy进行数据清洗与特征工程。典型应用场景包括构建股票价格预测模型、计算技术指标如移动平均线,或作为强化学习交易策略的环境状态输入,实现从数据加载到模型训练的无缝衔接。
背景与挑战
背景概述
在中国资本市场日益壮大的背景下,量化投资与金融数据分析成为学术界与工业界共同关注的焦点。StevenChen16/Stock-China-daily数据集由研究人员Steven Chen于近年创建,致力于提供中国A股市场的日频交易数据,覆盖股票价格、成交量、涨跌幅等关键指标。该数据集的核心研究问题在于为金融时间序列预测、市场微观结构分析及资产定价模型提供标准化、易获取的数据基础。其影响力体现在降低了中国股市数据获取的门槛,推动了基于深度学习的股票走势预测与风险管理的本地化实证研究。
当前挑战
该数据集面临的核心挑战包括:一是中国A股市场存在涨跌停板、T+1交易等独特制度,导致数据分布具有非平稳性与极端值聚集现象,传统时序模型难以直接适用。二是数据构建过程中需处理停牌、除权除息、财报披露等事件带来的缺失值与异常值,清洗规则的设计需兼顾金融逻辑与统计稳健性。三是不同交易所(沪深北)的数据格式与更新频率存在差异,跨市场数据对齐增加了数据融合的复杂性。
常用场景
经典使用场景
在中国资本市场日益成熟的背景下,StevenChen16/Stock-China-daily数据集为金融时间序列分析提供了每日维度的中国股市历史交易数据。其最经典的使用场景是作为股票价格预测模型的训练基础,研究者可基于该数据集构建长短期记忆网络或Transformer架构,捕捉股价波动的日间规律,并验证技术分析指标的有效性。
解决学术问题
该数据集有效解决了中国股市研究中高频数据获取门槛高、历史数据碎片化的学术难题,为量化金融领域的因果推断和统计套利研究提供了标准化的每日行情基准。它支撑了市场微观结构分析、波动率建模以及事件驱动策略的回溯验证,推动了针对中国A股市场异象的实证研究,深化了对新兴市场价值投资理论的认知。
实际应用
在实际应用中,该数据集被广泛用于智能投顾系统的开发,支持个人与机构投资者进行风险预警和资产配置优化。基于其历史行情,券商和金融科技公司能够训练算法生成买卖信号,构建自动化的交易策略。此外,它也为金融监管机构提供了市场异常波动检测的数据基础,助力防范系统性金融风险。
数据集最近研究
最新研究方向
在当前量化金融与人工智能深度融合的背景下,中国股市日频数据集StevenChen16/Stock-China-daily的发布为金融时间序列分析提供了宝贵的基础资源。该数据集聚焦于中国A股市场的日度交易数据,覆盖了价格、成交量等核心指标,为研究者探索市场微观结构、波动率建模以及因子挖掘等前沿方向奠定了数据基础。伴随着大语言模型与强化学习在投资决策中的兴起,此类结构化市场数据正被广泛用于训练预测模型,尤其是在高频交易策略回测与风险控制领域。该数据集的Apache-2.0许可协议进一步降低了学术与工业界的应用门槛,促进了中国股市量化研究的可复现性与国际化交流,对于理解新兴市场的价格形成机制与投资者行为具有深远意义。
以上内容由遇见数据集搜集并总结生成


