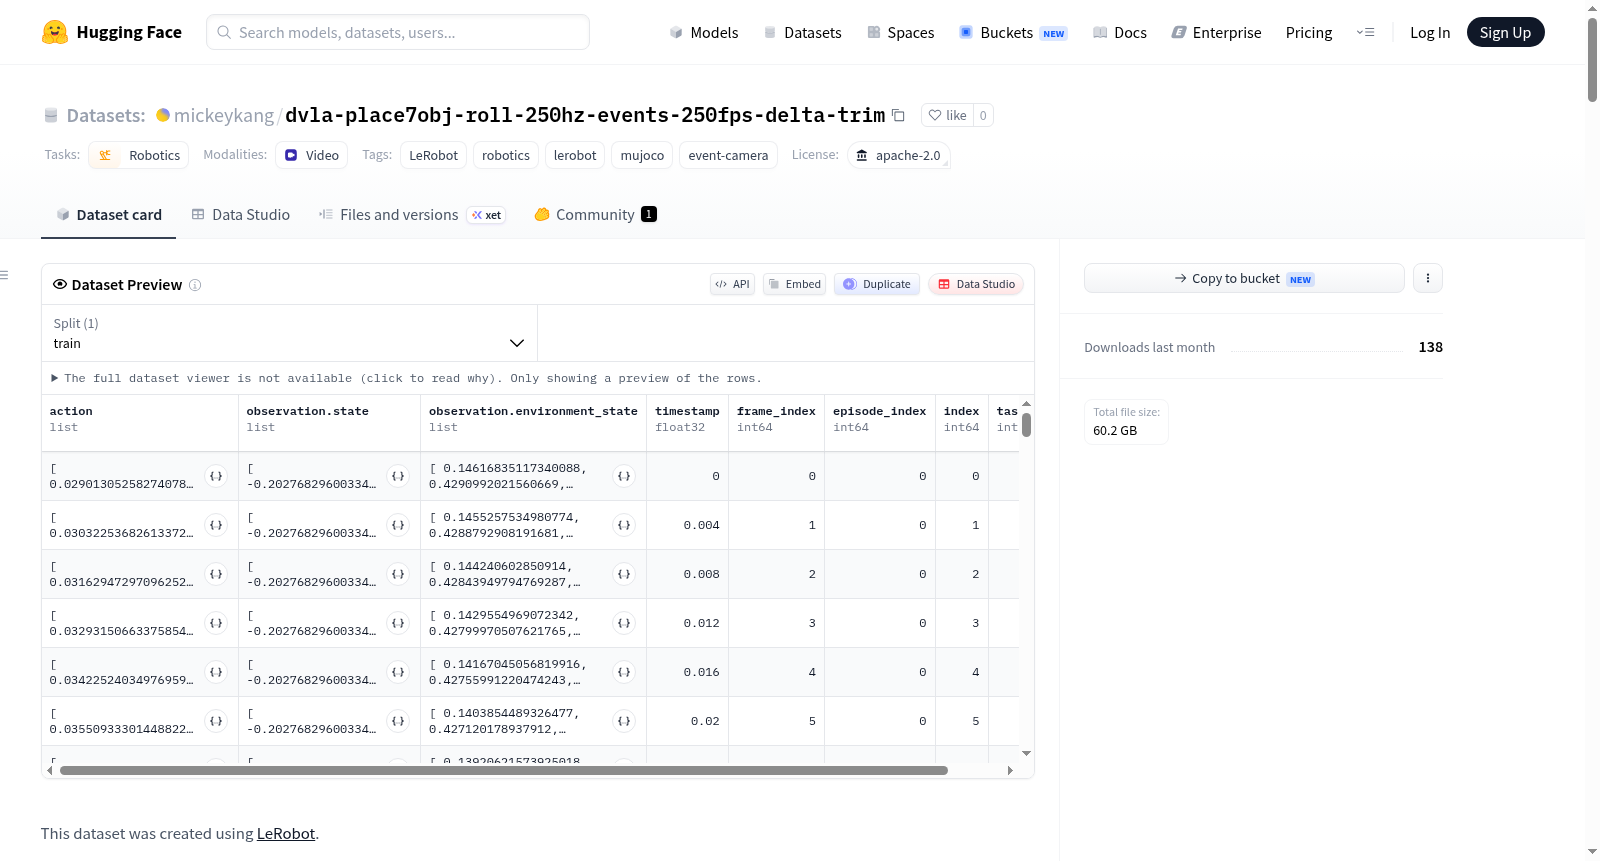
dvla-place7obj-roll-250hz-events-250fps-delta-trim
收藏资源简介:
该数据集是一个用于机器人操作仿真的多模态数据集,基于MuJoCo/robosuite仿真环境,由Panda机械臂执行“放置”任务。数据集包含14,083个成功演示,机械臂从桌子上拾取物体并放入容器(碗/盘子/托盘)中,涉及7种物体:5种杂货物品(罐头、苹果、牛油果、土豆、柠檬)和2种圆润纹理物体(网球、棒球)。其中80%的演示以物体滚动(发射速度0.25-1.5 m/s)开始,其余为静态初始状态。演示由脚本化的状态机生成,仅保留成功尝试。数据以LeRobot v2.1格式存储,机器人类型为panda,配备3个RGB相机和3个DVS事件相机,分辨率均为360x480(6个视频流:wrist_cam、side_cam、opst_cam及其对应的事件相机流)。训练通常仅使用opst_cam和wrist_cam。动作空间action为10维,包括末端执行器位置增量、欧拉角的正弦/余弦表示和夹爪控制;观察空间observation.state为9维,包含末端执行器位置和欧拉角的正弦/余弦;observation.environment_state为9维,包含特权物体位姿/速度(训练时丢弃)。action是增量形式,编码为绝对目标减去同一帧的状态,评估时解码为当前状态加上预测增量,并逐帧重锚定。绝对目标采用未来末端执行器重标定(future-EE relabel),即机械臂实际到达的位姿(延迟320ms,80帧)。控制频率250Hz,事件相机数据通过v2e生成,并经过delta-trim预处理(正弦/余弦到增量,前置保持修剪)。数据集总帧数11,561,473,总视频数84,498,总块数15,每个块大小1000。适用于机器人操作中的模仿学习、事件相机数据处理、视觉运动控制等研究。
This dataset is a multimodal dataset for robot manipulation simulation, based on the MuJoCo/robosuite simulation environment, with a Panda robot arm performing a placing task. It contains 14,083 successful demonstrations where the robot picks up objects from a table and places them into containers (bowl/plate/tray), involving 7 objects: 5 grocery items (can, apple, avocado, potato, lemon) and 2 round textured objects (tennis ball, baseball). 80% of demonstrations start with object rolling (launch speed 0.25-1.5 m/s), while the rest are static initial states. Demonstrations are generated by a scripted state machine, retaining only successful attempts. Data is stored in LeRobot v2.1 format, robot type is panda, equipped with 3 RGB cameras and 3 DVS event cameras, all with resolution 360x480 (6 video streams: wrist_cam, side_cam, opst_cam and their corresponding event camera streams). Training typically uses only opst_cam and wrist_cam. The action space is 10-dimensional, including end-effector position deltas, sine/cosine of Euler angles, and gripper control. The observation.state is 9-dimensional, containing end-effector position and sine/cosine of Euler angles. observation.environment_state is 9-dimensional, containing privileged object pose/velocity (discarded during training). Actions are incremental, encoded as absolute target minus state at the same frame, decoded as current state plus predicted increment during evaluation, with per-frame re-anchoring. Absolute targets use future-EE relabel, i.e., the actual pose reached by the robot arm (delayed by 320ms, 80 frames). Control frequency is 250Hz. Event camera data is generated via v2e and preprocessed with delta-trim (sine/cosine to increments, hold-before trimming). The dataset has a total of 11,561,473 frames, 84,498 videos, 15 chunks, each chunk size 1000. Suitable for research on imitation learning in robot manipulation, event camera data processing, and visual motor control.
数据集概述:dvla-place7obj-roll-250hz-events-250fps-delta-trim
数据集简介
该数据集包含 14,083 条成功的演示轨迹,记录了一只 Panda 机械臂从桌子上抓取物体并放入容器(碗/盘子/托盘)的操作过程。数据基于 MuJoCo/robosuite 仿真环境生成,控制频率为 250 Hz,同时包含事件相机和 RGB 相机数据。
任务与物体
- 任务类型:7 物体放置(place)任务
- 物体类别:
- 5 种杂货物品(10,083 条轨迹):罐子、苹果、牛油果、土豆、柠檬
- 2 种圆形纹理物体(4,000 条轨迹):网球、棒球
- 初始状态:80% 的轨迹以物体滚动开始(发射速度 0.25-1.5 m/s),其余为静止状态
- 数据来源:由读取特权仿真器状态的脚本化状态机生成,仅保留成功的尝试
数据布局与特征
数据格式:LeRobot v2.1,robot_type: panda
相机配置
6 个摄像头(360x480 分辨率):
- 3 个 RGB 相机:
wrist_cam、side_cam、opst_cam - 3 个 DVS 事件相机:
wrist_cam_events、side_cam_events、opst_cam_events - 训练通常仅使用
opst_cam和wrist_cam
特征说明
| 特征 | 维度 | 内容 |
|---|---|---|
action |
10 | 末端执行器位置增量(dx, dy, dz)、3 个欧拉角的 sin/cos 值、夹爪状态 |
observation.state |
9 | 末端执行器位置、3 个欧拉角的 sin/cos 值 |
observation.environment_state |
9 | 特权物体位姿/速度(训练时不使用) |
| 图像特征 | — | 6 个视频流(250 fps,h264 编码) |
动作编码
- 动作为增量形式:绝对目标位置减去当前帧状态
- 评估时解码为:
目标 = 实时状态 + 预测增量,每步重新锚定 - 绝对目标编码的是未来末端执行器重标注:机械臂在 320 ms(80 帧 @ 250 Hz)后实际到达的位姿
数据集统计
- 总轨迹数:14,083
- 总帧数:11,561,473
- 总任务数:105
- 总视频数:84,498
- 数据分块:15 块,每块 1,000 条轨迹
- 训练/测试划分:全部 14,083 条用于训练
数据预处理
采用 delta-trim 预处理流程:
- sincos 转换
- 计算增量(delta)
- 前导保持裁剪(leading-hold trim)
事件数据使用 v2e 工具生成。
附加信息
- 许可证:Apache-2.0
- 主页:DynamicVLA GitHub 仓库
- 相关数据集:此数据集是
dvla-place5obj-roll-250hz-events-250fps-delta-trim(10,083 条)和新增place2obj数据集(4,000 条)的并集