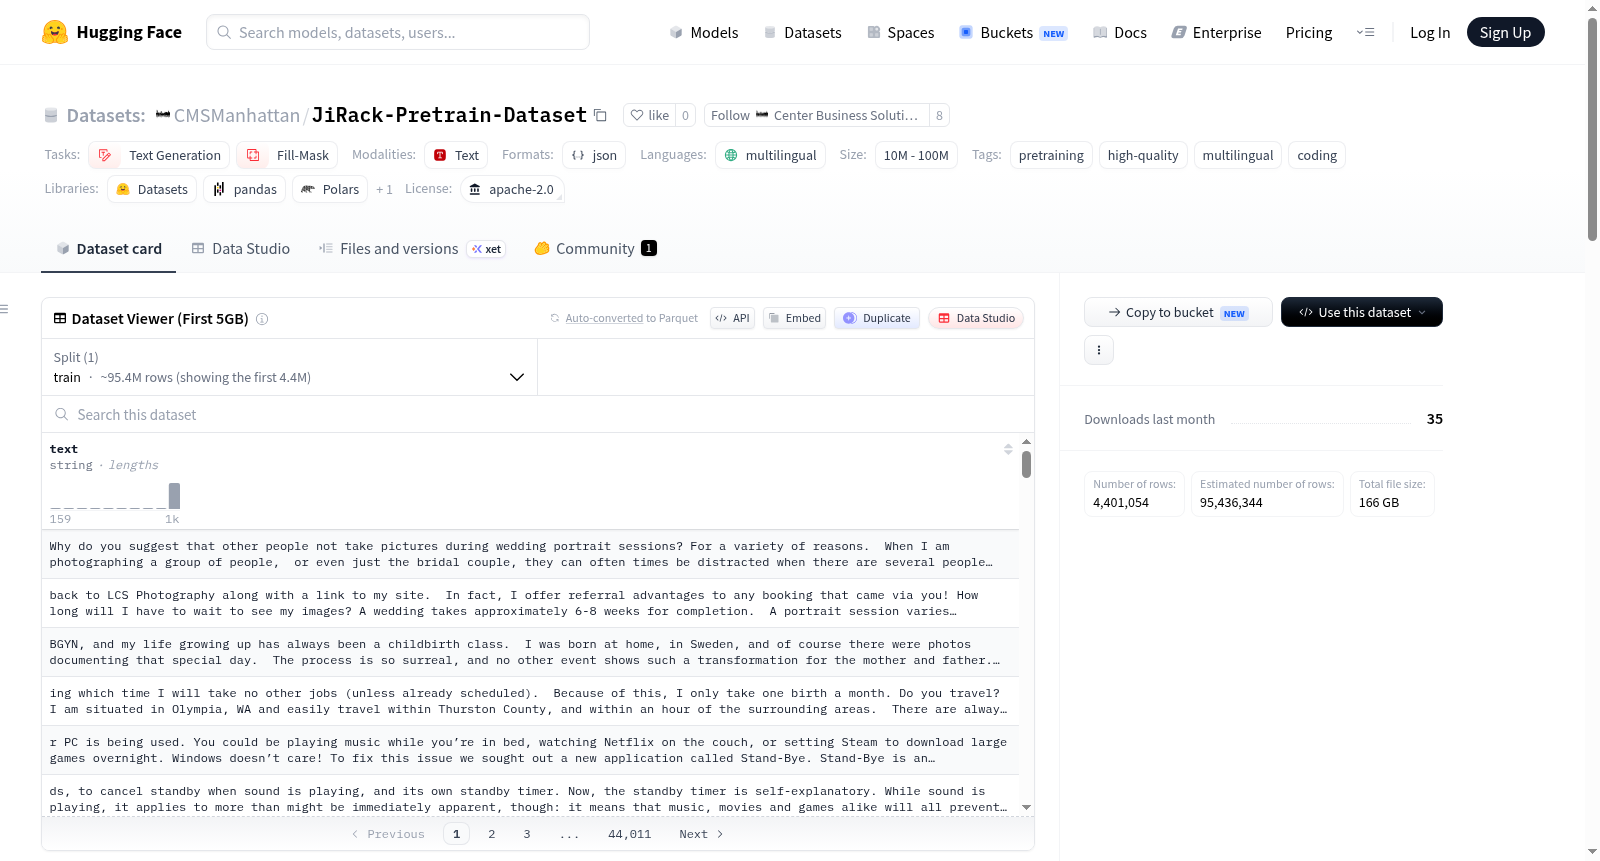
JiRack-Pretrain-Dataset
收藏资源简介:
Multi-Domain High-Quality Corpus(多领域高质量语料库)是一个精心策划的高质量多语言数据集,主要用于预训练JiRack模型。该数据集的创建背景聚焦于企业AI应用,旨在帮助银行、金融科技公司及其他企业保护敏感数据,并确保符合美国严格的隐私法规,从而避免使用受限制的公共在线或云端AI服务。数据集内容涵盖多个领域,具体包括:FineWeb-Edu、DCML、所有语言的维基百科、大型世界文学语料库、政府报告以及NexCoder Conversational对话数据。其核心目的是构建一个强大的基础模型,使其在编程代码生成、复杂推理以及多语言理解方面具备卓越能力。数据集规模庞大,适用于文本生成和掩码填充等预训练任务,并特别针对高质量、多语言和编码相关场景进行了优化。数据集采用Apache-2.0许可证,并配套有专门优化的分词器(如JiRack-Pro-Tokenizer和JiRack-Router-Tokenizer)以及一系列用于监督微调(SFT)的高质量下游数据集,这些SFT数据集需格式化为ChatML格式以充分发挥效能。整个数据集生态旨在通过SFT+DPO等技术,高效训练出高性能的企业级模型(如JiRackTernary系列)。
The Multi-Domain High-Quality Corpus is a meticulously curated high-quality multilingual dataset primarily used for pre-training the JiRack model. Its creation background focuses on enterprise AI applications, aiming to help banks, fintech companies, and other businesses protect sensitive data and ensure compliance with strict U.S. privacy regulations, thereby avoiding the use of restricted public online or cloud-based AI services. The dataset content spans multiple domains, specifically including: FineWeb-Edu, DCML, Wikipedia in all languages, a large world literature corpus, government reports, and NexCoder Conversational dialogue data. Its core purpose is to build a robust foundational model with exceptional capabilities in programming code generation, complex reasoning, and multilingual understanding. The dataset is large-scale and suitable for pre-training tasks such as text generation and masked filling, optimized specifically for high-quality, multilingual, and coding-related scenarios. It is licensed under Apache-2.0 and comes with specially optimized tokenizers (e.g., JiRack-Pro-Tokenizer and JiRack-Router-Tokenizer) and a series of high-quality downstream datasets for supervised fine-tuning (SFT), which need to be formatted in ChatML format for optimal performance. The entire dataset ecosystem aims to efficiently train high-performance enterprise-level models (such as the JiRackTernary series) through techniques like SFT+DPO.
数据集概述
数据集名称:Multi-Domain High-Quality Corpus(JiRack 预训练数据集)
数据集地址:https://huggingface.co/datasets/CMSManhattan/JiRack-Pretrain-Dataset
许可证:Apache-2.0
语言:多语言(multilingual)
任务类别:文本生成(text-generation)、掩码填充(fill-mask)
数据集规模:巨大(huge)
标签:预训练、高质量、多语言、编程
主要用途
- 用于预训练 JiRack 模型,提供现代高质量的多领域、多语言数据。
- 专为企业级 AI(如银行、金融科技公司)设计,帮助保护敏感数据并遵守美国隐私法律,避免使用公共在线和云端 AI 服务。
数据集构成
该数据集由以下子集组成:
- FineWeb-Edu
- DCML
- Wikipedia(所有语言)
- 世界文学大语料库
- 政府报告
- NexCoder 对话数据
构建目标
- 创建具备强大编程、推理和多语言理解能力的稳健基础模型。
相关资源
-
分词器(Tokenizers):
-
模型:
-
开源 SFT 数据集系列(需转换为 ChatML 格式):
-
完整数据集集合:kgrabko Datasets on Hugging Face