CSC-gpt4
收藏资源简介:
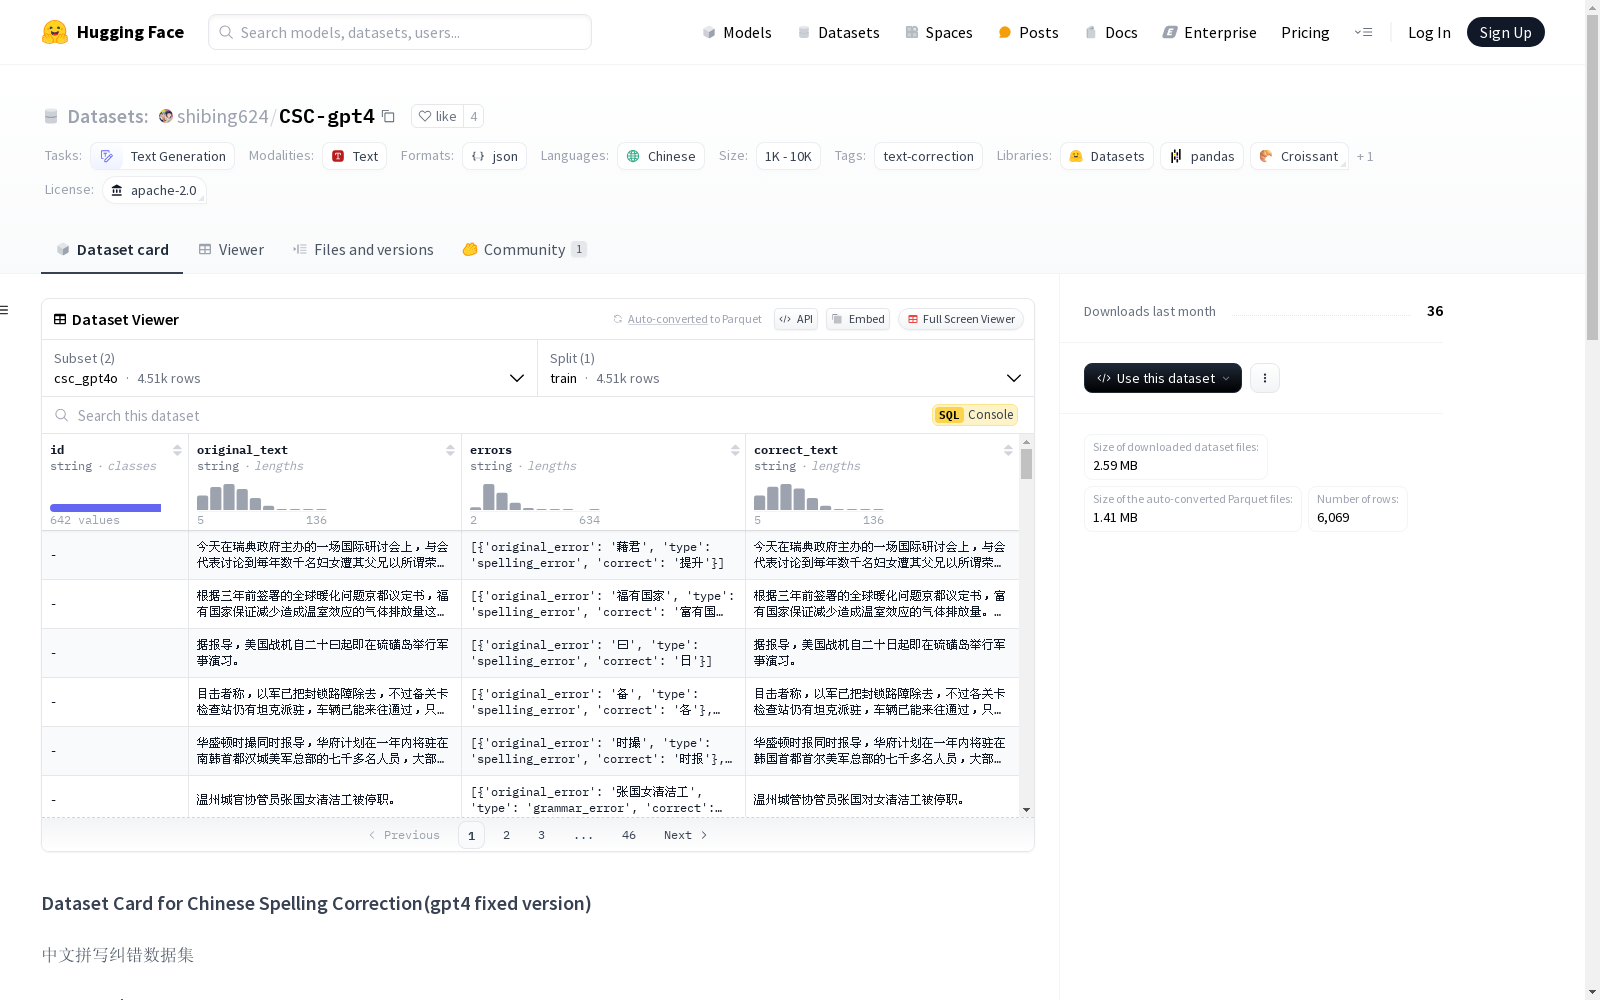
中文拼写纠错数据集,共6千条,整合了原始SIGHAN13、14、15年数据集和Wang271k数据集的拼写纠错数据集(抽样得到了4.5k),和语法纠错样本集(抽样了1.5k),使用gpt4的api逐条生成得到,jsonl格式,带错误字符信息。
Chinese Spelling Error Correction Dataset contains a total of 6,000 entries. It includes 4.5k sampled spelling error correction samples sourced from the original SIGHAN 2013, 2014, 2015 datasets and the Wang271k dataset, plus 1.5k sampled grammar error correction entries. All samples were generated one by one using the GPT-4 API. The dataset is stored in JSON Lines format and includes error character information.
中文拼写纠错数据集(gpt4修正版)
数据集描述
中文拼写纠错数据集(CSC)是一个用于检测和纠正中文文本中拼写错误的任务。由于许多中文字符在视觉或语音上相似但具有完全不同的语义,因此这一任务具有挑战性。
该数据集共包含6千条数据,整合了原始SIGHAN13、14、15年数据集和Wang271k数据集的拼写纠错数据(抽样得到4.5k条),以及语法纠错样本集(抽样得到1.5k条)。这些数据是通过gpt4的API逐条生成得到的,格式为jsonl,并包含错误字符信息。
数据文件
- csc_gpt4o.jsonl:从CSC数据集抽样得到,包括SIGHAN13、14、15和Wang271k数据,文件大小为2MB,包含4.5千条数据。
- grammar_gpt4o.jsonl:从pycorrector/grammar数据集抽样得到,包括语法纠错数据,文件大小为577KB,包含1.5k条数据。
数据格式
数据样例:
json { "id": "-", "original_text": "可是在从原棉制成纱线的过程,就不像穿着光滑舒适的衣服那样让人愉快了:纱厂工人终日面临着音响,尘埃和湿气的。", "errors": [{original_error: 音响, type: wrong_word, correct: 噪音}, {original_error: 的, type: extra_word, correct: }], "correct_text": "可是在从原棉制成纱线的过程,就不像穿着光滑舒适的衣服那样让人愉快了:纱厂工人终日面临着噪音,尘埃和湿气。" }
字段解释:
- id:唯一标识符,无意义。
- original_text:原始错误文本。
- errors:错误列表,包含原始错误文本片段(original_error)、错误类型(type)和正确的文本(correct)。错误类型包括拼写错误(spelling_error)、语法错误(grammar_error)、缺少单词(missing_word)、多余单词(extra_word)等。
- correct_text:纠正后的文本。
支持的任务和排行榜
该数据集设计用于中文拼写纠错任务的预训练语言模型训练。
语言
数据集中的数据为中文。
许可信息
该数据集在Apache 2.0许可下发布。
引用信息
latex @misc{Xu_Pycorrector_Text_error, title={Pycorrector: Text error correction tool}, author={Xu Ming}, year={2024}, howpublished={url{https://github.com/shibing624/pycorrector}}, }
贡献者
shibing624 整理并上传。