pemujo/GLDv2_Top_51_Categories
收藏资源简介:
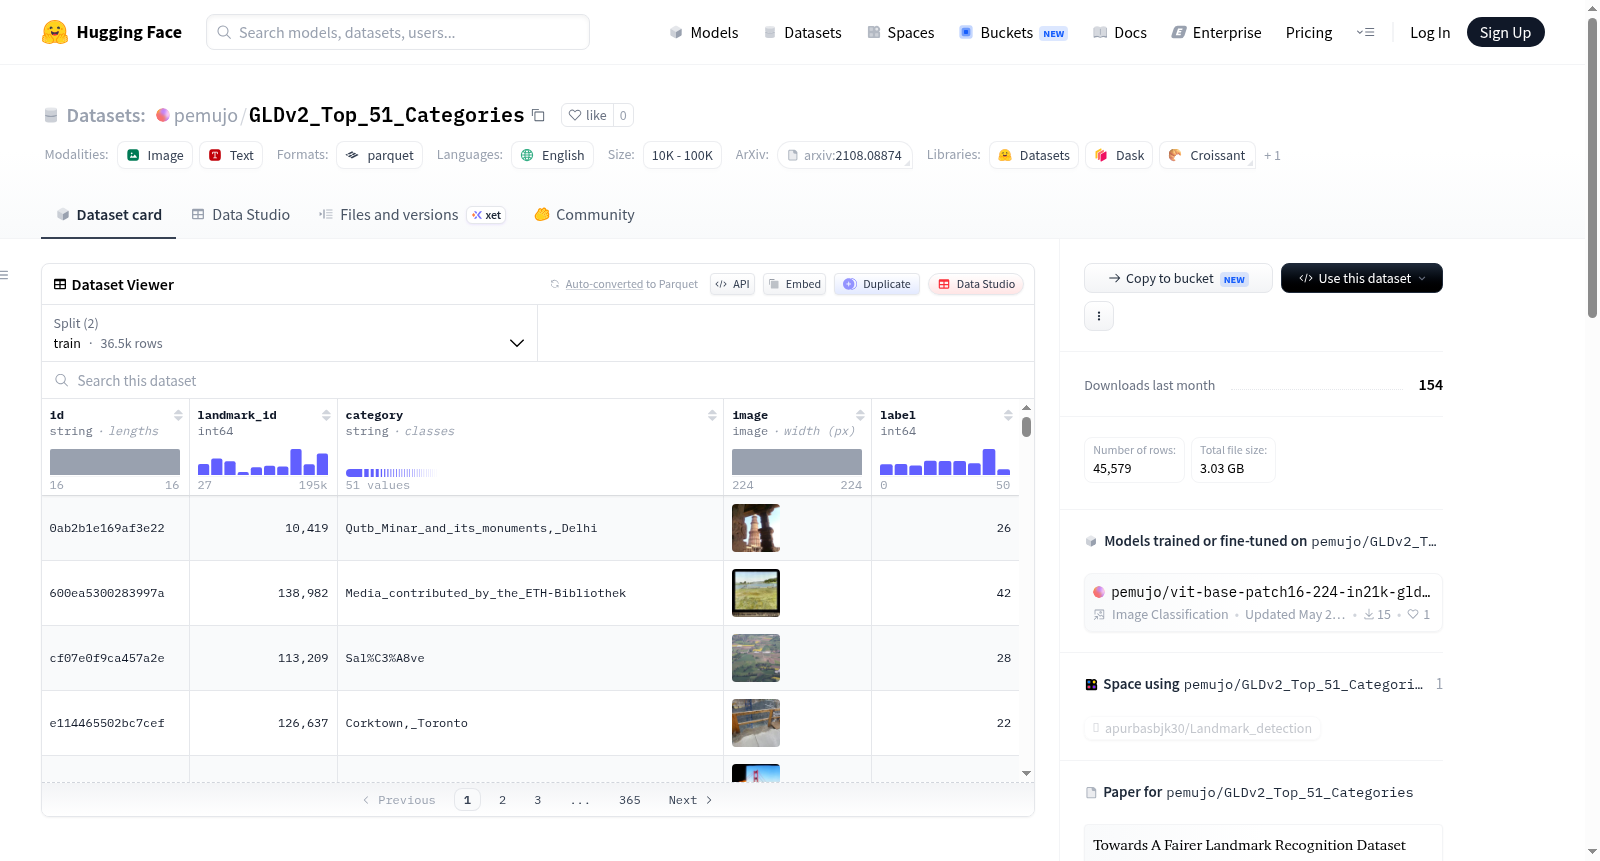
--- dataset_info: features: - name: id dtype: string - name: landmark_id dtype: int64 - name: category dtype: string - name: image dtype: image - name: label dtype: int64 splits: - name: train num_bytes: 2428986323.125 num_examples: 36463 - name: test num_bytes: 606874794.5 num_examples: 9116 download_size: 3034360629 dataset_size: 3035861117.625 language: - en pretty_name: GLDv2 Top 51 Categories size_categories: - n<1K --- # Dataset Card for Dataset Name ### Dataset Summary This dataset is a subset of Kaggle's Google Landmark Recognition 2021 competition with only the categories with more than 500 images. https://www.kaggle.com/competitions/landmark-recognition-2021/data The dataset consists of a total of 45579 224x224 color images in 51 categories. ### Languages English ## Dataset Structure ### Data Fields - `landmark_id`: Int - Numeric identifier of the category - `category` : String - Name of the category - `id` : String - Image identifier - `image` : Image - PIL image object - `label` : Int - Numeric label from 0 to 50 ### Data Splits The dataset was randomly split with 80% of the images for the train set and 20% for the test set. | | train | test | |----------------------|------:|-----:| | Dataset | 36463 | 9116 | ### Source Data The full dataset is from Kaggle Landmark Recognition 2021 "Towards A Fairer Landmark Recognition Dataset", Z. Kim, A. Araujo, B. Cao, C. Askew, J. Sim, M. Green, N. Yilla and T. Weyand, arxiv:2108.08874 https://www.kaggle.com/competitions/landmark-recognition-2021/data ### Citation Information "Google Landmarks Dataset v2 - A Large-Scale Benchmark for Instance-Level Recognition and Retrieval", T. Weyand, A. Araujo, B. Cao and J. Sim, Proc. CVPR'20 "Towards A Fairer Landmark Recognition Dataset", Z. Kim, A. Araujo, B. Cao, C. Askew, J. Sim, M. Green, N. Yilla and T. Weyand, arxiv:2108.08874
--- dataset_info: 数据集信息: features: - 名称: id,数据类型: 字符串 - 名称: landmark_id,数据类型: 64位整数 - 名称: category,数据类型: 字符串 - 名称: image,数据类型: 图像 - 名称: label,数据类型: 64位整数 splits: - 名称: 训练集(train), 字节数: 2428986323.125, 样本数: 36463 - 名称: 测试集(test), 字节数: 606874794.5, 样本数: 9116 download_size: 3034360629 字节 dataset_size: 3035861117.625 字节 language: 英语 pretty_name: GLDv2前51类数据集(GLDv2 Top 51 Categories) size_categories: - 样本数<1000 --- # 数据集卡片 ### 数据集概览 本数据集是Kaggle平台2021年谷歌地标识别竞赛数据集的子集,仅包含图像数量超过500张的类别。 https://www.kaggle.com/competitions/landmark-recognition-2021/data 本数据集共包含51个类别的45579张224×224彩色图像。 ### 语言 英语 ## 数据集结构 ### 数据字段 - `landmark_id`: 整数型——类别的数字标识符 - `category`: 字符串型——类别名称 - `id`: 字符串型——图像标识符 - `image`: 图像型——PIL图像对象 - `label`: 整数型——取值范围为0至50的数字标签 ### 数据划分 本数据集按随机划分,训练集包含80%的图像,测试集包含20%的图像。 | | 训练集 | 测试集 | |----------------------|-------:|-------:| | 样本量 | 36463 | 9116 | ### 源数据 完整数据集来源于Kaggle平台的2021年地标识别竞赛。 《迈向更公平的地标识别数据集》(*Towards A Fairer Landmark Recognition Dataset*),Z. Kim、A. Araujo、B. Cao、C. Askew、J. Sim、M. Green、N. Yilla及T. Weyand,arxiv:2108.08874 https://www.kaggle.com/competitions/landmark-recognition-2021/data ### 引用信息 《谷歌地标数据集v2——面向实例级识别与检索的大规模基准数据集》(*Google Landmarks Dataset v2 - A Large-Scale Benchmark for Instance-Level Recognition and Retrieval*),T. Weyand、A. Araujo、B. Cao及J. Sim,发表于CVPR'20 《迈向更公平的地标识别数据集》(*Towards A Fairer Landmark Recognition Dataset*),Z. Kim、A. Araujo、B. Cao、C. Askew、J. Sim、M. Green、N. Yilla及T. Weyand,arxiv:2108.08874
数据集概述
- 名称: GLDv2 Top 51 Categories
- 数据集大小: 总大小为3035861117.625字节
- 下载大小: 3034360629字节
- 语言: 英语
- 类别数量: 51
- 图像总数: 45579张
- 图像尺寸: 224x224像素,彩色图像
- 数据分割:
- 训练集: 36463张图像,占80%
- 测试集: 9116张图像,占20%
数据字段
- id: 字符串类型,图像标识符
- landmark_id: 整数类型,类别数字标识
- category: 字符串类型,类别名称
- image: 图像类型,PIL图像对象
- label: 整数类型,数值标签,范围从0到50
数据集来源
- 原始数据集: Kaggle Landmark Recognition 2021
- 相关研究:
- "Google Landmarks Dataset v2 - A Large-Scale Benchmark for Instance-Level Recognition and Retrieval", T. Weyand, A. Araujo, B. Cao and J. Sim, Proc. CVPR20
- "Towards A Fairer Landmark Recognition Dataset", Z. Kim, A. Araujo, B. Cao, C. Askew, J. Sim, M. Green, N. Yilla and T. Weyand, arxiv:2108.08874