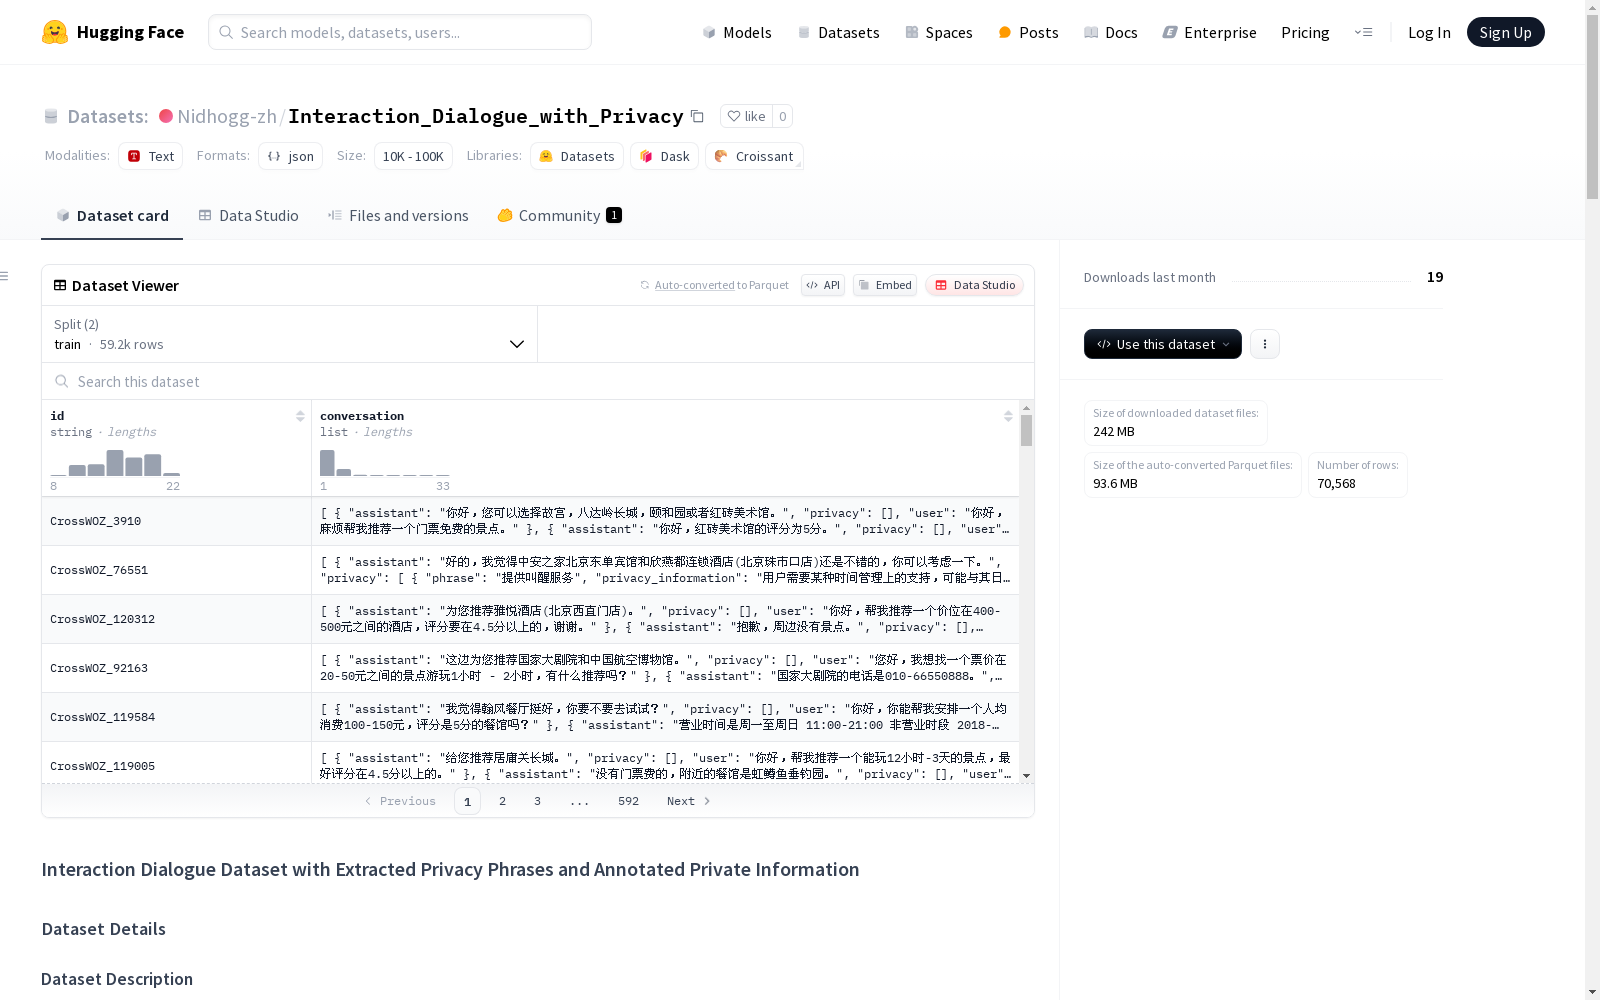
Interaction_Dialogue_with_Privacy
收藏资源简介:
这是一个用于自动标注用户与大型语言模型互动中隐私信息的对话数据集。基于自动隐私标注流程,从不同语言的对话数据集中提取隐私短语并注释隐私信息。数据集包含了来自一个英语对话数据集ShareGPT和三个中文对话数据集CrossWOZ、DuConv和LCCC-base的查询。适用于训练和评估用于隐私泄露分类、隐私短语提取和隐私信息总结的本地隐私检测模型。
This is a dialogue dataset designed for automatically annotating privacy information during user interactions with large language models (LLMs). Based on an automated privacy annotation pipeline, privacy phrases are extracted and privacy information is annotated from multilingual dialogue datasets. The dataset includes query samples from one English dialogue dataset ShareGPT and three Chinese dialogue datasets: CrossWOZ, DuConv, and LCCC-base. It is applicable for training and evaluating local privacy detection models for tasks including privacy leakage classification, privacy phrase extraction, and privacy information summarization.
Interaction Dialogue Dataset with Extracted Privacy Phrases and Annotated Private Information
数据集详情
数据集描述
- 数据集名称:Automated Annotation of Privacy Information in User Interactions with Large Language Models
- 数据来源:包含一个英文对话数据集(ShareGPT)和三个中文对话数据集(CrossWOZ、DuConv、LCCC-base)
- 数据规模:249K查询,来自33K对话,包含154K隐私短语和对应信息
- 语言:英文和中文
数据集统计
| 语言 | 训练集(非泄漏/泄漏/短语数) | 测试集(非泄漏/泄漏/短语数) |
|---|---|---|
| 英文 | 52,053 / 26,156 / 67,780 | 12,792 / 6,658 / 17,540 |
| 中文 | 98,100 / 38,025 / 60,611 | 10,633 / 5,230 / 8,299 |
源数据链接
| 语言 | 语料库 | 源链接 |
|---|---|---|
| 英文 | ShareGPT | https://huggingface.co/datasets/shareAI/ShareGPT-Chinese-English-90k |
| 中文 | CrossWOZ | https://github.com/thu-coai/CrossWOZ |
| 中文 | DuConv | https://aistudio.baidu.com/aistudio/datasetdetail/177164 |
| 中文 | LCCC-base | https://github.com/thu-coai/CDial-GPT |
直接用途
- 训练和评估本地隐私检测模型
- 研究用户交互对话的隐私检测
- 基准测试隐私检测模型的性能
数据集结构
数据文件
- 英文部分:
- English/pirvacy_information_train_en.json
- English/pirvacy_information_test_en.json
- 中文部分:
- Chinese/pirvacy_information_train_zh.json
- Chinese/pirvacy_information_test_zh.json
数据格式
- 每个样本包含:
- 用户查询("user")
- 助手响应("assistant")
- 注释隐私列表("privacy")
- "phrase":提取的隐私短语
- "privacy information":隐私短语的详细描述
数据集分析
- 英文数据集中前20个隐私类别的相对频率
- 英文数据集中已识别隐私信息的词云
数据集创建
创建理由
支持训练和评估用户与LLM交互的本地隐私检测模型
数据收集与处理
- 参考论文(正在审阅)和自动注释管道代码
建议
- 结合其他语料库使用以减轻文化或语言偏见
- 确保数据使用的责任性