
resume-to-json-dataset
收藏官方服务:
资源简介:
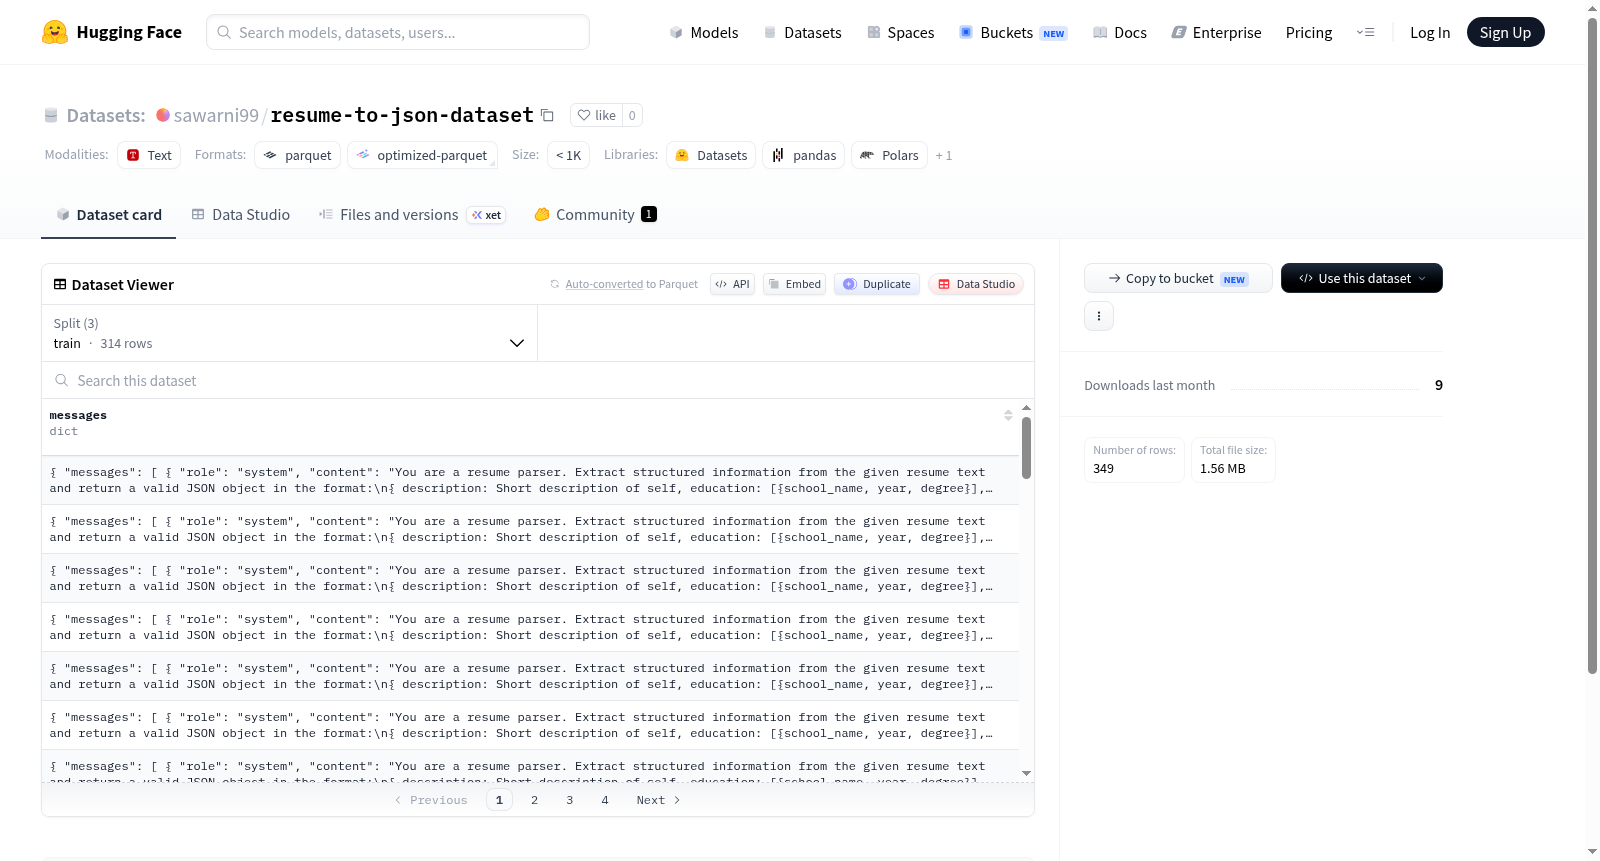
该数据集包含349个结构化对话样本,组织为训练集(314个样本)、验证集(17个样本)和测试集(18个样本)三个标准分割。每个样本以对话形式呈现,包含messages字段,该字段为列表结构,每条消息由role(参与者角色)和content(对话内容)两个字符串字段组成。数据集总大小约1.53MB。
This dataset contains 349 structured dialogue samples, organized into three standard splits: training set (314 samples), validation set (17 samples), and test set (18 samples). Each sample is presented in a dialogue format, including a messages field, which is a list structure where each message consists of two string fields: role (participant role) and content (dialogue content). The total size of the dataset is approximately 1.53MB.
创建时间:
2026-06-25
原始信息汇总
数据集名称
resume-to-json-dataset
数据集描述
该数据集用于将简历(Resume)内容转换为JSON格式,属于结构化文本转换任务。
数据集结构
- 特征(Features):
messages:消息列表,包含两个子字段:role(字符串类型):角色标识(如用户或助手)。content(字符串类型):对话或内容文本。
数据集划分
| 数据划分 | 样本数量 | 大小(字节) |
|---|---|---|
| train(训练集) | 314 | 1,386,690 |
| validation(验证集) | 17 | 74,846 |
| test(测试集) | 18 | 72,904 |
数据集大小
- 总下载大小:1,558,239 字节
- 总数据集大小:1,534,440 字节
配置文件与数据文件
- 默认配置(default):
- 训练集:
data/train-* - 验证集:
data/validation-* - 测试集:
data/test-*
- 训练集:
搜集汇总
数据集介绍
构建方式
在自然语言处理与信息抽取领域,将非结构化的简历文本转换为结构化的JSON格式是一项极具挑战性的任务。该数据集通过收集314条训练样本、17条验证样本及18条测试样本,总计349条中英文简历数据,构建了一个聚焦于简历信息结构化抽取的微调数据集。每条数据均以对话形式呈现,包含角色(role)与内容(content)两字段,通过精心设计的提示模板与目标输出,引导模型学习从自由文本中精准提取姓名、教育背景、工作经历等关键字段,并将其组织为规范的JSON结构。
使用方法
使用该数据集时,推荐基于HuggingFace的datasets库直接加载,通过指定config_name为'default'即可获取各分片的parquet文件。在模型微调阶段,应将'messages'字段作为输入,其中包含的对话历史可用于构建序列到序列的学习任务。建议采用标准的指令微调流程,将角色为'assistant'的内容作为目标输出,同时利用role为'user'的提示进行模型训练。测试时,输入原始简历文本后,模型应能输出结构化的JSON字典,通过后处理校验即可获得可用于下游任务的结构化数据。
背景与挑战
背景概述
在自然语言处理与信息抽取领域,将非结构化的简历文本转化为结构化的JSON格式是一项具有重要实用价值的任务。resume-to-json-dataset数据集由相关研究人员或机构于近期创建,旨在为简历信息自动解析提供标准化的训练与评估语料。该数据集包含314条训练样本、17条验证样本和18条测试样本,每条样本由角色与内容字段构成,模拟了对话式指令调优的输入输出结构。其核心研究问题在于如何借助精细标注的数据,使模型能够精准提取简历中的姓名、教育经历、工作经历等关键字段,从而推动自动化简历解析系统的发展。该数据集的发布为招聘领域的智能信息处理提供了基础资源,对提升人才筛选效率具有深远影响。
当前挑战
该数据集所解决的领域问题聚焦于非结构化简历文本到结构化JSON的转换,这一任务在现实中面临简历格式多样、表述随意、关键字段隐晦等挑战,传统规则方法难以适应复杂多变的输入。在构建过程中,研究人员需应对数据稀缺的困境,仅314条训练样本限制了模型的泛化能力,同时需人工设计并标注符合对话式指令调优模板的高质量样本,确保角色与内容对应准确。此外,简历中常包含大量冗余或缺失信息,如何定义完备的JSON Schema以覆盖常见字段并处理异常情况,亦构成了数据集构建的核心难点。这些挑战共同凸显了该数据集在推动简历解析研究中的关键作用与未来改进空间。
常用场景
经典使用场景
在自然语言处理与信息抽取领域,resume-to-json-dataset数据集被广泛用于将非结构化的简历文本转化为结构化的JSON格式数据。研究人员通过该数据集训练序列到序列模型或基于Transformer的生成式语言模型,使其能够根据简历内容自动提取个人信息、教育背景、工作经历、技能标签等关键字段,并输出标准化的JSON对象。这一过程不仅验证了模型在长文本关键信息结构化抽取任务上的有效性,也为下游的人岗匹配、智能招聘系统提供了数据基础。该数据集的小样本特性(约314条训练样本)使得它特别适合用于微调小型预训练模型,或作为少样本学习与提示工程方法的评测基准。
解决学术问题
该数据集破解了简历信息自动化解析这一学术难题。传统上,简历格式多变、术语丰富且噪声大,导致规则驱动的信息抽取方法泛化能力弱、维护成本高。resume-to-json-dataset的出现为基于深度学习的端到端结构化抽取提供了标准化的训练与评估资源,使得模型能够在不同的简历风格中保持一致的信息识别能力。它推动了命名实体识别、关系抽取与序列生成任务的交叉融合,促使学界探索更鲁棒的生成式抽取架构。其所倡导的‘从自由文本到结构化对象’的范式,对无结构化文档的语义理解研究具有重要启发意义。
实际应用
在实际应用中,该数据集驱动了智能人力资源系统的核心功能革新。借助该数据集训练出的模型,企业能够将海量PDF或Word格式的简历自动转化为结构化的候选人档案,将其无缝对接至招聘管理系统与人才数据库。这一能力显著降低了HR在简历初筛、信息录入环节的人力成本,将平均处理时间从数分钟缩短至秒级。同时,结构化后的数据支持按技能、年限、公司等维度进行精准搜索与批量比对,为大规模校招、猎头匹配及内部人才盘点场景提供了效率引擎。此外,该技术还可延伸至对领英、智联等在线简历页面的信息提取,强化了跨平台人才数据整合的自动化水平。
数据集最近研究
最新研究方向
在当前大语言模型(LLM)与自然语言处理(NLP)深度融合的浪潮中,非结构化文本到结构化数据的精准映射成为关键瓶颈。resume-to-json-dataset 作为专注于简历解析的高质量微调数据集,紧密契合了智能招聘与自动化文档理解的前沿需求。该数据集通过覆盖训练、验证与测试三分的349例样本,精细标注了消息角色与内容特征,为训练模型从冗长、多样的简历文本中抽取关键字段(如姓名、技能、工作经历)并输出标准JSON格式提供了坚实基础。随着人岗匹配与人才筛选等热点应用的爆发,该数据集的推出显著推动了LLM在垂直领域进行指令微调(Instruction Tuning)与信息抽取精度的研究进展,其小样本、高精度的设计范式对于提升模型在复杂文本结构中的泛化能力具有开创性意义。
以上内容由遇见数据集搜集并总结生成


