pubmed-ocr
收藏资源简介:
PubMed-OCR是一个基于PubMed Central开放获取PDF的科学文章OCR语料库。每页被渲染为图像,并使用Google Cloud Vision OCR进行标注,以紧凑的JSON格式发布,包含单词、行和段落级别的边界框。该数据集旨在支持布局感知建模、基于坐标的问答以及科学文档上OCR依赖管线的评估。数据集包含20.95万篇文章,约150万页,约13亿个单词(OCR标记)。
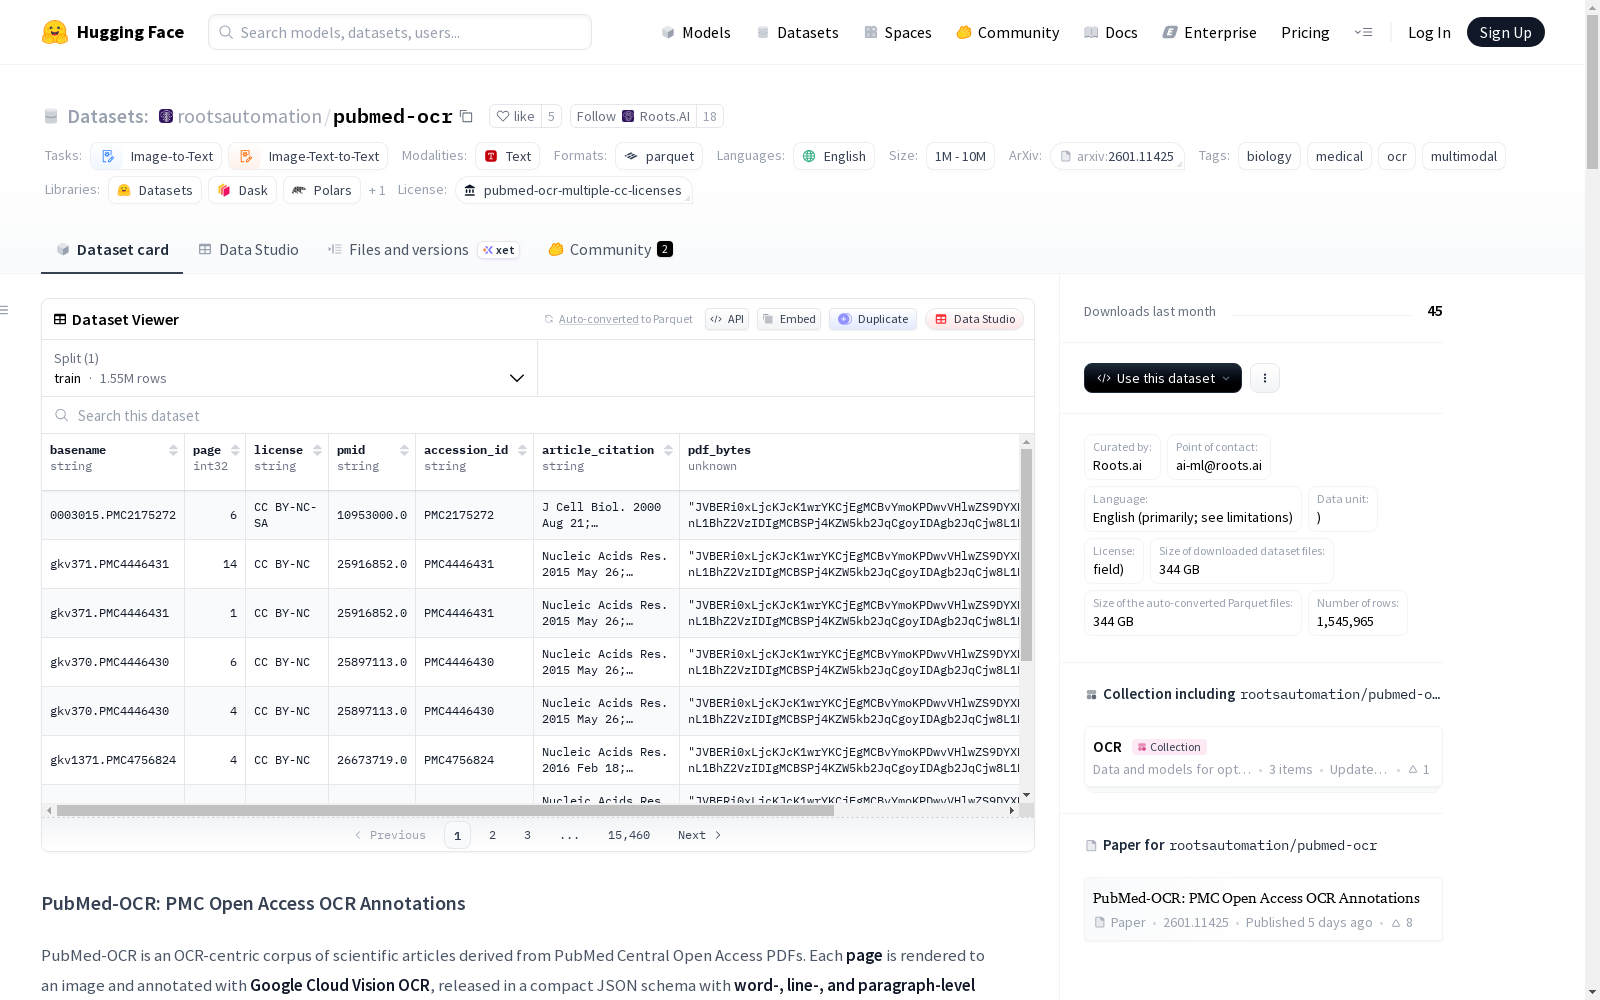
PubMed-OCR is a scientific article OCR corpus based on the open-access PDFs of PubMed Central. Each page is rendered as an image and annotated using Google Cloud Vision OCR, and released in a compact JSON format that includes bounding boxes at the word, line, and paragraph levels. This dataset is designed to support layout-aware modeling, coordinate-based question answering, and the evaluation of OCR-dependent pipelines on scientific documents. The dataset contains 209,500 articles, approximately 1.5 million pages, and around 1.3 billion words (OCR tokens).
PubMed-OCR 数据集概述
数据集基本信息
- 数据集名称:PubMed-OCR
- 官方描述:PubMed-OCR 是一个源自 PubMed Central Open Access PDF 的科学文章 OCR 中心语料库。每个页面都被渲染为图像,并使用 Google Cloud Vision OCR 进行标注,以紧凑的 JSON 模式发布,包含单词级、行级和段落级的边界框。
- 语言:英语(主要)
- 许可证:源自文章的多种许可证(每行
license字段记录) - 数据规模:
- 文章数量:209.5K
- 页面数量:约 1.5M
- OCR 词汇数量:约 13 亿
数据集结构与内容
- 数据单元:1 行 = 1 个 PDF 页面(由
{basename, page}唯一标识) - 数据字段:
basename(string):文章/页面组标识符。page(int32):PDF/文章内的页面索引。license(string):源文章的许可证(例如cc-by-4.0,cc-by-nc-4.0)。pmid(string):PubMed ID(如果可用)。accession_id(string):收录标识符(例如 PMCID 或内部 ID)。article_citation(string):源文章的引用字符串。pdf_bytes(binary):原始 PDF 字节(在允许重新分发的情况下提供);否则可能为空/空值。ocr_json(string):OCR 输出 JSON,包含像素坐标下的边界框。
- 数据格式:数据以 Parquet 文件格式提供。
- 数据划分:本版本作为单个
train划分提供,主要是一个语料库。建议为基准测试构建评估划分以减少泄漏。
数据集来源与创建
- 来源语料库:PubMed Central Open Access (PMCOA)
- 创建方:Roots.ai
- 联系人:ai-ml@roots.ai
- 创建过程:
- 下载 PMCOA PDF 并筛选允许重新分发衍生作品的许可证。
- 均匀采样 209.5K 篇文档。
- 以 150 DPI 渲染每个页面。
- 在页面图像上运行 Google Cloud Vision
document_text_detection。 - 提取单词级和段落级多边形,并规范化为轴对齐边界框
[x1, y1, x3, y3]。 - 通过聚类具有相似垂直对齐的单词(启发式方法)重建行边界框。
- 每页输出一行,包含
ocr_json(以及在允许的情况下包含pdf_bytes)。
- 标注过程:标注由 Google Cloud Vision OCR 机器生成。单词和段落由 OCR 引擎提供,行是根据单词框启发式重建的。
预期用途
- 训练/评估 OCR 感知或布局感知的文档模型。
- 测试依赖 OCR 的流程(解析、检索、提取)的鲁棒性。
- 构建需要坐标基础证据的任务(例如,引用和定位、区域归因)。
- 为科学 PDF(表格、公式、图注、参考文献)进行基准测试策划。
限制与注意事项
- OCR 输出非黄金文本:包含识别错误。
- 单一 OCR 引擎:输出反映了 Google Vision 的优势/弱点,可能无法推广到其他 OCR 系统。
- 启发式行重建:行分组和阅读顺序可能不完美,尤其是在多栏布局以及公式/表格周围。
- 轴对齐框:原始 OCR 多边形被简化为矩形。
- 领域偏差:PMCOA 的期刊分布呈重尾分布(高影响力期刊占主导)。
- 非文本区域:此数据集不提供表格/图形/公式的黄金结构(仅提供 OCR 输出 + 衍生的行)。
- 不适用范围:
- 不应用于临床/医疗决策。
- 不应用于在适用的许可条款之外学习受版权保护的内容。
- 不打算用作阅读顺序的真实数据集。
引用信息
如果使用 PubMed-OCR,请引用: bibtex @article{heidenreich2025pubmedocr, title={PubMed-OCR: PMC Open Access OCR Annotations}, author={Heidenreich, Hunter and Getachew, Yosheb and Dinica, Olivia and Elliott, Ben}, journal={arXiv preprint arXiv:2601.11425}, year={2025} }
相关链接
- 数据集仓库:https://huggingface.co/datasets/rootsautomation/pubmed-ocr
- 论文:https://huggingface.co/papers/2601.11425