
Beetle-Data/en-for-tl-2B-pretok
收藏官方服务:
资源简介:
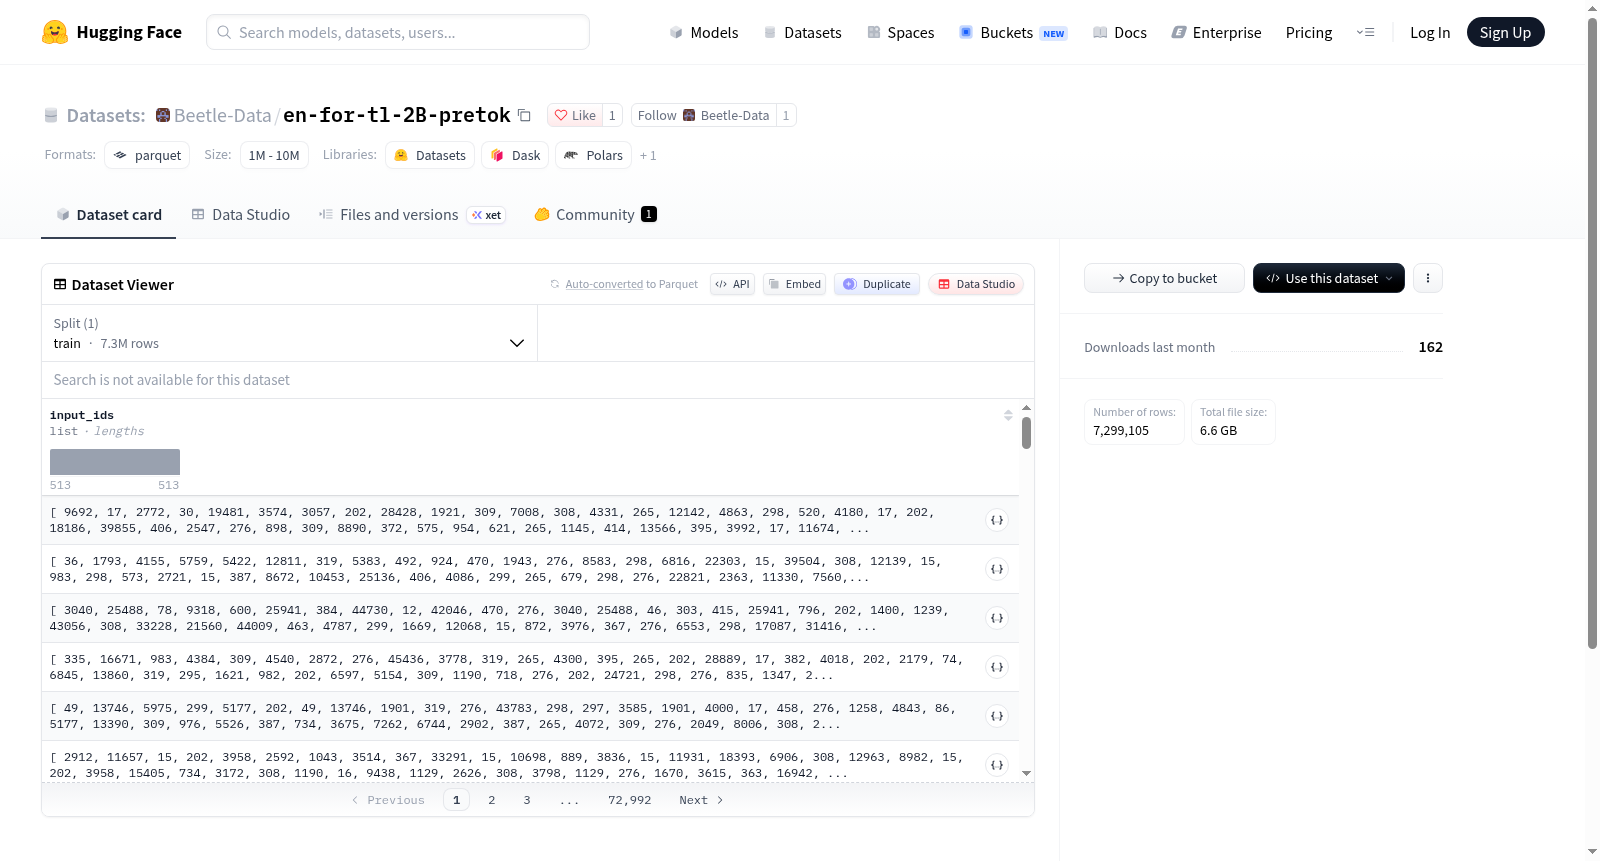
Beetle-Data/en-for-tl-2B-pretok是一个预分词的数据集,包含513个令牌的打包序列(input_ids),确保没有跨文档的混合。数据以分片形式增量上传,当所有部分上传完成后,会通过提交data/_finalized.json文件作为标记。
Pretokenized chunks (input_ids = 513-token packed sequences, no cross-document bleeding). Sharded incrementally; the marker data/_finalized.json is committed once all parts are uploaded.
提供机构:
Beetle-Data搜集汇总
数据集介绍
构建方式
面向自回归语言模型预训练的语料工程,通常需在训练吞吐与样本完整性之间寻求平衡。en-for-tl-2B-pretok 的构建以此为核心,将原始文本预先切分为 token 序列并映射为 input_ids,再以 513-token 为固定长度进行打包,使每条样本承载稳定的上下文规模。打包过程严格控制文档边界,避免不同文档片段相互拼接,从而消除跨文档语义渗漏。数据最终以 parquet 格式分片存放于 data 目录,并采用增量上传方式逐步发布;当全部数据分片上传完成后,仓库提交 data/_finalized.json 作为终结标记,默认配置则统一指向 data/*.parquet,便于后续批量读取与复现。
特点
预训练语料的数据形态深刻影响模型训练效率与语义学习质量。该数据集以预分词与固定长度打包为显著特点,input_ids 字段直接给出 513-token 的 packed sequences,训练时无需在线分词或动态拼接,可显著降低数据预处理开销。其文档边界隔离机制确保序列内不混入其他文档内容,有助于保持长上下文建模中的语义连贯性,避免人为拼接引入的噪声。数据集采用 parquet 列式分片存储,适合大规模并行读取与流式加载;增量分片发布与 data/_finalized.json 终结标记相结合,为数据完整性核验和版本管理提供了明确依据。
使用方法
在语言模型训练与语料分析流程中,已预分词的数据集能够简化数据管线并提升吞吐。使用 en-for-tl-2B-pretok 时,可通过 HuggingFace datasets 库加载默认配置 default,数据文件模式为 data/*.parquet。加载后直接读取 input_ids 字段即可获得 513-token 序列,无需再调用 tokenizer 进行编码或截断。该数据适用于因果语言模型预训练、继续预训练、token 分布统计及数据质量检查等任务。进行分布式训练时,可结合流式模式或分片读取策略以控制内存占用;若需验证发布完整性,可检查 data/_finalized.json 标记是否已经提交。
背景与挑战
背景概述
在大规模语言模型预训练日益依赖高质量分词语料的背景下,en-for-tl-2B-pretok 由 Beetle-Data 发布与维护,是面向英语至目标语言(TL)场景的预分词数据集合。其核心形态为 input_ids 长度为 513 的打包序列,并强调文档间不流血(no cross-document bleeding),以降低预训练中的跨文档污染风险。数据集采用增量分片上传机制,并以 data/_finalized.json 标记全部片段完成。README 未披露具体创建时间、研究人员与机构信息,亦未说明下游评测结果;其影响力主要体现在为相关语言模型预训练提供即用型 token 序列,减少分词与打包环节的工程成本,并提升数据加载与复现效率。
当前挑战
在语言模型预训练语料规模化与标准化的脉络中,该数据集所涉及的领域问题在于如何将海量原始文本转化为固定长度、边界清晰且无跨文档泄漏的 token 序列,以支撑高效稳定的模型训练。其具体挑战包括:维持 513 长度打包序列在文档切换处的边界正确性,避免不同文档内容相互渗透;在增量分片上传过程中保证各分片顺序、格式与校验一致,并依赖 data/_finalized.json 准确标识最终完成状态;面对 2B 量级 token 的存储、分片管理与可复现加载需求,需协调数据版本、文件完整性及下游训练框架兼容性。这些工程约束共同构成该数据集在构建与使用中的关键难点。
常用场景
经典使用场景
在大规模语言模型预训练与跨语言数据工程语境中,Beetle-Data/en-for-tl-2B-pretok 的经典使用场景在于直接向自回归语言模型供给预分词后的 513-token 打包序列。研究者借助 Parquet 分片读取 input_ids,绕过在线分词与动态拼接带来的计算开销,使训练管线获得更高吞吐与稳定批大小。由于打包过程避免跨文档渗出,模型在长块序列中仍能保持文档边界清晰,适合因果语言建模、继续预训练与低资源语言适配。该数据尤其面向英语—塔加洛语方向的跨语言预训练,在约二十亿词元规模上为语言模型提供统一、可复现的输入表示,并便于分片增量上传与完整性校验。
衍生相关工作
围绕预训练数据驱动的模型创新,该数据集衍生的相关经典工作多集中于低资源语言模型、跨语言迁移与高效训练管线。以 en-for-tl-2B-pretok 为输入,研究者和工程者常开展因果语言模型继续预训练、编码器—解码器跨语言适配、英语—塔加洛语双语文本生成与分类器微调,并据此形成塔加洛语自然语言处理基准、跨语言词元共享策略以及分片数据加载工具。其预分词、无跨文档渗出与 finalized 标记等设计,也启发后续数据集在可复现性、文档边界保持和增量发布方面建立规范。相关下游工作虽依任务而异,却共同推动低资源语言预训练生态的发展。
数据集最近研究
最新研究方向
在大规模语言模型竞逐跨语言能力的背景下,en-for-tl-2B-pretok以英语—他加禄语约二十亿词元的预分词序列为对象,采用513词元定长打包并杜绝跨文档渗透,借增量分片与_finalized标记维系数据完整与可追溯。其前沿方向聚焦低资源语言预训练中的表征迁移、跨语言对齐及词元级污染控制,呼应多语大模型对可复现、可审计语料管线的迫切需求。数据溯源、许可合规、去重与基准泄漏防范构成关联热点。该数据集为英语—菲律宾语翻译、指令微调与文化适配提供底层支撑,对提升东南亚语言模型性能与数据治理规范具有示范意义。
以上内容由遇见数据集搜集并总结生成


