
遇见数据集

2077AIDataFoundation/KINA

收藏
Hugging Face2026-06-12 更新2026-06-14 收录
官方服务:

资源简介:

KINA(诺亚方舟知识索引)是一个多学科知识基准测试数据集,旨在评估大语言模型是否能够解决高密度、有来源依据的研究生级别问题,覆盖广泛的学科领域。该数据集包含899个十选项的伪多项选择题,涵盖261个细粒度子领域、70个领域和12个顶级学科,包括工程学、科学、医学、法学、文学与艺术、农学、经济学、教育学、管理学、社会学、历史和哲学。每个问题均用英文编写,提供10个答案选项(A到J),并包含正确答案、选项级解释、来源材料和学科元数据。数据集强调学科代表性、高质量控制和有界测试预算下的排名稳定性,通过四阶段质量控制流程确保问题质量,适用于模型评估和研究。

KINA (Knowledge Index of Noahs Ark) is a multidisciplinary knowledge benchmark for evaluating whether large language models can solve high-density, source-grounded, graduate-level questions across a broad map of human disciplines. The dataset contains 899 ten-option pseudo-multiple-choice questions covering 261 fine-grained subfields, 70 fields, and 12 top-level disciplines, including Engineering, Science, Medicine, Law, Literature and Arts, Agronomy, Economics, Education, Management, Sociology, History, and Philosophy. Each question is written in English, has 10 answer options (A-J), and includes the correct answer, option-level explanations, source materials, and discipline metadata. The benchmark emphasizes disciplinary representativeness, quality control under reviewer incentives, and ranking stability under bounded test budgets, with a four-stage quality-control pipeline to ensure question quality, suitable for model evaluation and research.
提供机构:
2077AIDataFoundation
搜集汇总
数据集介绍
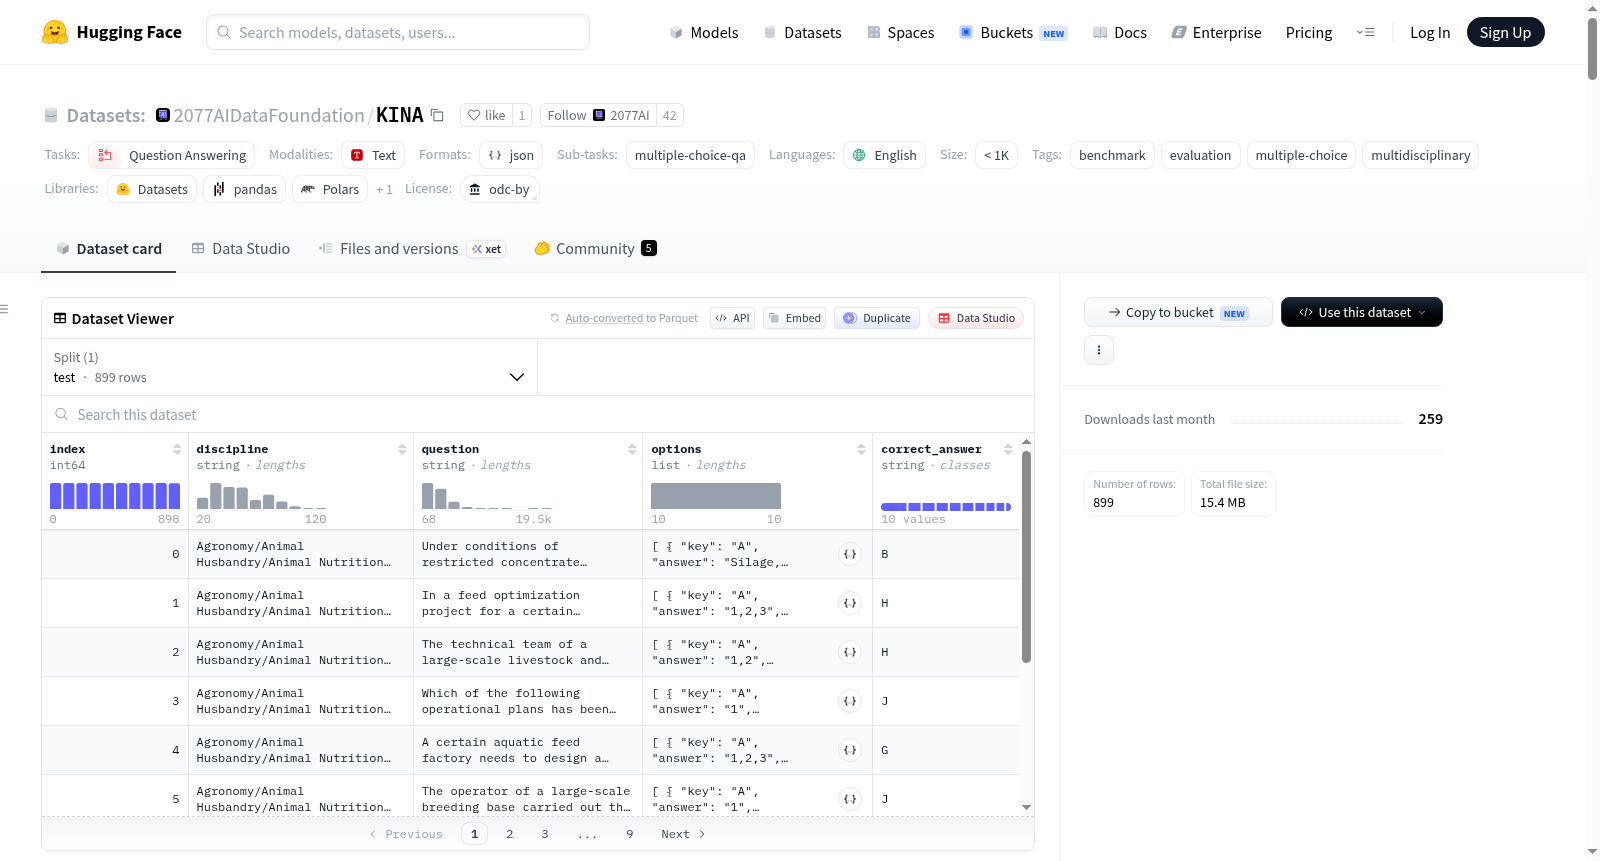
2077AIDataFoundation/KINA 数据集图片
构建方式
KINA的构建根植于对学科代表性的严谨追求,采用了一种预算支撑中心性代理方法。研究者首先通过专家启发,为261个细分子领域提取核心概念、方法、理论及应用等学科锚点,随后对候选题目进行评分,确保其在有限预算下最大化覆盖这些锚点。数据创建历经四阶段质控流水线:基于规则的筛选剔除重复与低质题目,双盲专家评审结合奖金锦标赛机制激励深度审查,三位法官的大语言模型共识投票评估知识覆盖面与学科独特性,最后通过代理诊断与人工确认修正边界缺陷。评审者来自全球顶尖高校的博士生与高级产业专家,并通过随机审计确保质量。
特点
KINA以其高密度、源可溯、研究生级别的多学科知识评估特性脱颖而出。数据集涵盖12个顶级学科、70个领域与261个细分子领域,包含899道十选项伪多选题,每道题均附带选项级解释、来源材料及学科元数据。其题目设计强调学科理解而非表面记忆,通过伪多选结构、组合判断与严格选项逻辑,测试模型在领域约束与因果机制上的多跳推理能力。此外,KINA拒绝依赖窄记忆、模糊措辞或易变学术观点的题目,确保评估的稳健性与代表性。当前前沿模型的最佳得分仅为53.17%,凸显其挑战性。
使用方法
使用KINA进行模型评估时,采用标准化提示格式,要求模型在阅读问题与十个选项后,以“Answer: $LETTER”格式输出最终答案。评估脚本读取模型输出,提取预测选项字母并与正确选项比对。数据集以JSON格式提供,包含索引、学科路径、问题文本、选项数组及每个选项的解释。为保障统计显著性,建议在899题规模下,仅将超过2个百分点的模型差异视为可区分。KINA作为基准数据集,用户可报告可疑答案或来源问题,并需注意不应将其作为专业认证或高风险场景的替代工具。
背景与挑战
背景概述
KINA(Knowledge Index of Noah's Ark)是由2077AIDataFoundation于2026年创建的一个多学科知识基准数据集,旨在评估大型语言模型在高密度、源头可溯、研究生级别问题上的表现。该数据集覆盖12个顶级学科、70个领域和261个细分子领域,包含899道十选项伪多选题,其设计核心解决了知识导向型评估中的学科代表性、审稿激励下的质量控制以及有限测试预算下的排名稳定性三大问题。通过预算化支持中心性代理方法,KINA依据专家引出的学科锚点(如核心概念、方法、理论、应用和问题类型)筛选题目,确保了数据集的学科覆盖广泛且具有代表性。在初步评估中,13家AI实验室的前沿模型表现最佳仅为53.17%,凸显了该基准对当前模型能力的严峻挑战,为多学科知识评估提供了重要参考标尺。
当前挑战
KINA主要应对的领域问题是现有知识评估基准在学科覆盖上的浅层化和不均衡性,以及模型在深度学科推理上的能力不足;该基准通过高难度、多跳推理和伪多选题结构测试模型对学科知识的综合运用,而非简单记忆。在构建中,核心挑战包括:1)设计四阶段质量流水线,包括规则筛选、双盲专家评审(采用奖金竞赛机制避免‘懒惰共识’)、三法官LLM共识及智能体细化与人工确认,以确保题目在代表性、事实性、源可靠性、逻辑严谨性和混淆项合理性上的高标准;2)控制有限测试预算下的排名统计稳定性,因当前899道题可能导致模型间差异低于2个百分点时无法显著区分;3)依赖基于3/5旗舰模型失败过滤的难度分布,需随模型进步定期更新以维持挑战性。
常用场景
经典使用场景
KINA(Knowledge Index of Noah's Ark)是一项专为评估大语言模型多学科高阶知识能力而设计的基准测试。其经典使用场景在于通过899道十选一的伪多项选择题,系统性地检验模型在涵盖工程、科学、医学、法学、农学等12个顶级学科门类、70个领域和261个细分子领域中的知识深度与推理能力。该数据集强调题目需具备学科代表性、来源可溯性和高密度知识整合特征,题目难度来源于领域约束、因果机制与多跳学科推理的相互作用,而非简单的事实记忆。评估时要求模型在给定问题与十个选项后,输出唯一正确答案的字母标识,并结合逐步推理过程,从而全面反映模型在跨学科知识图谱中的综合表现。
实际应用
KINA在实际应用中主要服务于大语言模型的多学科知识素养测评与对比分析,目前已对来自13个AI实验室的前沿模型进行了系统评估,最佳整体准确率仅为53.17%,揭示了当前模型在研究生级别多学科知识推理上的显著局限。该数据集支持网络搜索增强评估,可带来最高+5.17个百分点的性能提升,但其增益在不同模型和学科间呈现非均匀分布。具体而言,KINA可用于高等教育学术能力诊断、专业领域辅助决策系统的能力边界探明、以及跨学科知识图谱构建效果的评估。此外,其细颗粒度的学科标签体系为教育科技公司、研究机构和企业提供了从农学到哲学等领域的细分化模型能力画像,有助于指导模型在特定专业领域的优化方向与部署决策。
衍生相关工作
KINA数据集的推出激发了多个方向的衍生研究工作。在评估方法论层面,研究者借鉴其预算约束下的学科代表性框架,开发了针对特定领域(如医学、法律)的专用知识基准,并探索了基于锚点理论的题目自动生成技术。在模型优化领域,KINA揭示的高阶推理瓶颈促使团队提出并验证了多跳推理增强训练、知识图谱注入以及分学科专家模型集成等改进策略。此外,该数据集关于伪多项选择结构与组合判断选项的设计思路,被后续工作应用于构建更复杂的逻辑推理测试集,推动了从简单事实问答向深层学科理解的评估范式转换。其开源评审与质量保障体系也为其他基准数据集的构建提供了可复用的范本,特别是在激励相容的评审机制设计方面产生了广泛影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

