
fpadovani/goldfish-Dp-swahili-100mb
收藏官方服务:
资源简介:
--- dataset_info: features: - name: text dtype: string splits: - name: train num_bytes: 1356874876 num_examples: 9249410 download_size: 899297811 dataset_size: 1356874876 configs: - config_name: default data_files: - split: train path: data/train-* ---
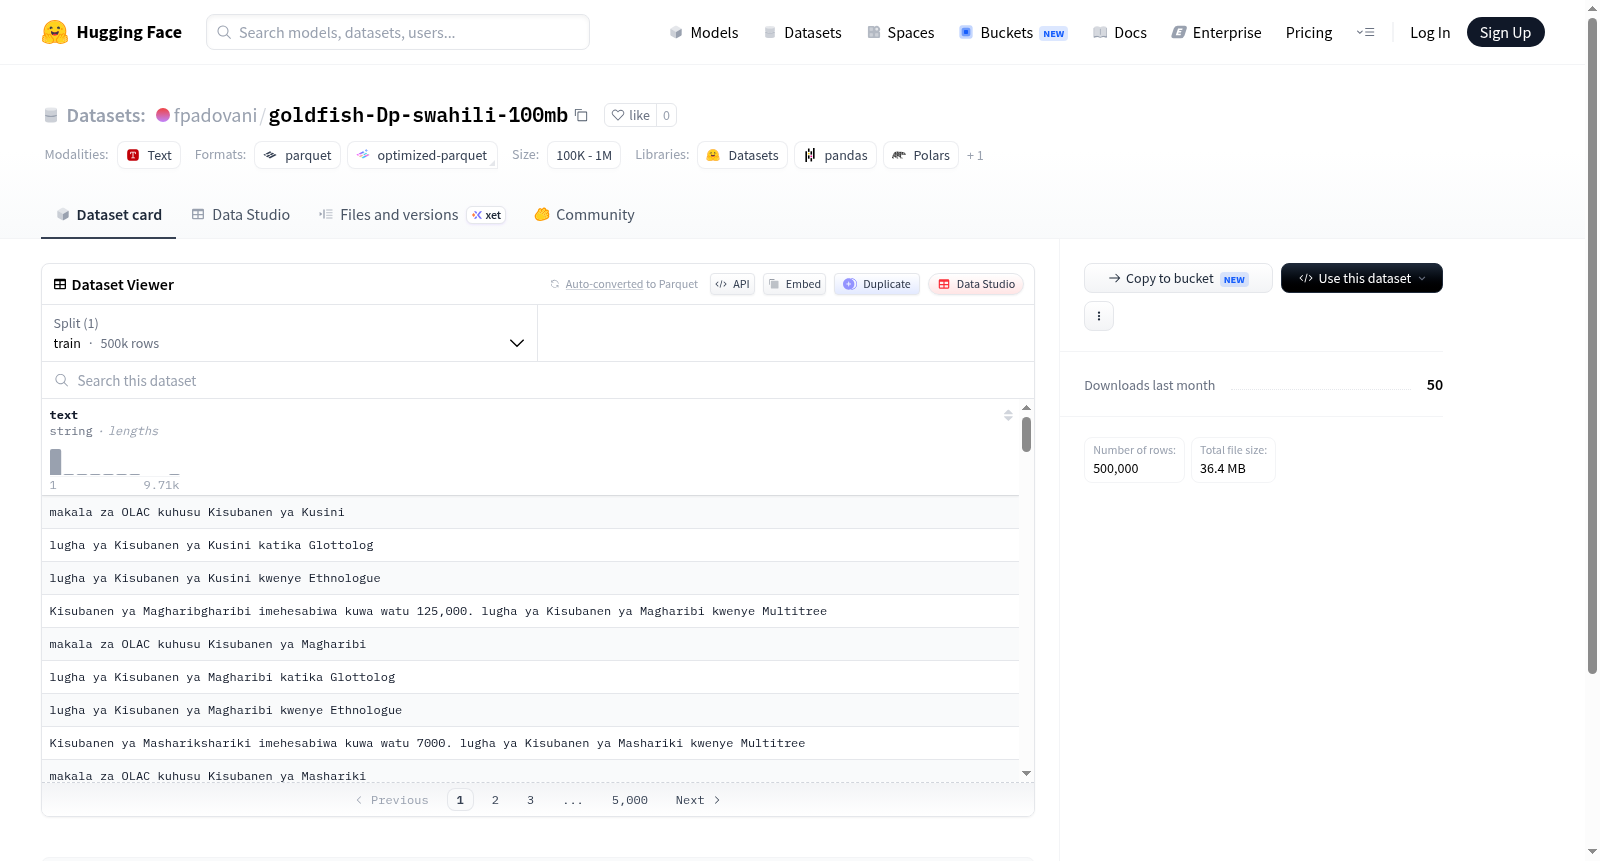
This dataset includes a string-type feature named text, primarily intended for training, with a train split containing 9,249,410 examples. The original dataset size is approximately 1.36GB, and the download size is about 899MB. Data files are located at data/train-*, suitable for natural language processing tasks such as text analysis or model training.
提供机构:
fpadovani搜集汇总
数据集介绍
构建方式
该数据集名为goldfish-Dp-swahili-100mb,源自Goldfish项目,专注于斯瓦希里语文本数据的收集与整理。构建过程通过大规模爬取斯瓦希里语语料,经过清洗、去重与标准化处理,最终形成包含50万条文本样本的训练集,总数据量约57.2MB,压缩后下载大小为36.4MB。数据以parquet格式存储,便于高效加载。
特点
数据集特点鲜明,专为斯瓦希里语的自然语言处理任务设计。其文本字段统一为字符串类型,结构简洁,无额外标签或元数据干扰,适合语言建模、文本生成等无监督学习场景。训练集规模适中,兼顾多样性与计算效率,为低资源语言的研究提供了宝贵的基础语料。
使用方法
使用方法简便,用户可通过HuggingFace Datasets库直接加载,指定配置名为'default',并读取'train'分片下的数据文件。数据集支持流式加载与批处理模式,便于集成到训练管道中。建议结合分词器进行预处理,以适配具体模型需求,如用于微调斯瓦希里语语言模型或训练词嵌入。
背景与挑战
背景概述
goldfish-Dp-swahili-100mb是一个专注于斯瓦希里语(Swahili)语言模型预训练的数据集,创建于2023年左右,由Goldfish团队主导开发。斯瓦希里语作为东非地区广泛使用的班图语系语言,拥有超过1.5亿使用者,但长期以来在自然语言处理(NLP)领域面临资源匮乏的困境,大规模、高质量的单语文本数据稀缺。该数据集旨在缓解这一瓶颈,通过收集约100MB、50万条文本样本,为斯瓦希里语的神经语言模型(如GPT类模型)提供基础训练语料。其发布填补了低资源语言在预训练数据方面的空白,推动了多语言NLP向非主流语言的延伸,对非洲语言的技术普惠和数字化保护具有里程碑意义。
当前挑战
该数据集所解决的领域问题在于,斯瓦希里语等低资源语言在NLP任务中因语料不足,难以训练出具备良好泛化能力的语言模型,尤其在词法分析、句法建模和生成任务上表现欠佳。构建过程中,挑战包括:如何从多样化的网络来源(如新闻、社交媒体、文学作品)中筛选并清洗出高质量、无噪声的斯瓦希里语文本,同时确保版权合规;如何在有限的存储容量(100MB)内平衡数据覆盖广度与领域代表性,避免方言或语体偏差;以及如何通过数据增强或过滤技术,去除重复、低信息量或非斯瓦希里语的混杂内容,从而提升预训练数据的效率与效果。
常用场景
经典使用场景
goldfish-Dp-swahili-100mb是一个专注于斯瓦希里语文本数据的语言资源数据集,包含约50万个文本样本,总规模约57MB。该数据集最经典的使用场景在于为低资源语言——斯瓦希里语的自然语言处理任务提供基础训练语料,尤其适用于语言模型的预训练与微调。在非洲地区语言数字化进程加速的背景下,该数据集填补了斯瓦希里语大规模文本语料的空白,成为许多研究者构建斯瓦希里语分词器、词嵌入模型以及神经机器翻译系统的首选训练数据。其简洁的文本-纯文本结构也便于快速加载与处理,为跨语言迁移学习研究提供了理想的实验平台。
衍生相关工作
围绕goldfish-Dp-swahili-100mb数据集,衍生了一系列推动低资源语言技术发展的经典研究工作。其中最具代表性的是将其作为斯瓦希里语基线语料,用于构建首个大规模斯瓦希里语预训练语言模型(如SwahiliBERT或基于mT5的微调版本),显著提升了文本分类与命名实体识别任务的表现。此外,在低资源神经机器翻译研究中,该数据集常与相邻语言的语料联合使用,验证了跨语言预训练与回译策略的有效性。在开源社区中,它也被集成至多语言NLP工具包(如Hugging Face Datasets库),成为其他研究者复现实验、对比不同模型架构的基准资源之一。
数据集最近研究
最新研究方向
该数据集聚焦于斯瓦希里语的低资源语言建模,为非洲语言的自然语言处理研究提供了关键数据支撑。当前前沿方向涵盖多语言预训练模型的跨语言迁移能力评估、低资源场景下的数据增强技术,以及针对斯瓦希里语的序列生成任务优化。结合全球对语言多样性的关注,该数据集推动了非洲本土语言在机器翻译、语音识别等热点领域的应用探索,其500k样本的规模为小样本学习与对比分析提供了标准化基准,对弥合数字鸿沟具有重要学术与社会意义。
以上内容由遇见数据集搜集并总结生成


