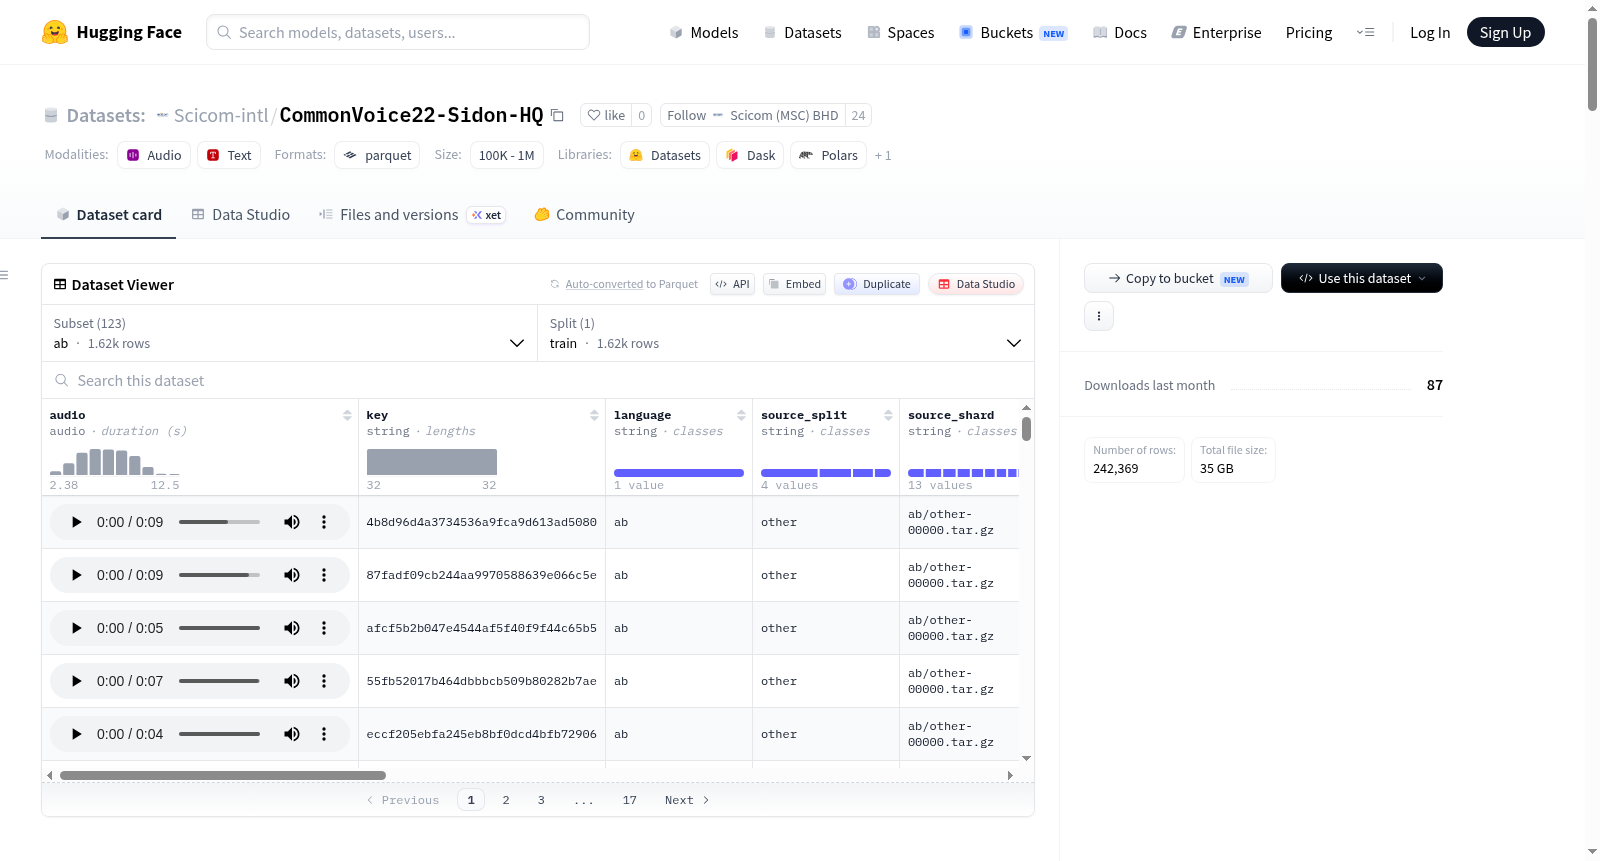
CommonVoice22-Sidon-HQ
收藏资源简介:
该数据集是一个多语言音频-文本配对语料库,涵盖多种语言(例如阿布哈兹语、阿非利卡语、阿姆哈拉语、阿拉伯语等,通过配置名称中的语言代码标识)。每个样本包含一个48kHz采样率的音频文件及其对应的转录文本。数据特征还包括:样本唯一标识符、语言标签、原始数据来源的分割与分片信息、说话人标识、结构化元数据(JSON格式)、音频时长、采样率,以及多个可能的音频质量评估指标(如bak、sig、ovrl、p808)。数据集仅提供训练集分割,各语言配置的样本数量从1到数千不等,总体规模较大且覆盖语言广泛。该数据集适用于多语言自动语音识别、语音合成、语音质量分析、低资源语言语音处理等研究与应用。
This dataset is a multilingual audio-text paired corpus that includes speech data in multiple languages (such as Abkhaz, Afrikaans, Amharic, Arabic, etc., identified by language codes in configuration names). Each sample consists of an audio file with a 48kHz sampling rate and its corresponding transcription text. Data features also include: a unique sample identifier, language label, segmentation and sharding information from the original data source, speaker identifier, structured metadata (in JSON format), audio duration, sampling rate, and multiple possible audio quality assessment metrics (e.g., bak, sig, ovrl, p808). The dataset provides only a training set split, with sample counts per language configuration ranging from 1 to several thousand, resulting in a large overall scale and broad language coverage. It is suitable for research and applications in multilingual automatic speech recognition, speech synthesis, speech quality analysis, and low-resource language speech processing.
数据集概述:CommonVoice22-Sidon-HQ
数据集地址:https://huggingface.co/datasets/Scicom-intl/CommonVoice22-Sidon-HQ
数据集简介
该数据集是 Common Voice 22 的一个高质量子集(Sidon-HQ),专注于多语言语音识别任务,提供了不同语言的音频数据及其对应的文本转录。
数据规模与语言构成
数据集包含77个不同的语言配置(config_name),每个配置代表一种语言,语言代码如 ab(阿布哈兹语)、af(南非荷兰语)、ar(阿拉伯语)、be(白俄罗斯语)、cs(捷克语)、da(丹麦语)、el(希腊语)、en(英语)、es(西班牙语)等。
数据特征
每个样本包含以下14个特征:
- audio:音频数据,采样率为 48000 Hz
- key:字符串类型,样本唯一标识
- language:字符串类型,语言代码
- source_split:字符串类型,原始数据集划分
- source_shard:字符串类型,原始数据分片
- transcript:字符串类型,文本转录
- speaker:字符串类型,说话人标识
- meta_json:字符串类型,元数据JSON
- duration:浮点数,音频时长(秒)
- sampling_rate:整数,采样率
- bak:浮点数,背景噪声评分
- sig:浮点数,信号质量评分
- ovrl:浮点数,总体质量评分
- p808:浮点数,P.808主观质量评分
数据划分
所有语言配置均仅有 train(训练集)一个划分,无验证集或测试集。
代表性语言数据量概览
| 语言 | 样本数 | 数据集大小 |
|---|---|---|
| 白俄罗斯语 (be) | 18,045 | ~2.56 GB |
| 巴斯克语 (eu) | 26,557 | ~4.05 GB |
| 世界语 (eo) | 7,067 | ~1.16 GB |
| 阿拉伯语 (ar) | 1,401 | ~0.18 GB |
| 捷克语 (cs) | 5,436 | ~0.71 GB |
| 威尔士语 (cy) | 2,749 | ~0.39 GB |
| 阿布哈兹语 (ab) | 1,621 | ~0.26 GB |
| 巴什基尔语 (ba) | 3,343 | ~0.48 GB |
| 西弗里斯兰语 (fy-NL) | 4,214 | ~0.54 GB |
| 迪尤拉语 (dyu) | 1 | 最少样本语言 |
最大语言为巴斯克语(eu),包含26,557个样本,约4.05 GB;最小语言为迪尤拉语(dyu),仅有1个样本。