
sauradip/ucount_part2
收藏搜集汇总
数据集介绍
构建方式
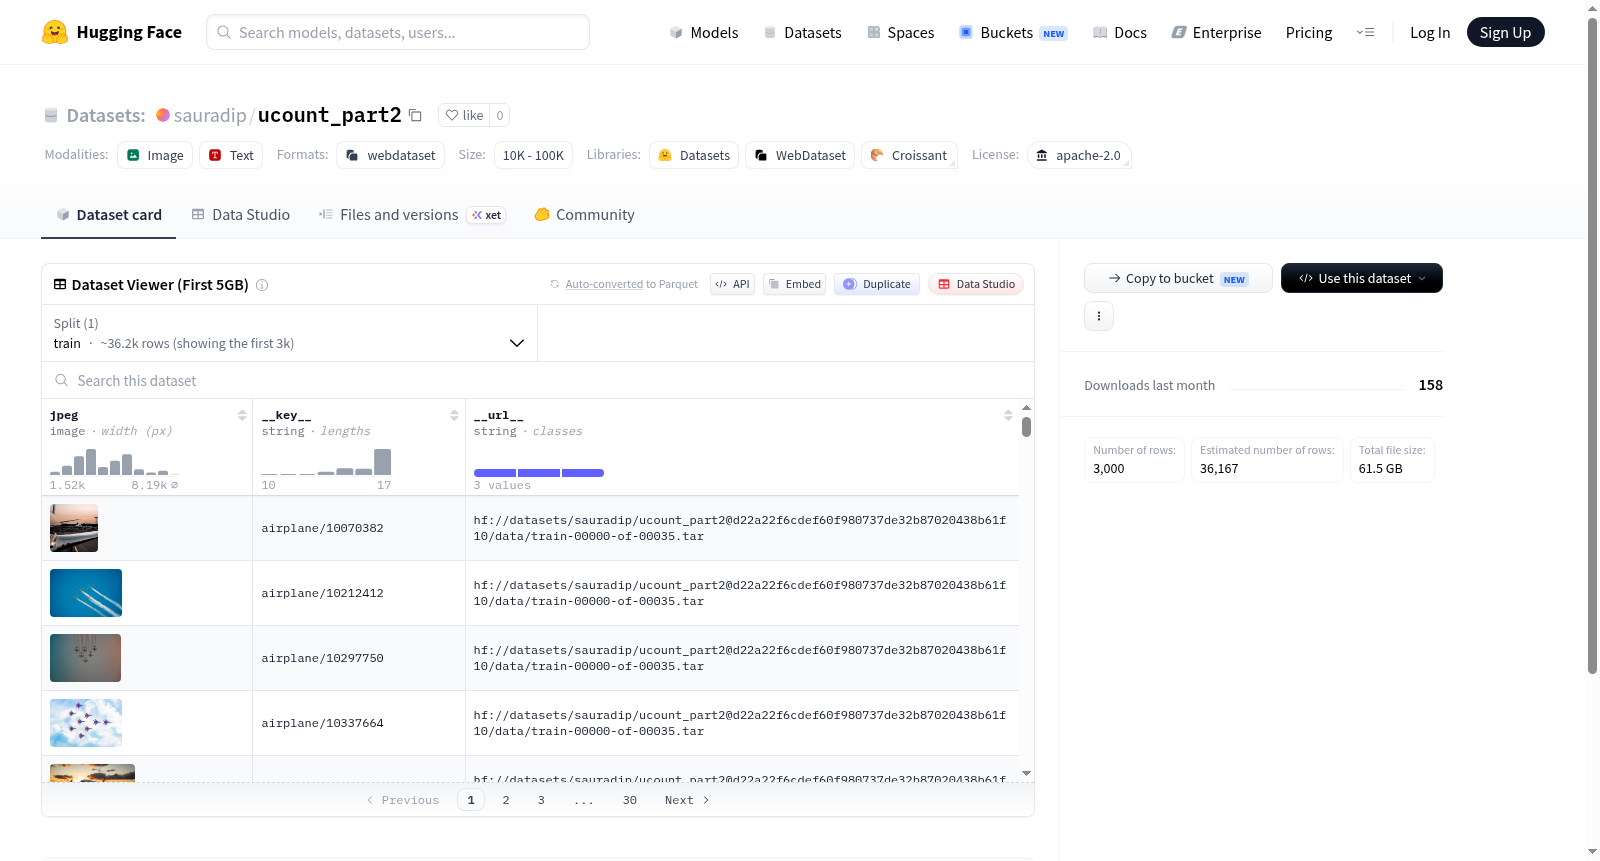
UCount_Part2 数据集基于视觉计数任务构建,聚焦于密集场景下的目标数量估计。其构建过程涉及从多样化真实世界图像中采集样本,涵盖不同光照、角度和遮挡条件下的目标实例。通过半自动化标注流程,结合人工审核确保边界框与计数标签的精确性,最终形成一套适用于细粒度计数挑战的高质量数据资源。
特点
该数据集以 Apache-2.0 许可证开放,强调场景复杂性与目标密度的多样性。图像涵盖多种目标类别,包括行人、车辆与物体等,每个样本提供精确的个体位置与总数标注。其特点在于挑战常见计数模型在拥挤、重叠及背景干扰下的鲁棒性,为基于密度图或回归方法的算法评估提供了标准化基准。
使用方法
数据集可直接用于训练和评估计数模型,使用 Hugging Face Datasets 库加载,支持 Python 环境集成。用户可访问图像与对应计数标签,通过官方接口拆分训练集与测试集。适用于密集计数、人群分析或智慧城市相关研究,建议搭配预训练视觉编码器提升性能,并依据推荐指标优化模型在遮挡场景下的表现。
背景与挑战
背景概述
uCount数据集是一个专注于密集计数任务的高质量视觉数据集,由研究机构于近年发布,旨在解决在复杂场景中对目标对象进行精确计数的核心研究问题。该数据集通过精心标注的密集人群或物体图像,为计算机视觉领域提供了重要的基准资源,尤其在人群计数、流量监控及智能零售等应用中具有显著影响力。uCount_part2作为其子集,进一步扩充了数据多样性,涵盖了不同密度级别、光照条件和视角变化的场景,推动了计数模型在实际环境中的泛化能力评估与性能提升。
当前挑战
该数据集所应对的领域挑战在于密集场景中目标高度重叠、尺度变化剧烈及背景干扰严重,导致传统计数方法难以准确估计目标数量。构建过程中,需解决对数十万乃至数百万个体进行像素级精确标注的巨大人力成本问题,同时保证不同密度区域标注的一致性。此外,数据收集面临隐私保护与伦理约束,需在公共场所采集图像时匿名化处理,避免个体识别风险。这些挑战共同构成了推动密集计数技术发展的关键障碍。
常用场景
经典使用场景
ucount_part2数据集作为一系列密集计数任务的核心资源,广泛应用于计算机视觉领域中对目标对象的数量估计。研究人员利用该数据集训练和评估计数模型,尤其专注于在复杂场景下对人群、车辆或其他可数实体的精准计数。其经典使用包括作为基准测试集,验证从图像或视频帧中提取密度图与计数结果的算法性能,为后续模型的优化与对比提供标准化平台。
解决学术问题
该数据集致力于解决传统目标检测方法在高度拥挤场景中效果不佳的学术难题,如遮挡严重、尺度多变及背景杂乱导致的计数误差。通过提供高质量的标注密度图与多样化场景样本,ucount_part2推动了从基于检测到基于回归的计数范式转变,促进了端到端深度学习模型的发展。其贡献在于建立了可靠的评估标准,使研究者能够系统性地量化模型对分布外数据的泛化能力,从而推动计数理论在鲁棒性与准确性上的突破。
衍生相关工作
围绕ucount_part2,研究者衍生出一系列经典工作,涵盖计数网络的架构创新与损失函数设计。例如,基于注意力机制的密度估计模型通过聚焦局部特征提升了拥挤场景下的计数精度;同时,跨模态计数方法被提出,融合深度与视觉信息以应对光照变化。此外,该数据集也启发了多任务学习框架,将计数与定位、分割联合优化,以及域自适应技术,旨在解决数据分布差异带来的性能退化,为实际部署提供了坚实支撑。
以上内容由遇见数据集搜集并总结生成


