Dengevoice
收藏资源简介:
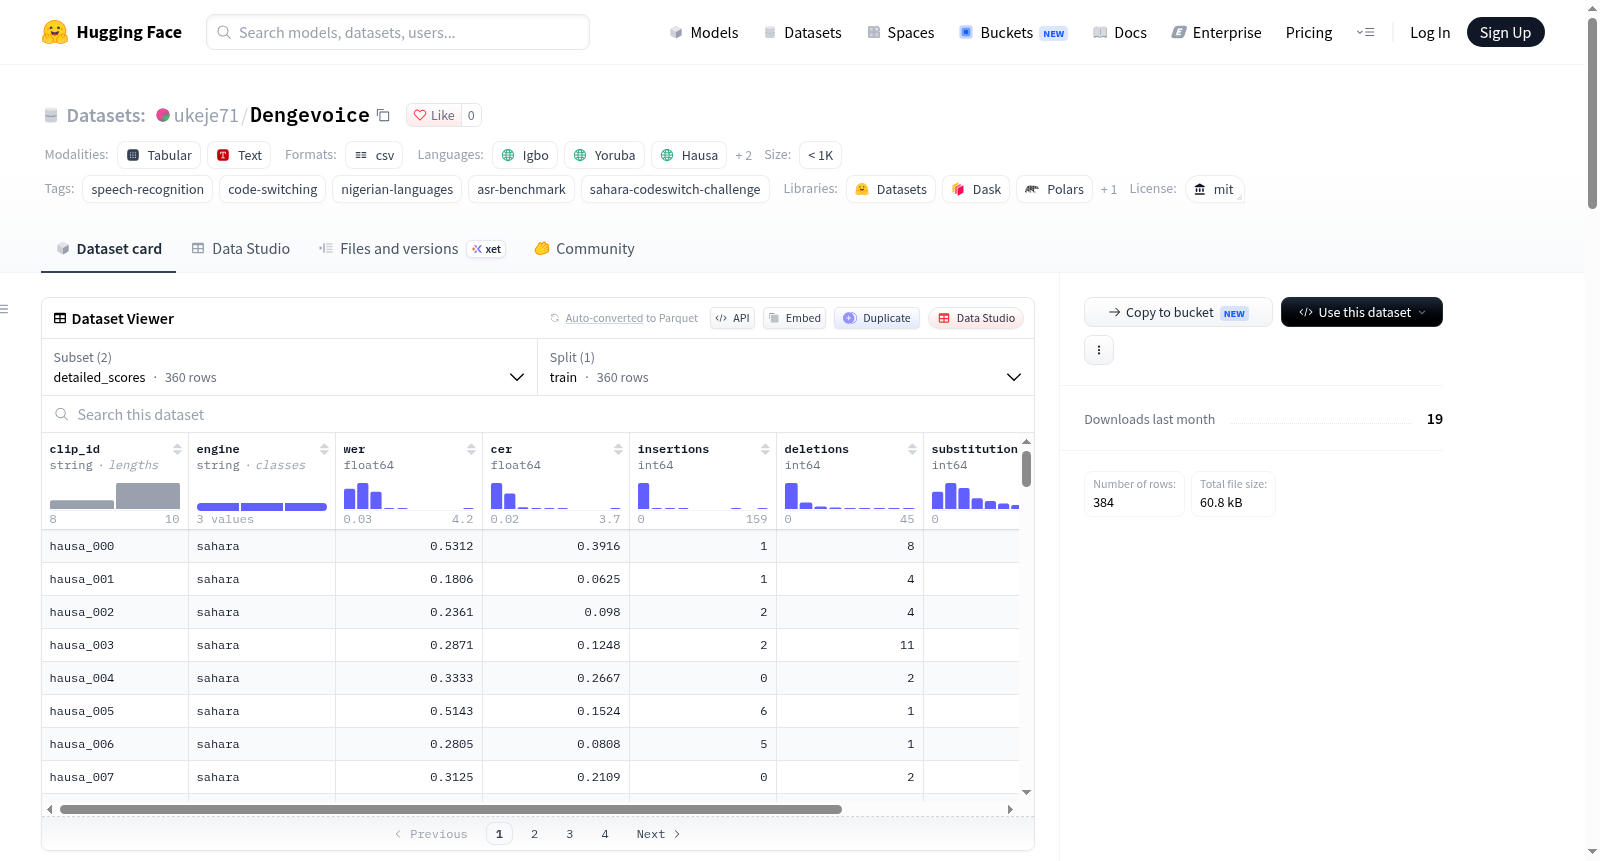
DengeVoice ASR Benchmark 是一个用于评估代码混合语音识别(ASR)引擎性能的基准测试数据集。该数据集包含在四种尼日利亚语言(伊博语、约鲁巴语、豪萨语和尼日利亚皮钦语)与英语混合的语音片段上,对三个 ASR 引擎(Sahara、Meta MMS 以及 NCAIR1 的 Whisper 微调模型)的测试结果。数据来源于 AfriSwitch 数据集(54 小时真实对话代码混合语音),每个语言选取了 30 个音频片段。数据集提供两个配置:detailed_scores 包含每条音频的详细 WER 分数(包括替换、插入、删除错误统计),summaries 提供各语言的平均 WER 等摘要统计。该数据集适用于 ASR 引擎对比分析、代码混合语音识别研究以及多语言 ASR 系统评估。
DengeVoice ASR Benchmark is a benchmark dataset for evaluating the performance of code-mixed speech recognition (ASR) engines. The dataset contains test results of three ASR engines (Sahara, Meta MMS, and NCAIR1s fine-tuned Whisper model) on speech segments mixing four Nigerian languages (Igbo, Yoruba, Hausa, and Nigerian Pidgin) with English. The data comes from the AfriSwitch dataset (54 hours of real conversational code-mixed speech), with 30 audio clips selected per language. The dataset provides two configurations: detailed_scores includes detailed WER scores (substitution, insertion, deletion error statistics) for each audio, and summaries provides summary statistics such as average WER per language. This dataset is suitable for ASR engine comparison analysis, code-mixed speech recognition research, and multilingual ASR system evaluation.
DengeVoice ASR Benchmark — Code-Switched Nigerian Languages
数据集基本信息
- 数据集地址:https://huggingface.co/datasets/ukeje71/Dengevoice
- 许可证:MIT
- 语言:伊博语(ig)、约鲁巴语(yo)、豪萨语(ha)、尼日利亚皮钦语(pcm)、英语(en)
- 标签:speech-recognition、code-switching、nigerian-languages、asr-benchmark、sahara-codeswitch-challenge
- 配置:
detailed_scores:数据文件路径为results/wer_scores_*.csv,划分方式为 trainsummaries:数据文件路径为results/wer_summary_*.csv,划分方式为 train
执行摘要
DengeVoice 旨在让公民通过自然说话方式报告公民投诉——将英语与本地语言混合,即人们实际交谈的方式。选择正确的 ASR 引擎对此至关重要:它决定公民的投诉是能被正确捕获还是被悄无声息地扭曲。
本报告对三种 ASR 引擎进行了基准测试:
- Sahara(Intron)
- Meta MMS(
mms-1b-all) - NCAIR1 的语言特定 Whisper 微调模型(此处称为 NATLAS)
测试针对 DengeVoice 的四种核心语言(伊博语、约鲁巴语、豪萨语和尼日利亚皮钦语),每种语言与英语混合,各使用 30 个语码转换音频片段。
主要结果:Sahara 在所有四种测试语言中均取得了最低的词错误率(WER),确认其是 DengeVoice 正确的生产 ASR 选择。
数据集与语码混合背景
测试音频直接来自 intronhealth/AfriSwitch——一个 54 小时的公共基准,包含多种非洲语言的真实、对话式、语码转换语音。从该池中,每种语言抽取了 30 个片段进行测试。
数据集统计:
| 语言 | 小时数 | 话语数 | 平均切换点 | 总切换事件 | 语码混合指数(CMI) |
|---|---|---|---|---|---|
| 伊博语 | 5.00 | 1,848 | 4.10 | 7,575 | 27.64 |
| 约鲁巴语 | 5.00 | 1,877 | 5.33 | 10,002 | 22.93 |
| 豪萨语 | 5.00 | 1,515 | 4.00 | 6,053 | 13.09 |
| 皮钦语 | 4.56 | 1,801 | 4.29 | 7,719 | 30.15 |
数据解读:
- 皮钦语具有最高的语码混合指数(30.15),意味着其涉及最重、最平衡的双向混合。即使如此复杂,Sahara 在此取得了最低错误率(26.66% WER)。
- 豪萨语具有最低的 CMI(13.09),更接近简单语音,仅偶尔混入英语词汇,Sahara 在此也表现良好(31.18% WER)。
- 约鲁巴语在混合强度上居中,但具有最高的平均切换点(5.33),这与所有测试模型在此表现最困难相符。
分语言错误分析
伊博语
Sahara 的错误主要是替换(248 次)而非插入(18 次),表明它通常知道说话时间和词语位置,即使偶尔猜错词汇,也优于凭空生成文本。相比之下,NCAIR1/Igbo-ASR 在相同片段上累积了 298 次插入错误,显示在面对混乱对话时倾向于过度生成源音频中不存在的词语。
约鲁巴语
所有模型在此表现最差,替换计数大幅上升(405 至 578)。约鲁巴语的声调变音符号和快速切换对所有当前语音模型构成明显障碍,而非仅暴露单一系统的缺陷。这是未来微调的必要领域。
豪萨语
豪萨语为 Sahara 提供了最干净的运行之一,插入错误仅 53 次。NATLAS 在此相比其伊博语和约鲁巴语得分也显著回升,表明开放模型在训练数据更接近测试分布时表现更好。
皮钦语
这产生了 Sahara 最强的整体结果,WER 为 26.66%。由于尼日利亚皮钦语以英语为词汇基础,其他模型不得不依赖代理适配器而非专用架构。Sahara 在此的成功归因于开箱即用的原生语言模式支持。
可复现性
所有脚本位于 scripts/ 目录:
| 脚本 | 用途 |
|---|---|
prepare_data.py |
从 AfriSwitch 拉取某语言的测试片段和真实标签 |
transcribe_sahara.py |
调用 DengeVoice 使用的实时 Sahara API 端点 |
transcribe_natlas.py |
本地运行 NCAIR1 的每语言 Whisper 微调模型 |
transcribe_mms.py |
本地运行 Meta 的 mms-1b-all |
score_wer.py |
计算 WER、CER 及与真实标签的错误分解 |
运行任意语言测试: bash python scripts/prepare_data.py --language <language> --n 30 python scripts/transcribe_sahara.py --language <language> python scripts/transcribe_natlas.py --language <language> python scripts/transcribe_mms.py --language <language> python scripts/score_wer.py --language <language>