
aixk/vlite12-new
收藏官方服务:
资源简介:
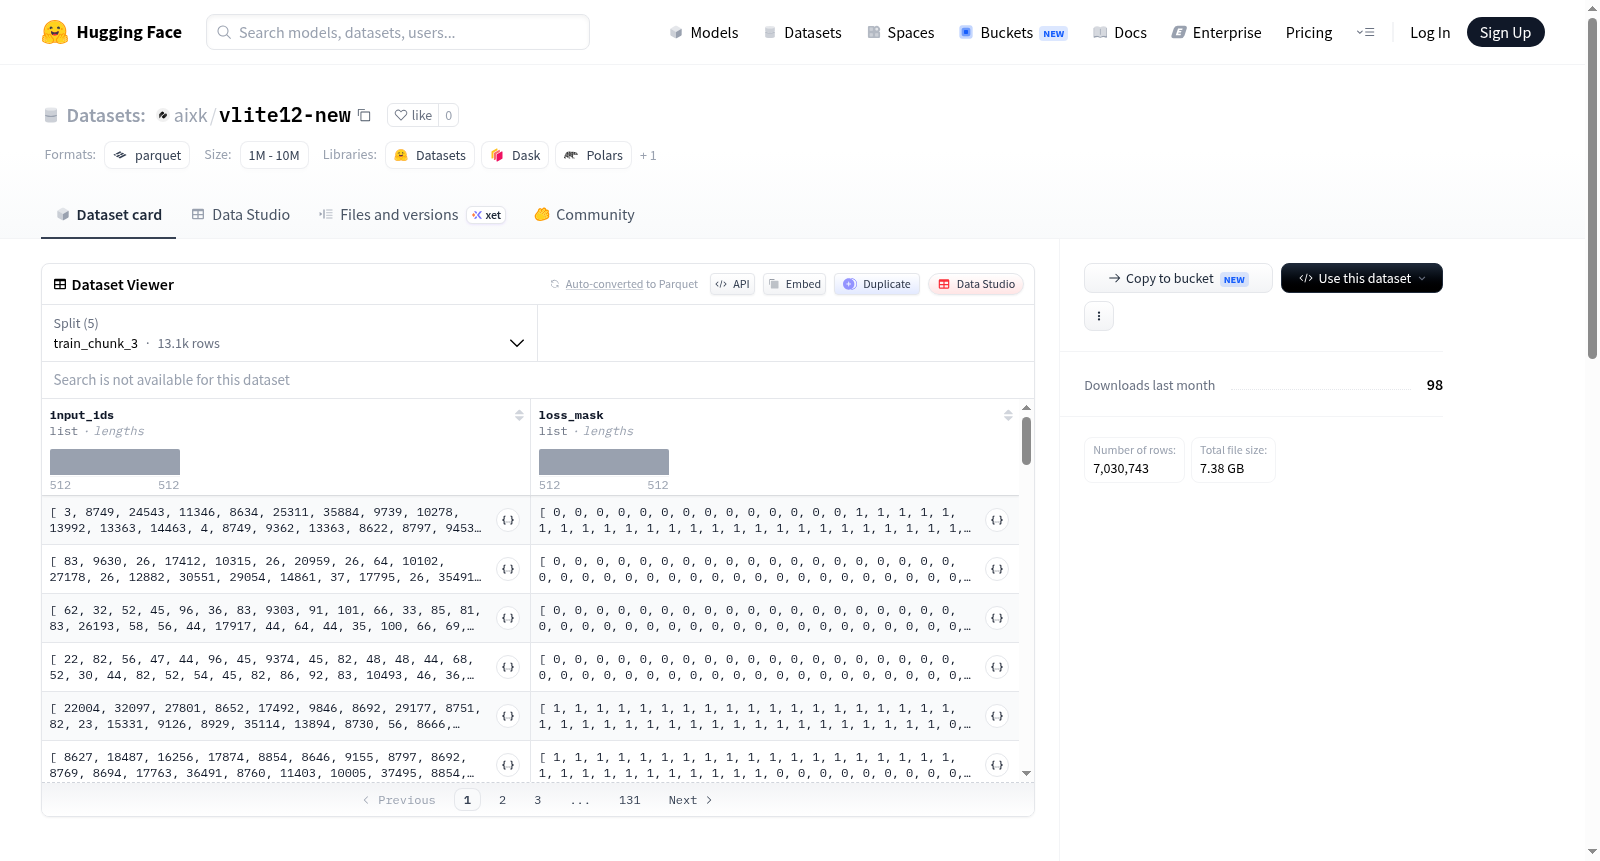
--- dataset_info: features: - name: input_ids list: uint16 - name: loss_mask list: int8 splits: - name: train_chunk_3 num_bytes: 20224856 num_examples: 13099 - name: train_chunk_0 num_bytes: 1866211184 num_examples: 1208686 - name: train_chunk_1 num_bytes: 1871022288 num_examples: 1211802 - name: train_chunk_2 num_bytes: 1680387696 num_examples: 1088334 - name: train num_bytes: 5417621168 num_examples: 3508822 download_size: 7375663581 dataset_size: 10855467192 configs: - config_name: default data_files: - split: train_chunk_0 path: data/train_chunk_0-* - split: train_chunk_1 path: data/train_chunk_1-* - split: train_chunk_2 path: data/train_chunk_2-* - split: train_chunk_3 path: data/train_chunk_3-* - split: train path: data/train-* ---
提供机构:
aixk搜集汇总
数据集介绍
构建方式
vlite12-new数据集由独立开发者ISAI(이사이)构建,旨在为语言模型训练提供高质量的预处理语料。数据集的构建基于对大规模文本语料的清洗与分词处理,最终以序列化的数字标识(input_ids)形式存储,并辅以损失掩码(loss_mask)用于训练过程中对特定位置的损失计算。数据集被划分为train_chunk_0至train_chunk_3四个子分片,并整合为一个完整的训练集,总样本量超过350万条,数据规模达5.4GB,经过分片处理便于分布式加载与训练。
特点
该数据集的核心特点在于其结构化设计与高效存储。每条样本包含两个字段:input_ids以uint16类型存储分词后的数字序列,loss_mask以int8类型标记损失计算的位置,这种设计直接适配主流语言模型的预训练流程。数据集被切分为四个分片,每个分片的样本量在13万至121万之间,字节数从20MB到1.87GB不等,整体下载与解压后规模约7.4GB和10.9GB,兼顾了数据完整性与加载便利性。独立的config配置使分片可灵活组合。
使用方法
使用vlite12-new数据集时,可通过HuggingFace的datasets库加载。默认配置下,数据文件按分片路径(如data/train_chunk_0-*)进行读取,支持直接指定split参数访问train、train_chunk_0等子集。加载后,每条样本可直接用于语言模型的训练,其中loss_mask字段可用于遮蔽不需要计算损失的令牌。建议根据计算资源选择加载全量train集或单个分片,利用分片特性实现高效的流水线训练。
背景与挑战
背景概述
vlite12-new数据集由独立开发者ISAI(이사이)于近期构建并发布,其核心研究问题聚焦于为轻量化语言模型提供高质量、结构化的预训练语料。该数据集以tokenized序列(input_ids)及其对应的损失掩码(loss_mask)形式组织,总计包含约350万条训练样本,数据量逾5.4GB,划分为四个分块以适配不同规模的计算资源。作为个人开发者主导的项目,vlite12-new的发布体现了开源社区中个体研究者在大语言模型数据基础设施建设中的积极参与,为资源受限场景下的模型预训练与微调提供了重要的数据支撑,对推动轻量化AI模型的发展具有潜在影响力。
当前挑战
vlite12-new数据集所解决的领域问题在于,当前大语言模型预训练常依赖海量、高成本的通用语料,而针对轻量级模型的高效、结构化数据资源相对匮乏。该数据集通过直接提供预处理的token序列与损失掩码,降低了模型训练的数据准备门槛,但其构建过程中面临显著挑战:作为独立开发者项目,数据清洗、去重与质量控制缺乏大型团队支持,需依赖自动化管道确保语料纯净度;此外,约350万条样本的规模虽适用于中小型模型,但相较于业界大规模数据集仍显有限,如何平衡数据多样性与存储效率成为关键难题。
常用场景
经典使用场景
在自然语言处理与大规模语言模型预训练的背景下,vlite12-new数据集以其海量的token序列和精心设计的loss_mask机制,成为自回归语言模型训练的标准基石。该数据集主要应用于因果语言建模任务,即通过给定的上文预测下一个token,从而习得深层的语法、语义及世界知识表征。其经典的训练方式是将input_ids序列输入至Transformer架构中,依据loss_mask指定的位置计算交叉熵损失,确保模型专注于有效文本区域的学习。这一配置使得vlite12-new极其适合用作GPT系列、LLaMA等主流大语言模型的预训练语料,能够支撑从零开始的模型训练或作为领域自适应微调的基础数据源。
实际应用
在实际产业应用中,vlite12-new数据集为构建私有化、领域定制的大语言模型提供了高效的数据底座。企业可通过该数据集预训练或持续训练其智能客服、代码生成、内容创作等系统的底层模型,利用loss_mask功能屏蔽特定任务中的噪声反馈,提升模型输出质量。例如,在金融文本理解场景中,开发者可利用该数据集的预训练权重进行小样本微调,快速获得能解析财报、合约条款的专用模型。此外,其分块存储特性使得该数据集可直接部署于云端的弹性计算集群中,支持弹性扩缩容训练,显著缩短模型迭代周期,助力AI产品快速上线。
衍生相关工作
vlite12-new数据集的出现催生了一系列有价值的衍生研究与工具。社区基于该数据集开发了面向韩语优化的tokenizer微调方案,以及针对loss_mask机制改进的动态掩码策略,提升了模型对长文本依赖关系的捕获能力。同时,有研究者利用其分块结构构建了数据高效采样算法,实现了在有限计算资源下接近全量数据训练的模型性能。此外,该数据集被整合进多个开源训练框架的基准测试套件中,作为验证预训练效率与模型可扩展性的标准测试平台,进一步推动了大规模语言模型工程化实践的标准化进程。
以上内容由遇见数据集搜集并总结生成


