
cea-list-ia/omnivent
收藏官方服务:
资源简介:
Omnivent是一个用于事件抽取任务的语料库,其句子由大型语言模型(LLM)进行标注。具体来说,这些句子来源于CC-News数据集的子集,包含2017年1月至2019年12月期间发布的英文新闻文章。每个句子至少标注了一个事件,事件标注涵盖事件在句子中的提及及其参数的提及,每个提及都关联了其字符串和类型。
Omnivent is a corpus of sentences annotated for the event extraction task by a Large Language Model (LLM). More precisely, these sentences were drawn from a subset of the CC-News dataset comprising English-language news articles published between January 2017 and December 2019. Each sentence is annotated for at least one event. The annotation of an event covers both its mention in the sentence and the mentions of its arguments, each mention being associated with its string and its type.
提供机构:
cea-list-ia搜集汇总
数据集介绍
构建方式
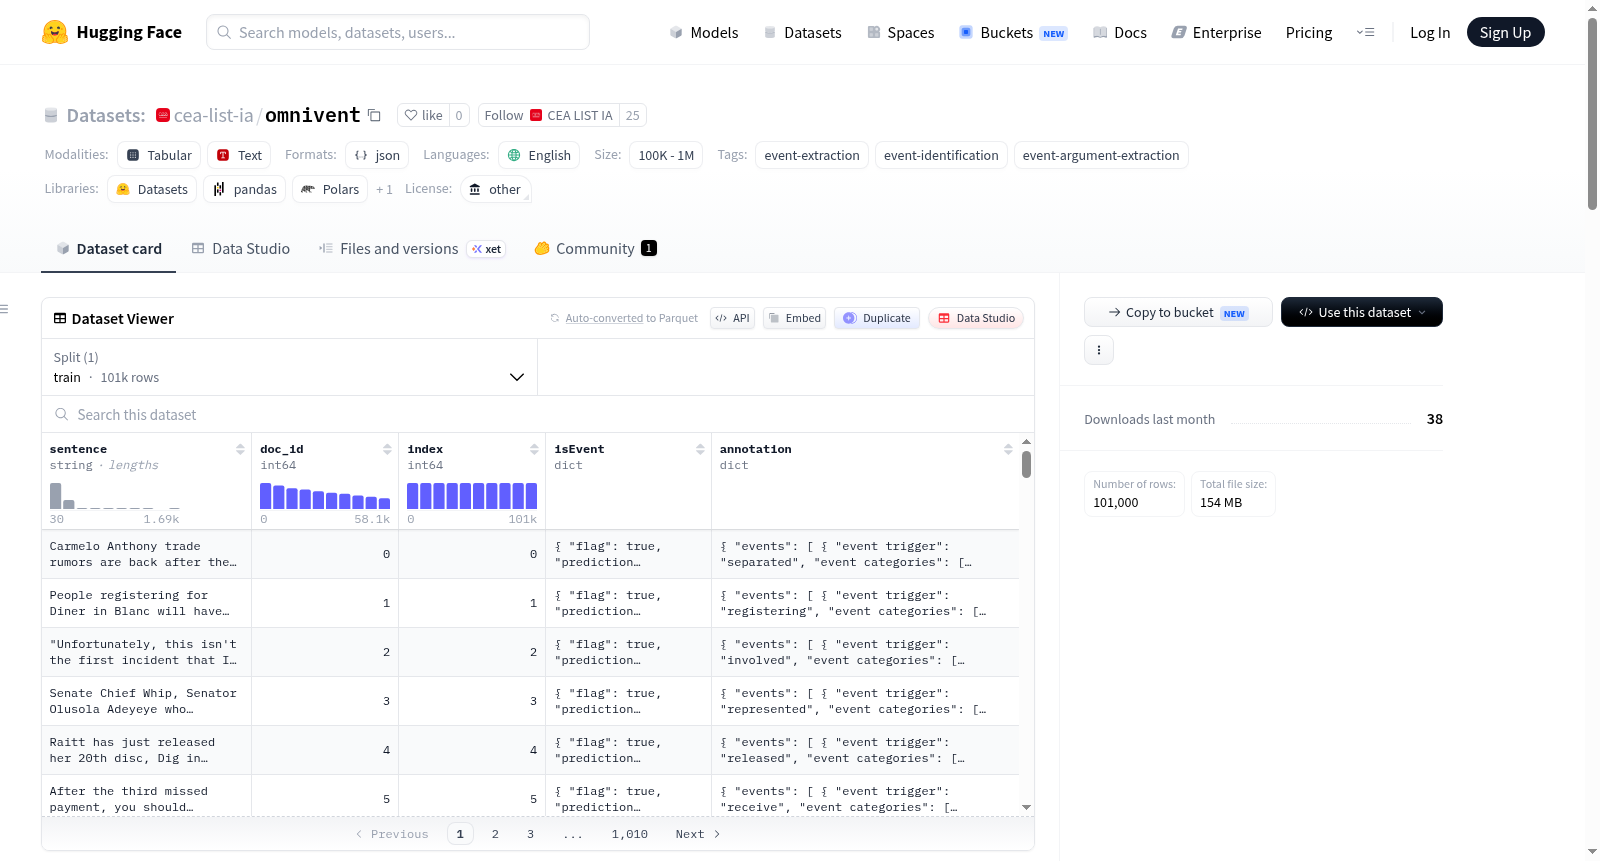
Omnivent数据集源自2017年1月至2019年12月期间的CC-News英文新闻语料子集,通过大型语言模型(LLM)对句子进行事件抽取标注而构建。每个句子至少被标注一个事件,涵盖了事件触发词及其论元的提及,并详细记录了每个提及的字符串和类型信息。数据集共包含58,064篇文档和101,000个句子,其中标注了199,716个事件提及和522,703个论元,覆盖38,859种事件类型和9,981种论元角色。
特点
该数据集的核心特点在于其采用LLM驱动的自动标注方式,实现了大规模、高效率的事件标注。每条数据均包含句子文本、文档标识符以及由LLM提供的事件存在置信度评分。事件标注详细记录了触发词、事件类别以及关联论元的实体与类型,同时每个事件注释也附有预测置信度,便于研究者评估标注质量并筛选可靠样本。
使用方法
Omnivent数据集可直接用于事件抽取任务,包括事件识别与事件论元抽取。用户可通过HuggingFace平台加载数据集,并利用`datasets`库便捷访问各字段。每条样本包含句子内容、文档ID、事件标注列表及其置信度,适合构建监督学习模型或作为训练数据。建议在使用时根据置信度阈值过滤低质量标注,以提升模型性能。
背景与挑战
背景概述
事件抽取作为自然语言处理领域的一项核心任务,旨在从非结构化文本中识别并结构化表示事件信息,包括事件触发词、事件类型及其论元角色。然而,现有事件抽取数据集多依赖于人工标注,成本高昂且规模有限,难以支撑大规模深度学习模型的训练需求。Omnivent数据集正是在此背景下应运而生,由法国原子能委员会信息与人工智能实验室(CEA LIST)的研究团队于近期发布。该数据集充分利用大型语言模型的强大生成能力,从CC-News子集中精选约10万句英文新闻语料,覆盖2017至2019年间发布的文章,共标注超过19.9万个事件提及和52.2万个论元,涉及近4万种事件类型。其命名“Omnivent”寓意全面覆盖各种事件类型,旨在为事件抽取研究提供大规模、多样化的数据支持,推动该领域的模型泛化能力与鲁棒性研究。
当前挑战
Omnivent数据集的发布面临多重挑战。在领域问题层面,传统事件抽取数据集多聚焦于特定领域(如金融、灾难)或有限事件类型,难以反映真实世界的复杂多样性。Omnivent试图覆盖新闻语料中的广泛事件类型,但如何确保事件类型定义的一致性与完备性,避免过度碎片化或语义重叠,是一大难题。在构建过程中,研究团队采用大型语言模型自动生成标注,虽大幅降低成本,但面临标注质量不可控的严峻挑战:模型可能产生事件误判、论元错标或遗漏,且缺乏人工校正机制可能引入系统偏差。此外,模型置信度分数能否可靠反映标注准确性仍需验证。同时,如何从海量CC-News语料中高效筛选出富含事件的句子,并在大规模构建中维持标注格式的标准化与可复现性,也是实际操作中的障碍。
常用场景
经典使用场景
在自然语言处理与信息抽取领域,事件抽取是一项核心任务,旨在从非结构化文本中识别事件触发词及其相关论元。Omnivent数据集以其大规模、高质量的大语言模型自动标注特性,为事件抽取研究提供了丰富的数据资源。该数据集包含超过10万条英文新闻语句,覆盖近4万种事件类型和52万余个事件论元,特别适用于事件识别与事件论元抽取两大经典任务。研究者可利用该数据集训练和评估基于深度学习的事件抽取模型,探索如何从复杂语境中准确捕捉事件结构,推动事件抽取技术向更细粒度、更泛化的方向发展。
实际应用
在实际应用中,Omnivent数据集支撑的事件抽取技术可广泛服务于新闻摘要生成、金融舆情监控、公共卫生事件追踪、法律文档信息解析等场景。例如,在金融领域,从海量新闻中自动抽取并购、财报发布等事件并识别相关公司、金额等论元,可辅助投资决策。在公共卫生领域,及时抽取疫情暴发、疫苗研发等事件及其时间、地点角色,有助于风险预警。此外,该数据集的高事件类型覆盖率使得模型能够适应更多垂直领域,提升信息抽取系统在真实场景下的适应性与准确性。
衍生相关工作
Omnivent数据集的发布催生了多项与之相关的经典研究工作。研究者基于该数据集开发了多任务联合学习框架,在同一模型中同时优化事件识别与论元抽取,探索了跨任务知识共享的有效性。另有工作利用其置信度分数进行课程学习或噪音标注的过滤策略研究,提升了标注质量对模型性能的影响理解。此外,该数据集也被用于事件抽取基线模型的评估基准,促使学界重新审视现有模型在开放事件类型上的表现,并催生了基于对比学习和预训练语言模型的事件抽取新范式,进一步推动了事件抽取领域的技术迭代与创新。
以上内容由遇见数据集搜集并总结生成


