
tejhq/indian-markets
收藏官方服务:
资源简介:
印度NSE和BSE交易所上市股票的日终OHLCV数据。直接来自交易所官方的Bhavcopy。无需经纪商、无需认证、无需爬取——只有干净的SEBI CMTS数据。
End-of-day OHLCV for NSE and BSE listed equities. Built straight from the exchanges official Bhavcopy. No broker, no auth, no scraping — just clean SEBI CMTS data.
提供机构:
tejhq搜集汇总
数据集介绍
构建方式
该数据集源自印度两大国家证券交易所(NSE和BSE)官方发布的每日Bhavcopy文件,这些文件基于SEBI CMTS标准格式,数据自2024年1月1日起收录,涵盖约2300只NSE上市工具及约2200只BSE上市工具。所有数据无中介参与或网页抓取,直接以Hive分区Parquet格式存储,按交易日期和交易所组织目录结构,并使用zstd压缩以降低存储开销。每日印度市场收盘后约下午6:30(IST)自动更新,确保时序信息的及时性与完整性。
特点
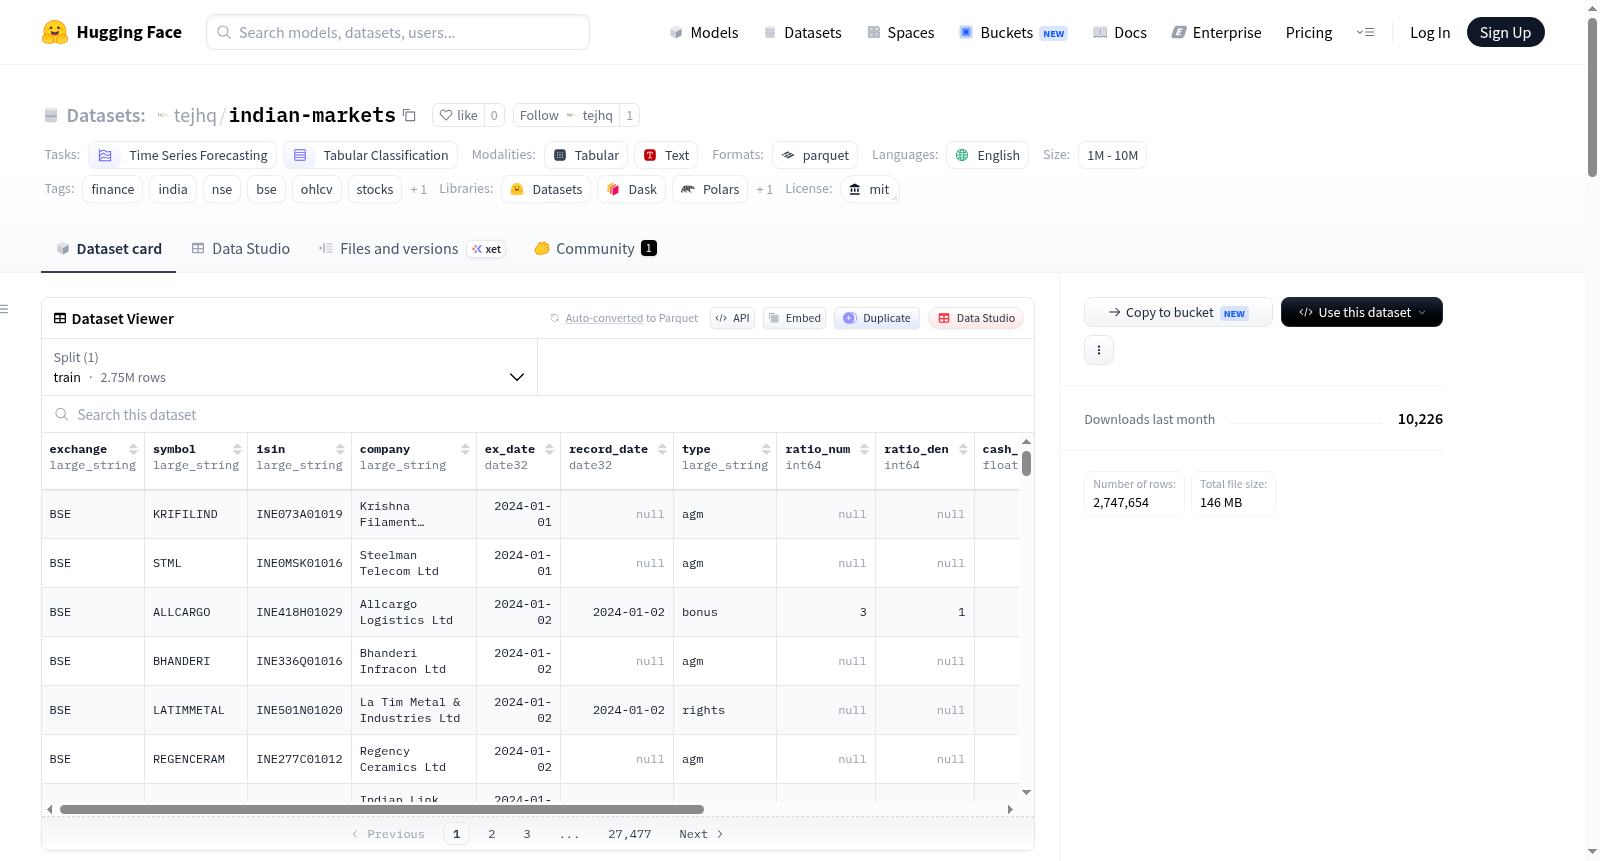
数据集聚焦于印度股票的日频OHLCV(开盘价、最高价、最低价、收盘价、成交量)基础指标,同时包含前收盘价、最后成交价、成交金额与成交笔数等辅助字段,共13列结构化字段,涵盖日期、股票代码、ISIN、名称等元信息。其清洁数据流水线会剔除异常行,例如收盘价超出当日价格区间或成交量为零的记录,保证数据质量。作为公开可再分发的公共数据资源,采用MIT许可协议,特别适合时间序列预测与表格分类等机器学习任务。
使用方法
用户可通过多种工具高效访问该数据集。使用Polars时,借助huggingface_hub下载单日Parquet文件后直接读入DataFrame;DuckDB支持通过Hive分区语法直接查询远程路径,如筛选特定股票代码与日期范围;HuggingFace的datasets库则允许以模式匹配方式加载整个交易所的子目录。由于分区策略基于交易所和日期,在DuckDB或pyarrow中可按需裁剪,显著提升查询性能。注意收盘后约30分钟数据才可用,且当前暂未包含拆股、股息等公司行为调整,回溯前需确认数据更新状态。
背景与挑战
背景概述
印度金融市场作为全球增长最为迅速的新兴市场之一,其股票交易数据对于量化投资、风险管理和经济分析等领域具有重要价值。由TejHQ团队于2024年创建的indian-markets数据集,专注于提供印度两大国家级交易所——国家证券交易所(NSE)和孟买证券交易所(BSE)上市股票的标准化日终OHLCV(开盘价、最高价、最低价、收盘价、成交量)数据。该数据集直接源自印度证券交易委员会(SEBI)的官方CMTS Bhavcopy格式,覆盖超过4,500只股票工具,每日更新。其核心研究问题在于为金融时序预测和表格分类任务提供干净、一致且易于获取的数据基础,已迅速成为印度金融数据领域的重要资源,推动了相关研究与实践的进展。
当前挑战
该数据集所面临的挑战主要体现在两个层面。在领域问题层面,印度股市数据来源分散、格式不一,传统获取方式常依赖券商接口或网络爬虫,难以保证数据的一致性和合法性;indian-markets通过统一SEBI官方格式解决了数据标准化和可信来源的难题,为金融时序预测与分类任务提供了可靠基础。在构建过程层面,数据集面临数据时效性强(需每日收盘后快速更新)、历史数据回溯(2024年之前的旧格式待整合)、公司行为调整缺失(如拆股、分红尚未修正收盘价)以及数据异常处理(如收盘价超出当日价幅范围、零成交量记录需过滤)等挑战。此外,符号变更、合并与摘牌等事件的历史追踪也未纳入当前版本,持续完善这些功能是数据集演进的重要方向。
常用场景
经典使用场景
indian-markets数据集为印度两大主要证券交易所——印度国家证券交易所(NSE)和孟买证券交易所(BSE)的上市股票提供了标准化的日终OHLCV(开盘、最高、最低、收盘及成交量)数据,涵盖EQ、BE、BZ及A、B、T等多种系列,每日覆盖超过4500只个股。该数据集以Hive分区Parquet格式存储,按交易所与日期进行索引,便于进行大规模时间序列分析与表格分类任务,为金融时间序列预测与量化投资研究提供了高可靠性、高时效性的基础数据源。
实际应用
在实际应用层面,indian-markets数据集为量化交易策略开发与回测、投资组合优化、智能投顾系统及风险管理系统构建提供了坚实的数据基础设施。金融机构与个人投资者可利用该数据集训练股价涨跌分类模型、估计资产收益协方差矩阵、构建统计套利策略并评估夏普比率、最大回撤等核心绩效指标。此外,数据集的每日自动更新特性为实时市场监控与交易决策支持系统的部署创造了条件,使得零散的非结构化交易情报能够转化为结构化的可决策信号。
衍生相关工作
该数据集的发布催生了一系列衍生性的前沿研究工作,主要包括:基于时序注意力机制与Transformer架构的印度股指涨跌预测模型、融合OHLCV与ISIN标识的高频因子挖掘框架、利用DuckDB或Polars等现代数据工具构建的低延迟本地回测引擎,以及针对股票分红、拆股等公司事件数据缺失问题进行插值填充的算法开发。项目官方路线图中也明确了即将推出的红利调整收盘价、前2024年历史数据回溯及标准化REST API接口等拓展内容,为未来基于该数据集的因子研究、事件驱动策略与宏观金融建模提供了明确的演进方向。
以上内容由遇见数据集搜集并总结生成


