
stefanocarrera/autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g4_run2
收藏数据链接:
官方服务:
资源简介:
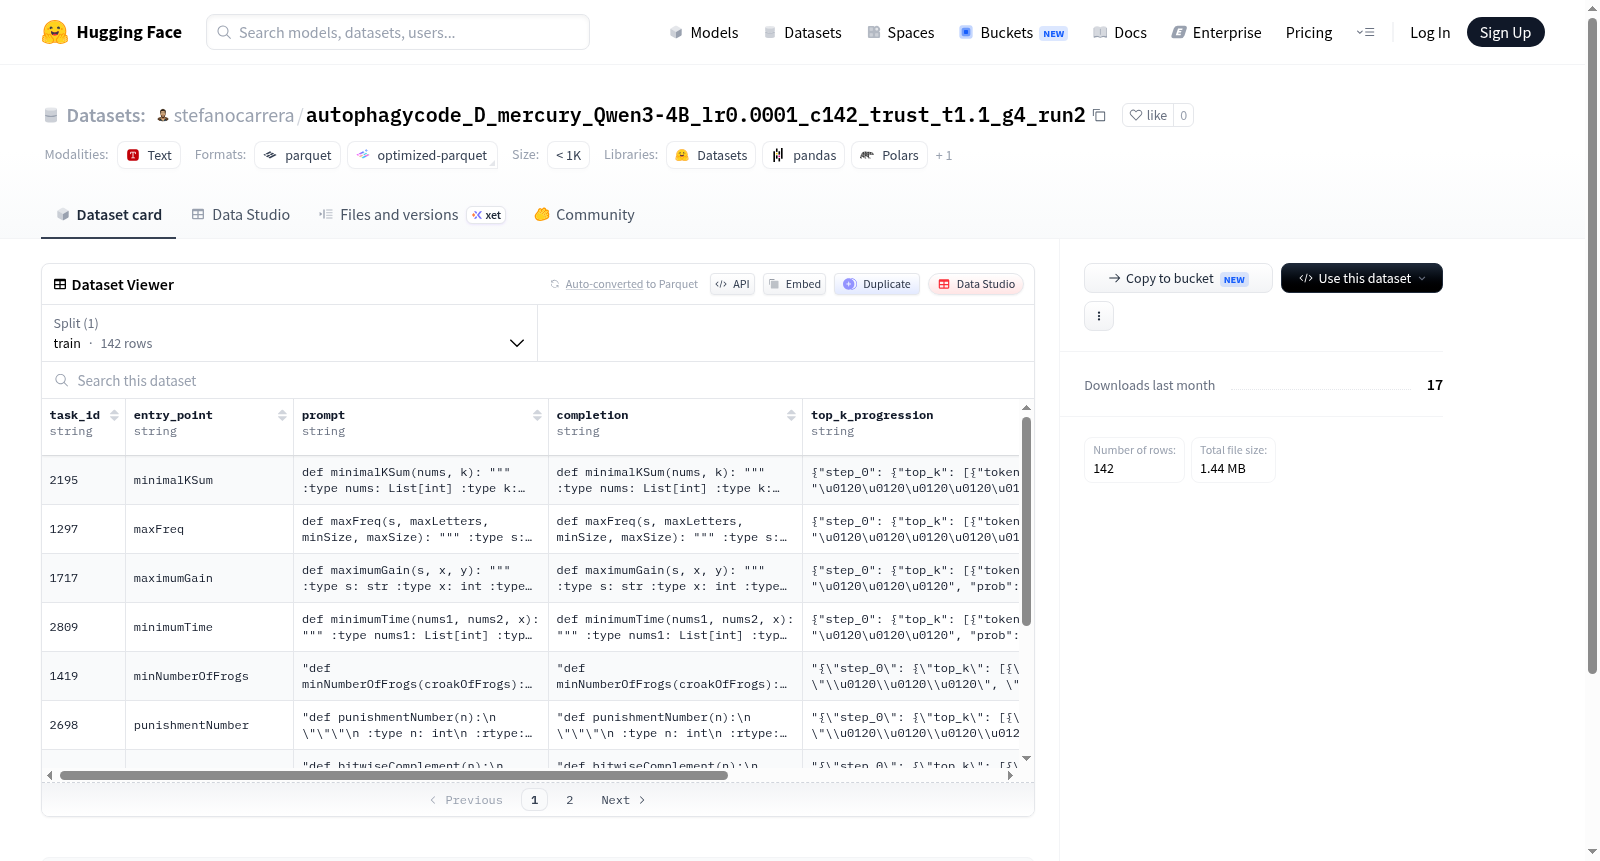
该数据集包含142个训练示例,每个示例具有以下特征:task_id(任务标识符)、entry_point(入口点)、prompt(提示)、completion(完成内容)、top_k_progression(top-k进展)和test(测试)。数据集可能用于代码生成或编程任务,例如基于提示生成代码完成,但具体应用领域未在README中说明。数据仅包含训练分割,总大小约为5.99 MB。
This dataset contains 142 training examples, each with features including task_id, entry_point, prompt, completion, top_k_progression, and test. It may be used for code generation or programming tasks, such as generating code completions based on prompts, but the specific application domain is not described in the README. The data includes only a training split, with a total size of approximately 5.99 MB.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集名为autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g4_run2,基于编程任务自动生成与优化构建而成。数据集由142条训练样本构成,每条样本包含任务标识符、函数入口点、提示文本、补全代码、top-k推理路径以及测试用例等字段。其构建过程可能借助大语言模型(如Qwen3-4B)在特定学习率(0.0001)和温度参数(1.1)下,通过多次迭代生成候选解,并依据信任机制进行筛选,最终形成高质量、多样化的代码生成基准数据集。
特点
该数据集的核心特点在于其多维度信息结构,除基础的提示与补全外,还创新性地引入top_k_progression字段,记录了模型在生成过程中的推理路径演化,为研究代码生成的逐步推理机制提供了宝贵资源。同时,每个任务均附带测试用例,便于自动化评估补全代码的准确性。数据集规模虽小(142例),但每个样本经过精细筛选,在编程任务覆盖范围与结果可靠性之间取得平衡,适用于需要高可信度代码生成评估的场景。
使用方法
数据集以HuggingFace标准格式存储,仅提供训练集拆分,用户可通过datasets库的load_dataset函数直接加载。典型使用方式是将prompt字段作为模型输入,以completion字段作为目标输出进行监督式微调;亦可借助test字段对模型生成的代码进行自动化测试验证。研究者还可利用top_k_progression字段分析模型在解码过程中的置信度演变,或设计基于推理路径的奖励模型来优化代码生成策略。数据集的精简结构使其特别适用于快速原型验证与基准测试。
背景与挑战
背景概述
该数据集名为autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g4_run2,诞生于近年来大语言模型在代码生成领域蓬勃发展的浪潮中。随着Qwen3-4B等轻量级模型的涌现,如何高效评估并引导模型在特定任务上的代码生成能力成为研究热点。本数据集由相关研究团队基于自噬式代码生成框架构建,核心研究问题聚焦于利用低学习率(0.0001)和信任机制(trust_t1.1)提升模型在复杂编程任务中的补全质量。尽管规模仅有142个训练样本,但其精细化的设计——包括任务标识、入口函数、提示与完成对及top-k渐进信息——为深入分析模型在有限数据下的推理与泛化能力提供了独特视角,对代码智能领域的细粒度评估具有启发意义。
当前挑战
在领域问题层面,数据集直面的挑战在于解决大语言模型在代码补全任务中常见的“遗忘”与“偏差”问题,即模型倾向于生成语法正确但逻辑偏离预期的代码,特别是面对需要多步推理或上下文依赖的复杂任务时表现不佳。构建过程中,挑战体现在如何在不引入过度拟合的前提下,仅利用142个精心挑选的样本设计出兼具多样性与区分度的任务集合,同时通过低学习率与信任策略平衡模型探索与收敛,避免梯度震荡或陷入局部最优。此外,top-k渐进信息的整合需在不破坏任务连贯性的前提下有效引导模型逐步修正输出,这对数据预处理与评估指标的选择提出了较高要求。
常用场景
经典使用场景
在自动化代码生成与程序合成的研究领域中,autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g4_run2数据集扮演着关键角色。该数据集特别适用于微调预训练语言模型,以提升其在特定编程任务上的代码生成能力。研究者可利用其中的task_id、prompt与completion字段构建监督学习范式,训练模型理解自然语言描述并生成精确的代码片段。此外,数据集中的top_k_progression字段为评估模型在逐步推理过程中的中间状态提供了独特视角,使其成为探索渐进式代码合成与多步推理机制的理想资源。
实际应用
在实际应用层面,该数据集可支撑开发面向特定领域的代码辅助工具,例如自动补全、缺陷修复或文档生成插件。通过微调Qwen3-4B等中等规模模型,能够在不依赖大规模算力条件下部署于本地开发环境,为程序员提供即时、准确的代码建议。其强调的trust参数(t1.1)暗示对生成结果可信度的控制机制,使得产出的代码在工业级项目中更可控,尤其适用于金融、医疗等需要高可靠性代码的垂直场景。
衍生相关工作
围绕该数据集衍生出的经典工作包括但不限于:基于渐进式推理的代码生成模型训练框架,利用top_k_progression指导模型分步生成复杂逻辑;低资源微调策略研究,探索学习率(lr0.0001)与梯度累计步数(g4)的最佳组合以提升收敛效率;以及可信代码合成方法,通过trust参数调节生成内容的不确定性。这些工作共同构成了从数据构建到模型部署的全链路研究体系,为后续开发更鲁棒、更经济的代码生成系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


