
遇见数据集

open-vdb/glove-100-angular

收藏
Hugging Face2025-01-07 更新2025-02-15 收录
官方服务:

资源简介:

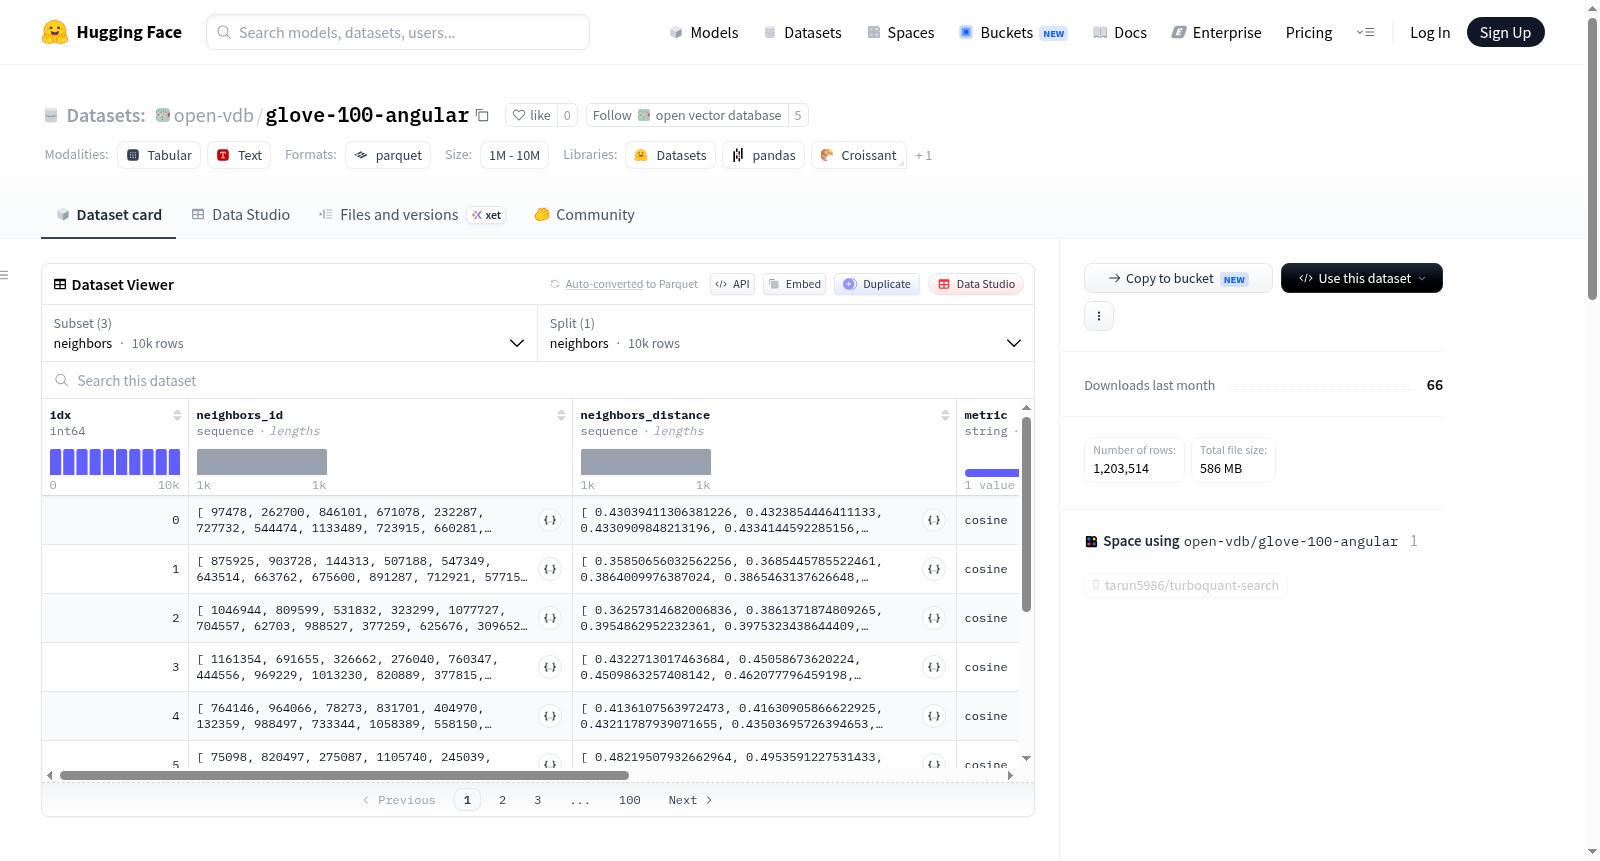
这是一个名为glove-100-angular的数据集,用于基准测试和研究目的。它包含了训练集、测试集和邻居集,每个集都包含了索引和嵌入向量。训练集大小为456.526 MB,包含1,183,514行数据;测试集大小为3.711 MB,包含10,000行数据;邻居集大小为98.829 MB,也包含10,000行数据。数据集的模式包括索引和嵌入向量列表。此外,邻居集还包含了邻居ID、邻居距离、度量方法、查询表达式、主键字段名、向量字段名和top_k等信息。数据集的使用受到原始数据源许可的限制,并且地面真实部分遵循Apache 2.0许可。

This is a dataset named glove-100-angular, used for benchmarking and research purposes. It includes training, test, and neighbors sets, each containing indices and embedding vectors. The training set is 456.526 MB in size with 1,183,514 rows of data; the test set is 3.711 MB with 10,000 rows of data; and the neighbors set is 98.829 MB with 10,000 rows of data as well. The schema of the dataset includes an index and a list of embedding vectors. Additionally, the neighbors set also contains neighbor IDs, neighbor distances, metric methods, query expressions, primary key field names, vector field names, and top_k information. The use of the dataset is subject to the restrictions of the original data source licenses, and the ground truth part is licensed under Apache 2.0.
提供机构:
open-vdb
搜集汇总
数据集介绍
open-vdb/glove-100-angular 数据集图片
构建方式
该数据集源自ann-benchmarks项目,用于评估近似最近邻搜索算法的性能。构建过程基于GloVe词向量模型,从大规模文本语料中提取100维的密集向量表示,形成glove-100-angular数据集。数据被划分为训练集、测试集和邻居集三个部分:训练集包含1,183,514条向量,测试集包含10,000条向量,邻居集则存储了每个测试向量的真实最近邻索引、距离以及搜索配置信息。所有向量均以浮点数列表形式存储,并附有唯一标识符。
特点
数据集的一个显著特点在于其专为高维向量搜索基准测试而设计,提供了完整的训练-测试-邻居三元结构。训练集规模庞大,适合用于构建索引;测试集规模适中,便于快速评估;邻居集则包含了精确的最近邻结果,支持多种距离度量(如余弦相似度)和自定义查询参数。此外,数据集采用Apache 2.0许可协议对地面真值部分进行授权,确保了研究用途的合规性。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,指定config_name参数选择train、test或neighbors子集。加载后的数据以表格形式呈现,包含idx和emb字段用于向量操作,neighbors子集额外提供neighbors_id和neighbors_distance字段用于评估。典型使用流程包括:使用训练集构建向量索引,利用测试集进行查询,再通过邻居集计算召回率等性能指标。数据集兼容常见的向量搜索框架,如Faiss和Annoy。
背景与挑战
背景概述
在信息检索与机器学习领域,高维向量数据的近似最近邻搜索(ANNS)是支撑推荐系统、语义搜索及大规模嵌入索引的核心技术。glove-100-angular数据集源于GloVe词向量模型在100维空间中的嵌入表示,其创建于2025年1月,由ann-benchmarks基准测试项目维护,旨在为ANNS算法提供标准化评估平台。该数据集包含约118万训练样本和1万测试查询,并预先计算了基于余弦距离的精确近邻结果,成为衡量索引结构效率与召回率的关键基准。自发布以来,它被广泛用于对比HNSW、IVF等算法的性能,推动了向量数据库与近似搜索技术的迭代发展。
当前挑战
该数据集所解决的领域挑战在于高维空间下精确搜索的计算瓶颈,即“维度灾难”导致传统索引方法在100维向量上效率骤降。构建过程中,数据源自真实文本的GloVe嵌入分布不均,需通过标准化流程保证训练与测试集的一致性,并精确生成近邻标签以避免噪声干扰。此外,数据集规模对内存与计算资源提出严苛要求,需平衡高召回率与低延迟的搜索目标,同时确保基准测试在不同硬件环境下的可重复性。这些挑战促使研究者持续优化索引策略,以应对实际系统中海量向量检索的实时性需求。
常用场景
经典使用场景
glove-100-angular数据集源自GloVe词向量模型在100维空间中的嵌入表示,其核心应用场景聚焦于高维向量的近似最近邻搜索(ANNS)基准测试。该数据集提供了超过118万条训练向量与1万条测试向量,搭配预设的ground truth近邻关系,为评估不同索引算法在欧氏距离与余弦相似度度量下的检索精度与效率提供了标准化平台。研究者常将其作为衡量HNSW、IVF、LSH等主流ANN算法性能的通用测试床,通过调整参数与硬件环境,系统性地比较召回率、查询延迟与内存占用等关键指标。
衍生相关工作
该数据集衍生了一系列具有深远影响的经典工作,其中最具代表性的是ann-benchmarks基准测试框架的构建,它系统性集成了glove-100-angular等数据集,成为ANN算法对比的行业标准。在此基础上,研究者提出了如HNSW(分层可导航小世界图)、NSG(导航扩展图)和SPTAG(空间分区树与图混合索引)等创新索引结构,这些工作通过在该数据集上的严格评估,验证了其在查询速度与召回率之间取得的突破性平衡。此外,该数据集还催生了面向高维向量压缩的乘积量化(PQ)与优化型IVF索引的改进方案,推动了近似搜索领域从单纯追求精度向兼顾内存效率与硬件适配性的范式转变。
数据集最近研究
最新研究方向
glove-100-angular数据集作为近似最近邻搜索(ANNS)领域的经典基准测试资源,当前研究焦点集中于高维稠密向量检索的效率与精度平衡问题。随着大语言模型和多模态AI系统的爆发式增长,向量数据库与检索增强生成(RAG)技术成为热点,该数据集被广泛用于评估新型索引结构(如图基算法HNSW、量化方法PQ)及硬件加速方案(如GPU、TPU上的并行搜索)在100维GloVe词向量上的性能。其提供的标准化训练/测试分割与预计算邻居信息,为对比不同算法在欧氏距离度量下的召回率与吞吐量提供了可靠基线,推动了从学术研究到工业级向量搜索系统的落地,尤其在语义搜索、推荐系统等实时性要求高的场景中意义显著。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

