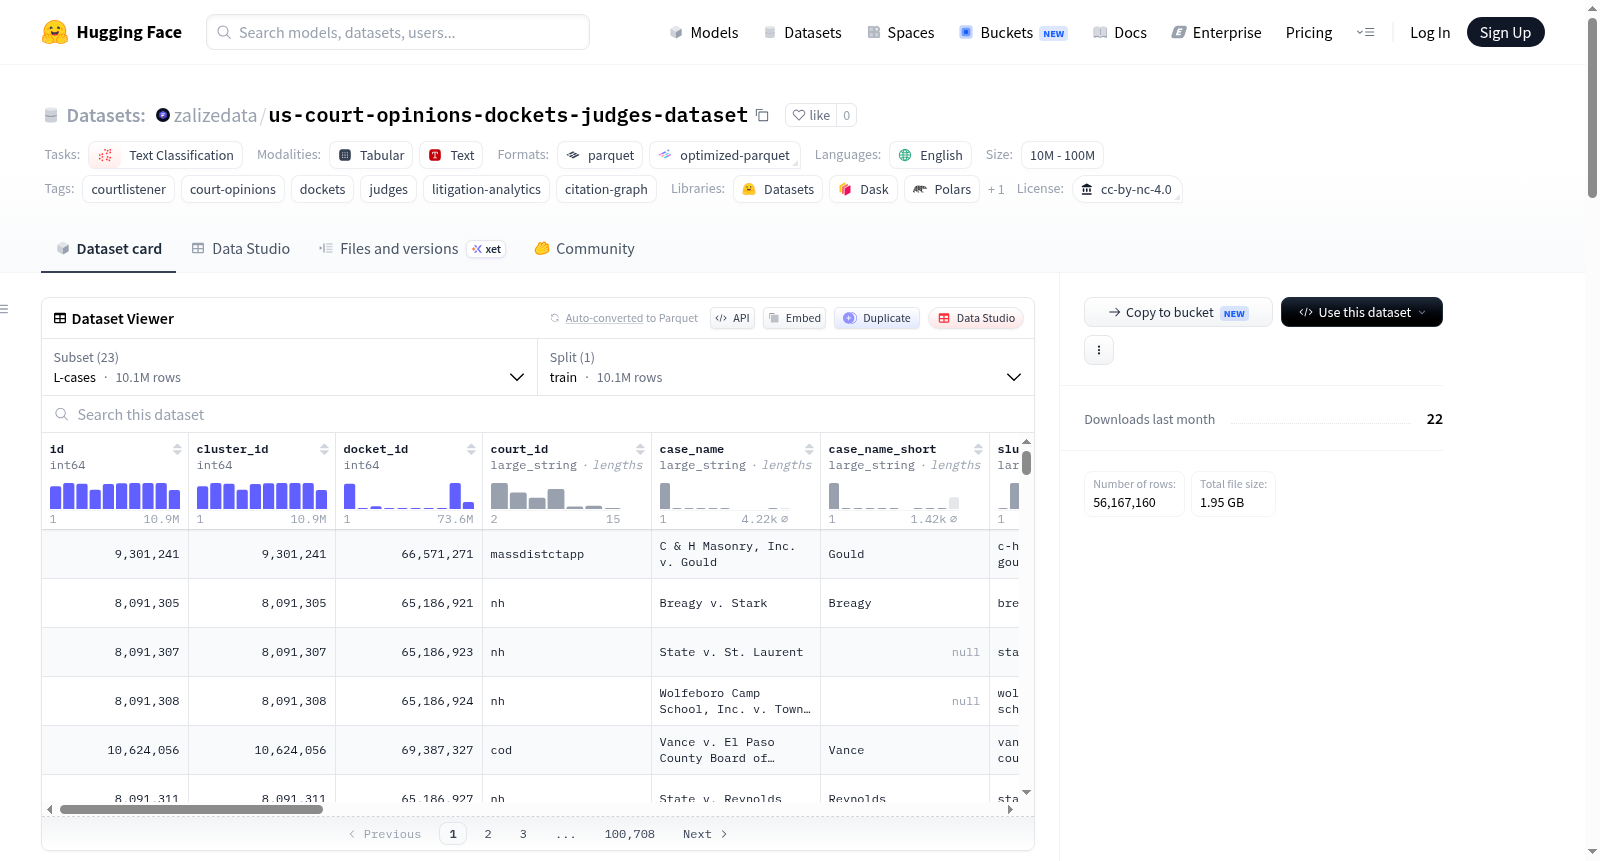
us-court-opinions-dockets-judges-dataset
收藏资源简介:
US Court Opinions Metadata, Dockets & Judges (CourtListener) 数据集源自 CourtListener / Free Law Project 的官方批量数据,提供了美国法院意见的元数据、案卷信息和法官信息。该数据集包含约1000万条意见集群、7000万条案卷记录和1.6万名法官的数据,以及派生信号(如引用图、公司诉讼档案),但不包含意见全文。数据按规模分为三个层级:S层(入门级,约230万行)、M层(研究级,约740万行)和L层(完整元数据库,约4650万行),每个层级包含多个表格(如cases、citations、courts、judges、opinions等)。该数据集适用于诉讼风险分析、法律分析研究、司法行为研究、公司诉讼暴露分析、引用网络分析等任务。数据采用CC BY-NC 4.0许可,仅供学术和个人使用,商业使用需获取DataForge商业许可。
The US Court Opinions Metadata, Dockets & Judges (CourtListener) dataset is derived from the official bulk data of CourtListener / Free Law Project, providing metadata, docket information, and judge information for U.S. court opinions. The dataset contains approximately 10 million opinion clusters, 70 million docket records, and 16,000 judges, along with derived signals (such as citation graphs and corporate litigation profiles), but does not include full opinion texts. The data is divided into three tiers based on size: S tier (entry-level, ~2.3 million rows), M tier (research-level, ~7.4 million rows), and L tier (full metadata database, ~46.5 million rows), each containing multiple tables (e.g., cases, citations, courts, judges, opinions). This dataset is suitable for tasks such as litigation risk analysis, legal research, judicial behavior analysis, corporate litigation exposure analysis, and citation network analysis. The data is licensed under CC BY-NC 4.0, for academic and personal use only; commercial use requires a DataForge commercial license.
US Court Opinions Metadata, Dockets & Judges (CourtListener)
数据集概述
该数据集基于 CourtListener / Free Law Project 的官方批量数据构建,包含 1000万意见集群、7000万案卷和1.6万名法官的元数据及衍生信号表(如引用图、公司诉讼概况),不含意见全文。数据集由 DataForge 开放数据计划提供,适用于学术和个人免费使用。
数据规模与分档
| 分档 | 行数 | 压缩后大小 |
|---|---|---|
| S(入门切片) | 2,286,889 | 73.9 MB |
| M(研究包) | 7,395,271 | 374.7 MB |
| L(完整元数据库) | 46,485,000 | 2.30 GB |
- S档:案件和法院的基础数据
- M档:包含法官及衍生信号的研究级数据
- L档:完整元数据,含引用图边和诉讼概况
数据内容
所有文件以 snappy parquet 格式存储,按分档(S/M/L)和表类型组织,共 23个配置,包括:
- 案件表(cases):各档均包含
- 引用表(citations):引用图边数据
- 法院表(courts):法院信息
- 法官表(judges/judge_positions):法官及其职位信息
- 意见表(opinions):意见元数据
- 法院年度统计(court_year_stats):M/L档包含
- 公司诉讼概况(company_litigation_profiles/yearly):L档包含
- 法院建筑(courthouses):L档包含
- 口头辩论(oral_arguments):L档包含
应用场景
- 诉讼风险与法律分析研究
- 司法行为研究
- 公司诉讼风险画像(仅限组织当事方)
- 引用网络分析
许可协议
双重许可:
- 学术/个人使用:CC BY-NC 4.0,需注明来源并回链至 data.zalize.com
- 商业使用:需获取 DataForge 商业许可证
- 上游数据来自 CourtListener / Free Law Project(Public Domain Mark 1.0),不含意见全文
文件格式与访问
- 支持通过
load_dataset加载,如:load_dataset("zalizedata/us-court-opinions-dockets-judges-dataset", "S-cases", split="train") - 原始压缩包(含 CSV、数据字典、数据表、许可证)可从 DataForge CDN 免费下载:
- S档:https://dl.zalize.com/open-data/courtlistener-tier1-S-2026-08-04
- M档:https://dl.zalize.com/open-data/courtlistener-tier1-M-2026-08-04
- L档:https://dl.zalize.com/open-data/courtlistener-tier1-L-2026-08-04
附加信息
- 来源与方法:CourtListener / Free Law Project 官方批量数据(元数据+衍生信号)
- 语言:英语
- 任务类型:文本分类
- 数据规模:10M < n < 100M
- DOI:10.5281/zenodo.21838140
- GitHub 镜像:https://github.com/wookat/dataforge-pipelines/releases/tag/open-data-us-court-records
- 数据集主页:https://data.zalize.com/datasets/us-court-opinions-dockets-judges-dataset
- 相关数据集:Clinical Trials & Drug Approvals、Global Research Output & Mobility,完整目录共25个数据集,见 https://data.zalize.com/open-data