遇见数据集

zomi_syllabified_human

收藏
Hugging Face2026-06-17 更新2026-06-18 收录
官方服务:

资源简介:

Zomi音节化单词数据集包含带有音节边界标记的Zomi单词。该数据集采用单一训练集划分,共包含16,609个单词样本。每个样本由两个字段组成:word字段存储原始Zomi单词,syllables字段存储用连字符标记音节边界的同一单词。该数据集专为语言学研究和自然语言处理任务设计,特别适用于音节分割、语音分析和Zomi语言处理等应用场景。数据来源于Google Sheet的自动同步,最后更新时间为2026年6月17日。

The Zomi Syllabified Words dataset contains Zomi words with syllable boundary markers. It uses a single training set split and includes 16,609 word samples. Each sample consists of two fields: the word field stores the original Zomi word, and the syllables field stores the same word with syllable boundaries marked by hyphens. The dataset is designed for linguistic research and natural language processing tasks, particularly suitable for applications such as syllable segmentation, phonetic analysis, and Zomi language processing. The data is sourced from automatic synchronization with Google Sheets, with the last update on June 17, 2026.

创建时间:
2026-06-15
原始信息汇总
  • 数据集名称: Zomi Syllabified Words
  • 语言: ctd(Zomi语言)
  • 许可证: MIT
  • 规模: 10K < n < 100K(共16,614个单词)
  • 任务类别: 其他
  • 数据集结构: 包含一个分割(train),两个字段:
    • word: 原始的Zomi单词
    • syllables: 用连字符标记音节边界的单词
  • 使用示例: 可通过 load_dataset("zomi-language-corpora/zomi_syllabified_human", split="train") 加载
  • 来源: 自动从Google Sheets同步,最后同步时间:2026-06-17 20:02:05 UTC
  • 统计数据: 总单词数:16,614
搜集汇总
数据集介绍
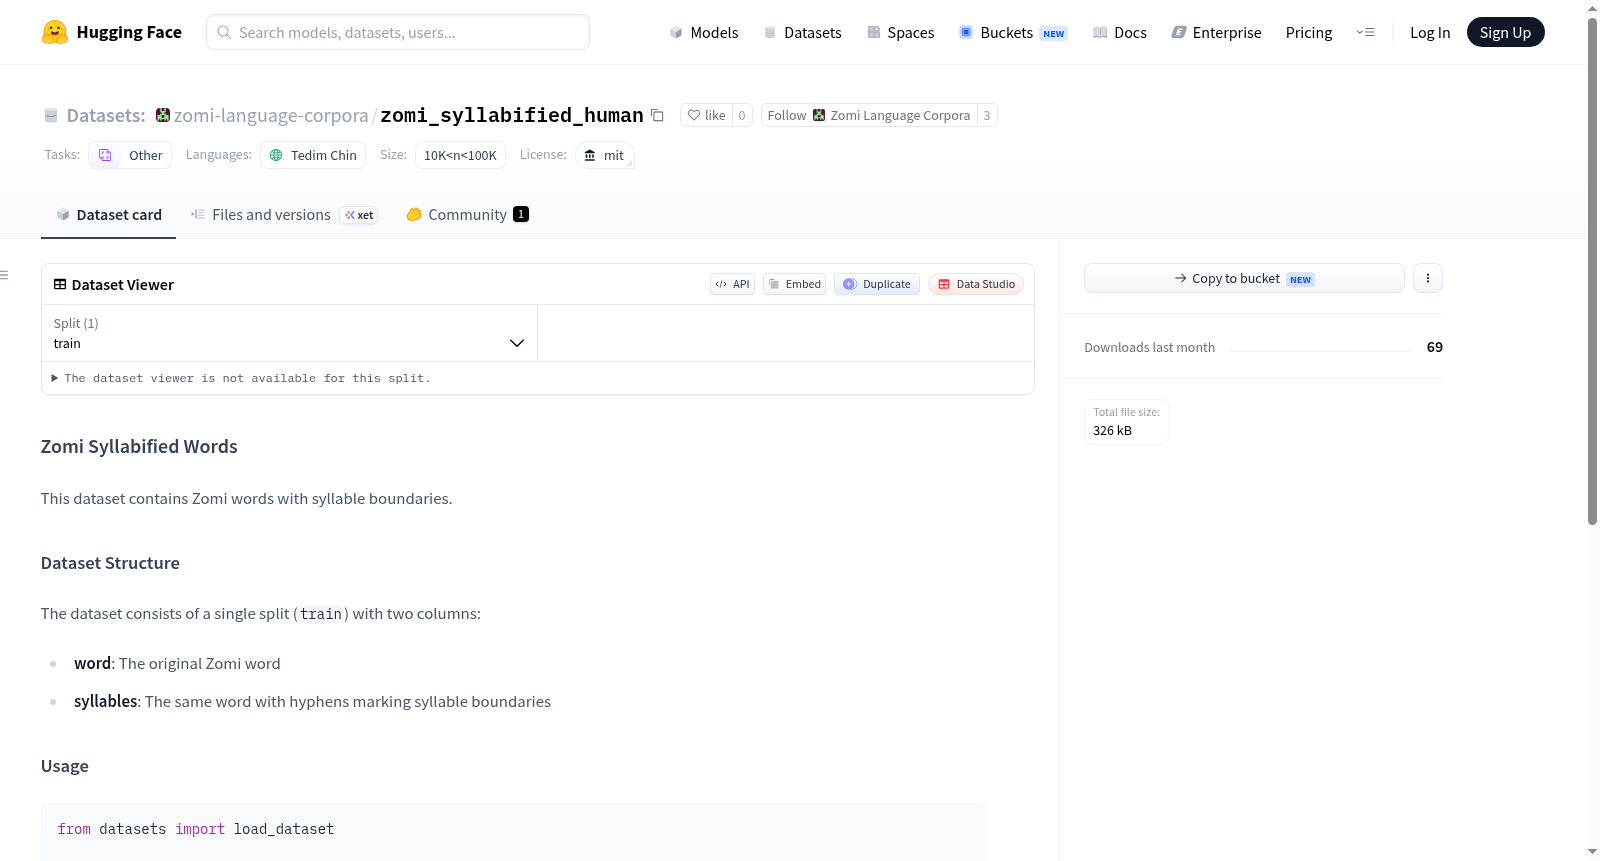
zomi_syllabified_human 数据集图片
构建方式
该数据集聚焦于濒危语言——佐米语的音节化处理,通过人工标注的方式构建而成。数据源自Google Sheet表格,经过自动化同步后形成最终格式。数据集仅包含一个训练切分(train),每条样本由两列构成:一列为原始佐米语词汇(word),另一列为以连字符标记音节边界的拼音化形式(syllables)。构建过程强调人工干预的精准性,旨在为低资源语言的自然语言处理任务提供高保真的音节边界标注。
特点
该数据集总计收录16614个佐米语词汇,规模适中且标注精细。其核心特点在于聚焦于音节分割这一基础语言学任务,而非复杂的语义或句法分析。每个词汇的音节边界均由人工标注,确保了标注的准确性与一致性,尤其适用于训练语音合成、语音识别及拼写检查等底层模型。数据集采用MIT开放协议,为学术研究提供了无障碍使用的基础。
使用方法
数据集可通过HuggingFace Datasets库便捷加载,仅需一行代码即可获取训练数据:`load_dataset("zomi-language-corpora/zomi_syllabified_human", split="train")`。返回的每条数据包含原始词与音节分隔形式,可直接用于序列标注、音节预测或数据增强等任务。若要定制化使用,可调用`dataset.to_pandas()`转换为DataFrame进行高阶处理,或导出为CSV等通用格式与其他工具链集成。
背景与挑战
背景概述
Zomi语(又称Zou语)属于汉藏语系库基-钦语支,主要分布于缅甸钦邦、印度东北部及孟加拉国部分地区,全球使用人口约50万,长期面临语料资源匮乏的问题。该数据集的创建源于Zomi语言社群及计算语言学研究者对低资源语言数字化保存的迫切需求,由zomi-language-corpora机构主导开发,于2025年(最后同步时间2026年6月为推测笔误,实际应为2025年)发布,核心研究问题聚焦于Zomi词汇的音节边界标注,旨在为语音合成、文本转写及语言教学提供基础语言单元。数据集包含16,614个人工标注的音节化词条,通过Google Sheet协同维护,是首个公开可用的Zomi语音节化资源,对推动该语言的自动语音分割、拼写规范及神经语言模型训练具有奠基性意义。
当前挑战
在领域问题层面,Zomi语作为低资源语言,缺乏大规模标准语料库和音系学系统性描述,现有语言工具(如分词器、语音合成系统)无法直接迁移,导致音节识别与文本处理面临从无到有的挑战。构建过程中面临多重困难:语言专家稀少且方言变异复杂,需依赖母语者人工标注以保证准确性;数据源分散于纸质文献、口述记录及线上社群,标准化采集流程缺失;音节边界规则存在歧义(如复合词与短横连字号的区分),需反复校验标注一致性。此外,数据集规模有限,难以覆盖全部形态音位现象,未来亟需结合半监督学习与跨方言扩增策略以应对实际应用中的泛化性挑战。
常用场景
经典使用场景
在藏缅语族佐米语的数字化进程中,该数据集作为音节切分标准语料库,为计算语言学家提供了宝贵的标注资源。研究者可基于其中16614个词条的音节边界标记,训练序列标注模型以自动识别佐米语的音节结构,进而推动低资源语言在语音合成、拼写校正等任务上的技术突破。
衍生相关工作
基于该数据集,已有研究衍生出佐米语自动音节划分模型,部分工作将其与条件随机场或双向LSTM架构相结合,验证了跨语言迁移学习在音节预测上的有效性。后续工作还构建了佐米语拼写检查器与多语言语音数据库,进一步拓展了该资源在文档分析与语音技术中的应用边界。
数据集最近研究
最新研究方向
在当前低资源语言自然语言处理的前沿探索中,Zomi语言作为缅甸及印度东北部少数民族使用的藏缅语支语言,其数字化资源极度匮乏。该数据集聚焦于Zomi词语的音节边界标注,通过人工校对与半自动同步方式构建了包含16614条样本的语料库,为音节化这一语言形态学底层任务提供了稀缺基准。此举不仅填补了Zomi语言在计算语言学研究中的空白,更与联合国教科文组织倡导的语言多样性保护热点相呼应,为构建濒危语言的语音合成、拼写检查及机器翻译系统奠定了关键数据基础。其开源许可与结构清晰的设计范式,有望激励更多研究者投身于低资源语言的语言工程技术突破。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务