
3D-dungeon-crawler-video
收藏官方服务:
资源简介:
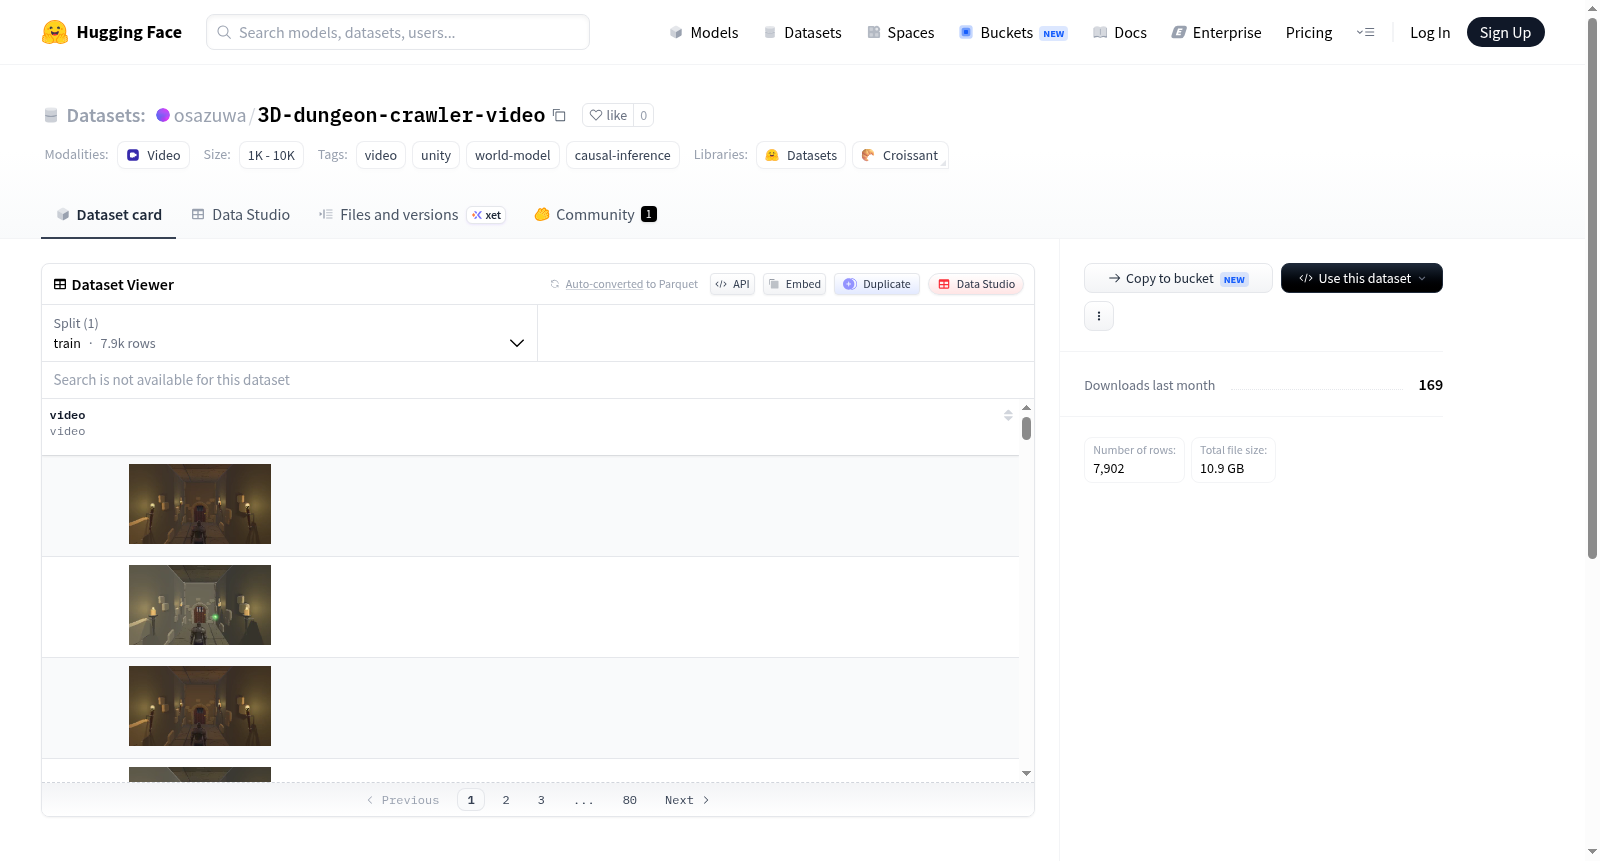
3D Dungeon Crawler Video 是一个用于观测世界模型训练的确定性23秒Unity片段数据集。数据集包含10,000个片段,其中8,000个用于训练,1,000个用于验证,1,000个用于测试。Unity渲染分辨率为512x288以实现超采样,每个clips/*.mp4文件经过区域下采样后存储为256x144分辨率和30fps。训练时每三帧采样一次,产生230帧和一个18x32的tokenizer网格。对应的arrays/*.npz文件包含dag_ticks、action_tokens和final_state。所有片段均为观测性(do={}),因果变量Z可见,并且数据集分割在所有九个二元因果变量(D, Z, V, W, X, M, A, Y, R)上进行了确定性平衡。
3D Dungeon Crawler Video is a deterministic 23-second Unity clip dataset for observational world model training.
创建时间:
2026-08-13
原始信息汇总
数据集概述
3D Dungeon Crawler Video 是一个用于世界模型与因果推断研究的视频数据集,由 Unity 引擎生成,包含确定性的 23 秒游戏片段。数据集总计 10,000 个片段,划分为 8,000 个训练片段、1,000 个验证片段和 1,000 个测试片段。
数据规格
- 原始渲染分辨率:512x288,用于超采样
- 存储分辨率:256x144(经面积降采样)
- 帧率:30 fps
- 训练采样:每第三帧采样一次,产生 230 帧,对应 18x32 的 tokenizer 网格
文件结构
clips/*.mp4:视频片段文件,按上述分辨率与帧率存储arrays/*.npz:与视频片段一一对应的 NumPy 数组文件,包含:dag_ticks:因果图时间步标记action_tokens:动作 token 序列final_state:片段最终状态
因果设计
- 观测性质:所有片段均为纯观测数据(
do={}),即无干预操作 - 混淆变量可见性:因果变量 Z(混淆变量)在数据中可见
- 变量平衡:训练、验证、测试分割在所有九个二元因果变量(D, Z, V, W, X, M, A, Y, R)上确定性均衡分布,保证各类别在分割中比例一致
搜集汇总
数据集介绍
构建方式
该数据集基于Unity引擎生成确定性的23秒三维地牢探险视频片段,共计10,000个片段,严格划分为8,000条训练、1,000条验证及1,000条测试样本。渲染原始分辨率为512x288,经面积下采样存储为256x144、30帧每秒的视频文件,训练时每隔两帧采样一次,最终得到230帧序列及18x32的词元网格。配套的数组文件(.npz)记录了因果结构中的关键变量,包括DAG时间步长、动作词元及最终状态,确保每个片段具备完整的因果链条。所有片段均为纯观测数据(无干预),混淆变量Z可见,且数据集划分在九个二元因果变量(D, Z, V, W, X, M, A, Y, R)上实现确定性均衡,为因果推断与世界模型训练提供严谨的数据基础。
使用方法
使用时,研究者可加载clips目录下的MP4视频进行视觉输入,或直接利用arrays中的.npz文件获取精细的因果变量与动作标签。由于视频已进行标准化下采样,模型可直接以256x144分辨率、30帧速率处理,训练时推荐每三帧采样一次,以匹配18x32词元网格的潜在空间设计。数据划分明确,应确保训练、验证与测试集分别使用对应子集,以遵循因果均衡原则。该数据集特别适用于世界模型训练、因果发现算法评估以及无干预环境下的强化学习预训练任务,如对比预测编码(CPC)、潜在动态模型或结构因果模型的学习。研究者可直接基于公开代码库,利用其提供的DAG变量和动作词元进行自定义模型输入管道的构建。
背景与挑战
背景概述
该数据集由Unity引擎生成的确定性23秒视频片段组成,共计10,000个片段,按8,000训练、1,000验证、1,000测试划分,旨在为观察性世界模型训练提供基准。创建时间不详,但其设计聚焦于因果推断与视频生成的前沿交叉领域,核心研究问题在于利用可见的混杂变量Z和九个二元因果变量(D, Z, V, W, X, M, A, Y, R)的平衡划分,支持从原始视频中学习因果结构。Unity渲染原始分辨率为512x288,后经区域降采样至256x144、30帧率,训练时每三帧采样,产生230帧及18x32的tokenizer网格,配套的npz文件提供因果图时间步、动作token和最终状态。该数据集的平衡设计与确定性环境,为评估世界模型在因果泛化、干预预测和反事实推理方面的能力提供了重要测试平台,对多模态学习、视频预测和因果表征学习领域具有潜在影响力。
当前挑战
领域问题方面,主要挑战在于从高维视频观测中提取因果结构,而非单纯学习像素级动态,要求模型区分因果关系与纯相关性,尤其是在混杂变量可见但干预缺失的观测设定下,需要从被动数据中推断可泛化的因果机制,这远超传统视频预测任务,对模型的因果表征能力提出严苛要求。构建过程中,挑战体现在确保数据集的平衡性与确定性:必须对九个二元因果变量进行精确的平衡划分,确保训练、验证和测试集在变量组合上无偏,同时维持23秒片段的确定性物理规则和渲染一致性;技术上还需处理高分辨率渲染到低分辨率存储的降采样损失,并决定训练帧采样策略以平衡信息保留与计算效率,最终生成可对齐的video与数组文件,保证因果标注与视觉内容严格对应,这些步骤均需精细的工程设计与校验。
常用场景
经典使用场景
3D-dungeon-crawler-video数据集作为观察性世界模型训练的基准资源,其核心应用场景聚焦于因果推断与视频预测的交叉领域。该数据集提供10,000段确定性Unity环境生成的23秒视频片段,每段以256x144分辨率、30帧率记录,并配套包含因果变量(D, Z, V, W, X, M, A, Y, R)标注的元数据文件。研究者利用其进行无需干预(do={})的被动观测学习,尤其适用于验证模型能否从视觉流中感知潜在因果结构,并基于可见的混杂变量Z实现去偏预测。图灵测试式的视频生成质量评估亦常以此数据为媒介。
解决学术问题
该数据集精准回应了世界模型研究中长期存在的因果机制隐含与不可识别性难题。在传统视频数据中,环境动态的生成过程往往黑箱化,导致模型仅能捕获表面相关性而无法泛化至分布外场景。此数据集通过确定性环境设计、显式因果变量标注及平衡的数据划分,使得研究者能够量化评估模型对因果效应的捕获程度,推动了从关联预测向因果推断的范式转变。其提供的精细化时序标注(如dag_ticks)亦为干预实验的代理模拟创造了条件,促进了可解释人工智能与鲁棒视频预测理论的发展。
实际应用
在实践层面,该数据集为游戏人工智能、虚拟环境智能体及数字孪生系统提供了高保真的训练资源。游戏开发者可借此训练非玩家角色(NPC)在复杂地下城场景中的行为预测模型,使其能够基于视觉输入推断潜在规则并预判动态变化。自动化内容生成领域亦从中获益,通过借鉴其tokenizer网格策略,实现低分辨率下视频编辑与生成的质量提升。此外,因果感知的视频预测模型可应用于自动驾驶模拟及机器人任务规划,帮助系统在未见场景中做出安全决策,其观测性设计契合真实世界无法主动干预的约束。
数据集最近研究
最新研究方向
该数据集聚焦于确定性三维环境下的世界模型训练与观测性因果推断研究,其前沿方向涵盖基于视频的因果表示学习、可控生成与干预模拟。通过提供平衡的二元因果变量分布和可见的混杂因子,它推动了从被动观测数据中识别因果结构、反事实推理及模型泛化能力的探索,尤其关注于类游戏环境中智能体对动态场景的因果理解与稳健行动规划。
以上内容由遇见数据集搜集并总结生成


