
Sefaria/Rabbinic-Embedding-Leaderboard
收藏官方服务:
资源简介:
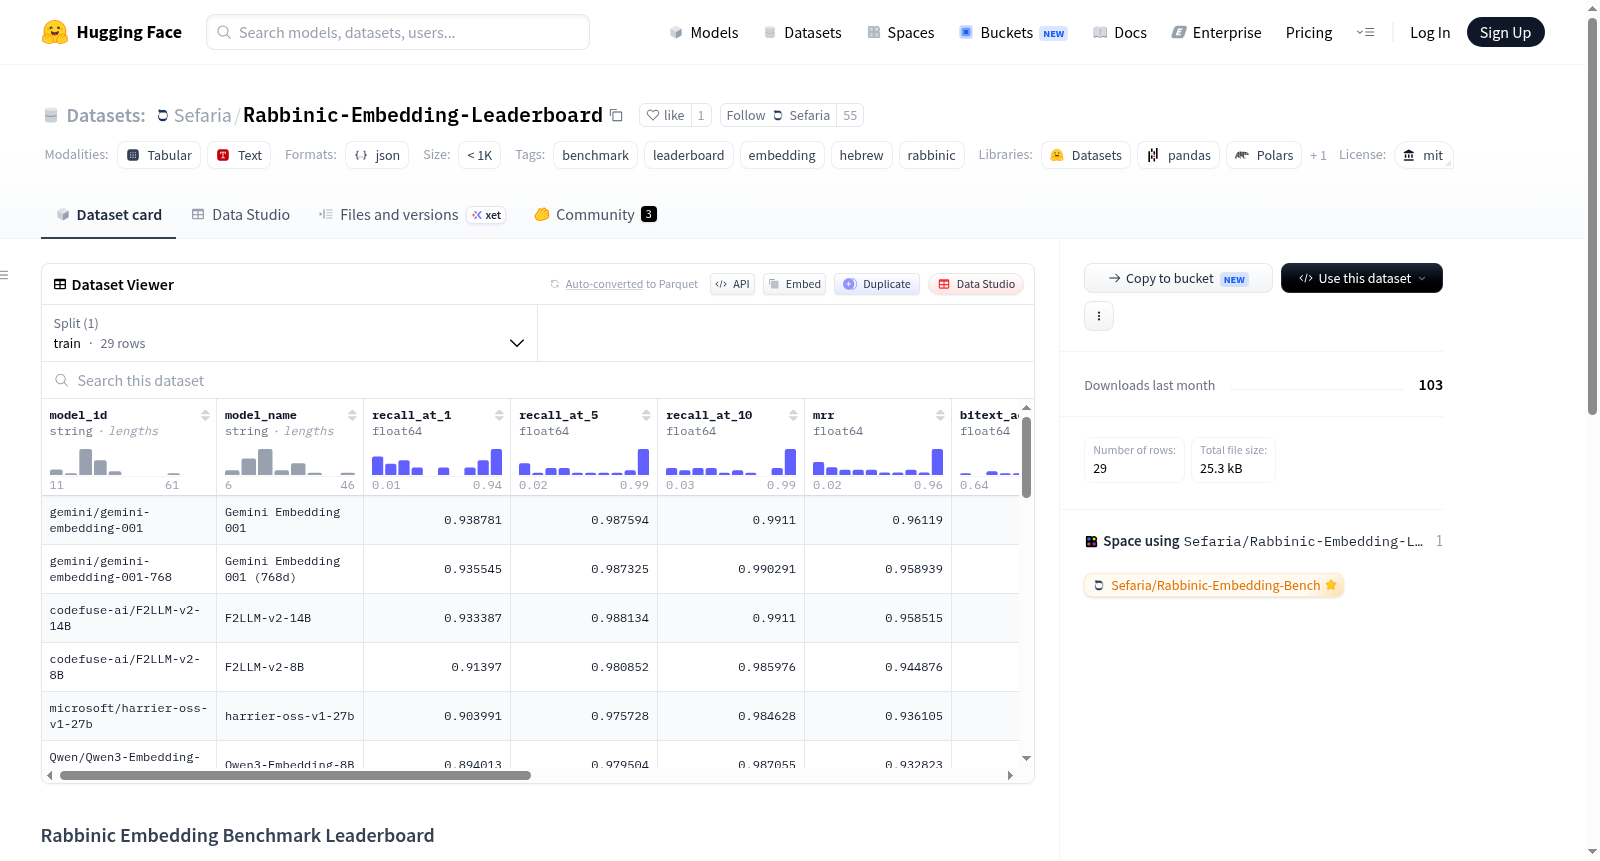
该数据集存储了Rabbinic Hebrew/Aramaic Embedding Benchmark的排行榜结果。leaderboard.json文件包含一个评估结果数组,每个结果包括模型ID、模型显示名称、MRR(平均倒数排名)、不同级别的召回率、双语准确率、平均真实对相似度、平均随机对相似度、对数、时间戳以及类别分布等信息。
This dataset stores the leaderboard results for the Rabbinic Hebrew/Aramaic Embedding Benchmark. The `leaderboard.json` file contains an array of evaluation results, each including model ID, model display name, MRR (Mean Reciprocal Rank), recall at different levels, bitext accuracy, average true pair similarity, average random pair similarity, number of pairs, timestamp, and category distribution.
提供机构:
Sefaria搜集汇总
数据集介绍
构建方式
Rabbinic-Embedding-Leaderboard 是一个专为拉比希伯来语与阿拉姆语文本嵌入模型设计的排行榜基准数据集。其构建基于对多种嵌入模型在语义匹配任务上的系统评估,通过存储各模型在标准测试集上的表现结果,如平均倒数排名(MRR)、召回率(Recall@1/5/10)和双语文本准确率(Bitext Accuracy)等指标,形成结构化的JSON数组。每条记录包含模型标识、评分详情、评估时间及按类别(如塔木德、米示拿)细分的测试样本数量,确保评估的全面性与可复现性。
特点
该数据集以排行榜形式呈现,突出核心评估指标,包括相似度得分(平均真实对相似度与随机对相似度)及类别分布,直观反映模型在拉比文献特定领域的检索与对齐能力。数据规模涵盖3708个文本对,覆盖塔木德、米示拿等经典类别,强调专业领域深度。其特点在于聚焦低资源语言(拉比希伯来语/阿拉姆语)的嵌入评估,填补了宗教文本语义理解基准的空白,为研究者提供横向对比与模型选型的量化依据。
使用方法
用户可通过加载leaderboard.json文件直接获取所有模型的评估结果,适用于分析嵌入模型在拉比文本上的性能差异。具体使用时,可解析JSON数组中的字段(如model_id、mrr、recall_at_k)进行排名计算或可视化。此外,结合配套的基准数据集(Rabbinic-Hebrew-English-Pairs)与在线评估空间,开发者可复现测试流程或提交新模型结果。建议优先关注类别分布字段(categories)以了解模型在不同文献子集上的表现。
背景与挑战
背景概述
Rabbinic-Embedding-Leaderboard是由Sefaria机构创建的一个专门针对拉比希伯来语和亚拉姆语文本的嵌入模型评估基准排行榜。该数据集于2024年发布,旨在解决宗教文献自然语言处理中嵌入模型性能评估缺失的问题,特别是针对《塔木德》、《米示拿》等拉比文献的语义表示能力。作为首个专注于犹太经典文本嵌入评估的公开排行榜,它不仅为研究人员提供了模型对比的标准化平台,还推动了低资源语言嵌入技术的发展,对宗教文本数字化、语义搜索及跨语言信息检索等领域具有重要影响力。
当前挑战
该数据集面临的核心挑战包括:首先,拉比希伯来语和亚拉姆语作为低资源语言,其语言复杂性高、语法古奥且包含大量术语,导致通用嵌入模型难以有效表示,现有模型在此类文本上的准确率显著低于现代希伯来语。其次,构建过程中需要处理大量古文献中的变体拼写、无标点文本及跨语种混合段落,人工标注对数据集的构建——包括创建高质量的文本对齐对(如《塔木德》中的平行语句)——极其耗时,且领域专家稀缺。此外,如何设计全面评估嵌入模型在语义相似度、检索召回等任务上表现的评价指标体系也是一大难题,而排行榜的持续维护需要应对模型更新与结果可复现性之间平衡的挑战。
常用场景
经典使用场景
在自然语言处理与计算语言学领域,拉比文献的语义嵌入研究长期面临多语言、多历史层次的挑战。Rabbinic Embedding Leaderboard 作为首个涵盖希伯来语与阿拉姆语拉比文献的嵌入模型排行榜,为研究者提供了系统评估文本表示质量的基准。其经典使用场景聚焦于跨语言语义匹配与检索任务,通过平均倒数排名(MRR)、Recall@K 等指标衡量模型在《塔木德》《密西拿》等核心文献片段间的对齐能力。该数据集支持对不同嵌入模型在拉比文献语境下的表现进行横向对比,从而推动针对古典犹太教文本的专用词向量与句子编码器的开发。
实际应用
该数据集在实际应用中展现出对数字人文学科与宗教教育技术的显著赋能。在数字图书馆领域,它支持着希伯来经典文献的智能搜索引擎优化,使研究者可基于语义相似度精准定位《塔木德》中互为关联的论辩段落;在教育场景下,它驱动了拉比文献智能助手的检索增强生成(RAG)系统,帮助学习者从浩如烟海的犹太教经典中快速提取特定主题的平行文本与注释脉络。此外,该数据集也为多语言数字档案馆的跨语种文献对齐工具开发提供了验证基准。
衍生相关工作
该数据集的发布催生了一系列围绕古典文献语义建模的衍生工作。研究者借鉴其评估框架,发展了针对拉比文献中阿拉姆语变体与晚期希伯来语的专用嵌入模型,如融合了塔木德词法规则的定制化BERT模型。在方法论层面,其多层级分类标注体系被复用至《死海古卷》与早期基督教文本的语义对齐研究中,推动了古代近东文献的跨语种表示学习。同时,该排行榜的持续更新机制也激励了社区构建更广泛的中东历史文献嵌入标准化评估协议。
以上内容由遇见数据集搜集并总结生成


