
TeachObs
收藏资源简介:
TeachObs是由多国研究机构联合构建的一个经过人工验证的多模态教学观察基准数据集,旨在支持课堂教学视频的细粒度分析与整体评估。该数据集包含来自八个国家、涵盖九个学科领域的30个公开K-12课堂视频,被分割为5,158个固定15秒的场景片段,并由七名研究人员基于包含39个观察代码(20个视觉代码和19个非视觉代码)的标注方案进行独立标注,最终通过基于Krippendorff's alpha的可靠性共识规则生成黄金标注层。数据集的创建过程首先从TIMSS 1999视频研究档案、马萨诸塞州教育部门校准视频资源及韩国公开课堂视频三个来源收集原始视频,经过自动化预处理后由人工完成多轮独立编码与校验,确保了标注的严谨性与一致性。该数据集主要应用于教育人工智能领域,特别是多模态大语言模型在教学行为识别、课堂质量评估等方面的性能评测,旨在解决现有课堂视频资源在细粒度教学行为标注与整体课程质量专家评价结合不足的问题,为AI辅助教学分析提供可靠的基准测试平台。
TeachObs is a manually validated multimodal teaching observation benchmark dataset jointly constructed by multinational research institutions, aiming to support fine-grained analysis and holistic evaluation of classroom teaching videos. This dataset contains 30 publicly available K-12 classroom videos from 8 countries spanning 9 academic disciplines, which are segmented into 5,158 fixed 15-second scene clips. Seven researchers performed independent annotation based on an annotation scheme consisting of 39 observation codes (20 visual codes and 19 non-visual codes), and the gold standard annotation layer was finally generated via reliability consensus rules based on Krippendorff's alpha. The dataset was initially constructed by collecting raw videos from three sources: the TIMSS 1999 Video Study Archive, the calibrated video resources from the Massachusetts Department of Education, and public classroom videos from South Korea. After automated preprocessing, manual multiple rounds of independent coding and verification were conducted to ensure the rigor and consistency of annotations. This dataset is primarily applied in the field of Educational AI, particularly for performance evaluation of multimodal large language models (LLMs) in tasks such as teaching behavior recognition and classroom quality assessment. It aims to address the gap that existing classroom video resources lack sufficient integration of fine-grained teaching behavior annotations and expert evaluations of overall course quality, providing a reliable benchmark testing platform for AI-assisted teaching analysis.
TeachObs Benchmark 数据集详情
数据集结构
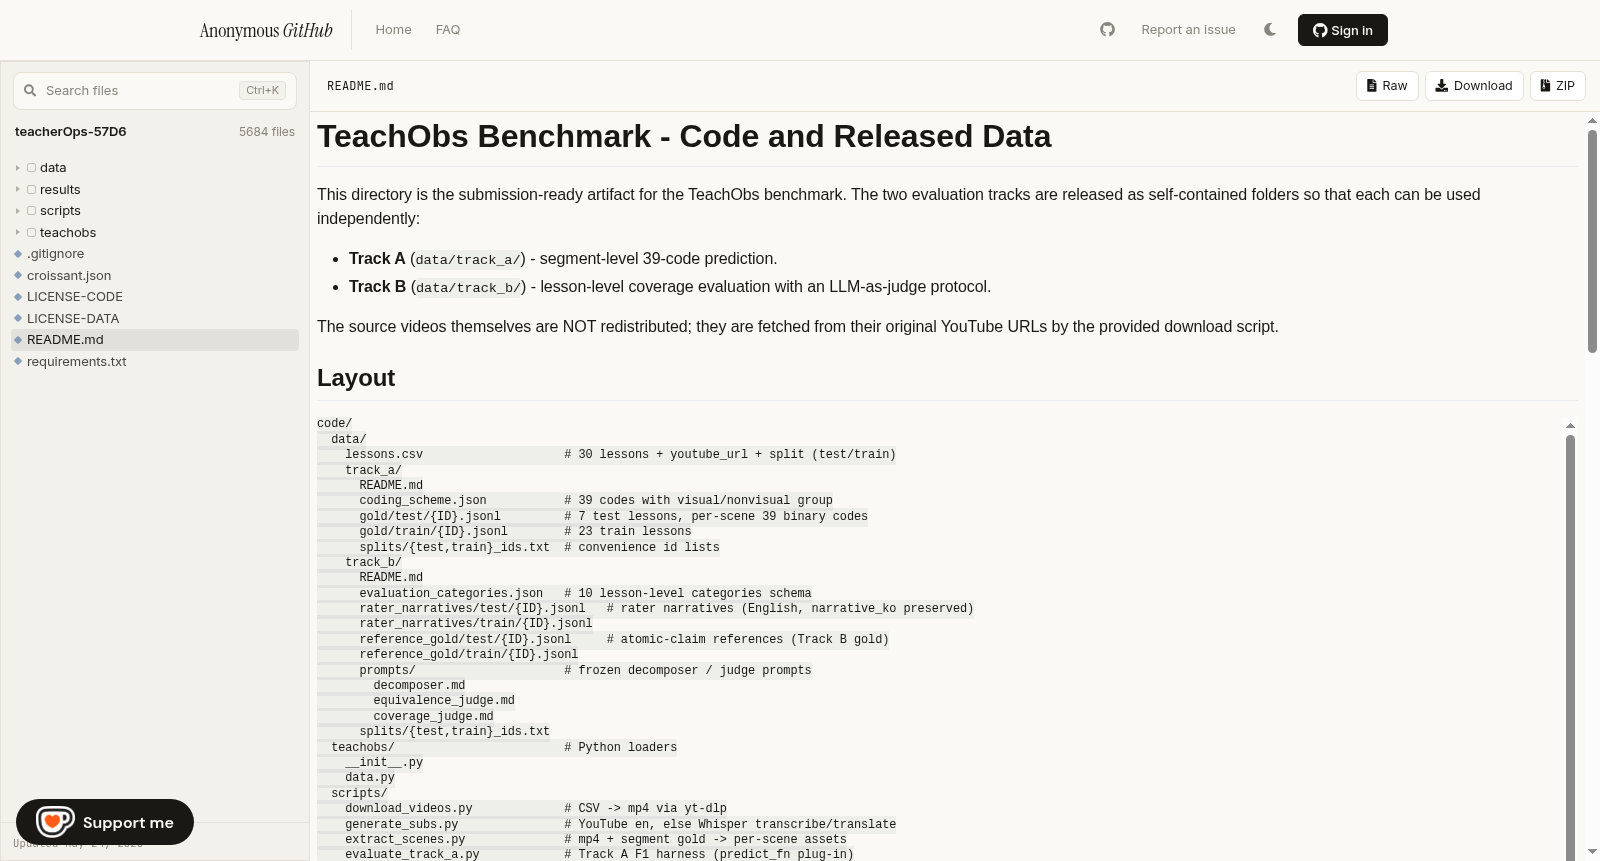
该数据集包含两个评估赛道,以独立文件夹形式发布:
- Track A (
data/track_a/):片段级39个编码预测 - Track B (
data/track_b/):基于LLM评判的课程级覆盖评估
数据文件布局
data/ lessons.csv # 30门课程 + YouTube链接 + 数据划分(train/test) track_a/ coding_scheme.json # 39个编码,含视觉/非视觉分组 gold/test/{ID}.jsonl # 7个测试课程,每片段39个二值编码 gold/train/{ID}.jsonl # 23个训练课程 splits/{test,train}_ids.txt # ID列表 track_b/ evaluation_categories.json # 10个课程级类别模式 rater_narratives/test/{ID}.jsonl # 评分者叙述(英文,保留narrative_ko) rater_narratives/train/{ID}.jsonl reference_gold/test/{ID}.jsonl # 原子声明参考(Track B金标准) reference_gold/train/{ID}.jsonl prompts/ # 冻结的分解器/评判提示 decomposer.md equivalence_judge.md coverage_judge.md splits/{test,train}_ids.txt
数据划分
- 测试集:S2, S4, S5, S19, S24, S28, S30(7门课程,约占片段数的23%)
- 训练集:其余23门课程
- 两个赛道共享相同的划分
- 测试集包含语料库中所有仅出现1次的教师和仅出现1次的学校等级
数据来源与处理
- 原始视频未在此仓库中重新分发,需通过提供的下载脚本从原始YouTube URL获取
- 推荐使用YouTube自有字幕,
generate_subs.py通过yt-dlp获取 - Whisper.cpp作为可选回退方案(仅当字幕缺失或不可用时)
预期用途
TeachObs是一个用于课堂视频理解的人工智能评估基准,不用于评估个体教师。
代码工具
scripts/目录包含以下主要脚本:
| 脚本 | 功能 |
|---|---|
download_videos.py |
CSV转mp4(通过yt-dlp) |
generate_subs.py |
获取YouTube字幕/Whisper转录翻译 |
extract_scenes.py |
从mp4+片段金标准生成每片段资源 |
evaluate_track_a.py |
Track A F1评估 |
evaluate_track_b.py |
Track B覆盖率评估 |
build_reference.py |
从评分者叙述构建Track B参考金标准 |
run_pipeline.sh |
端到端流程:下载→字幕→场景 |
- 1TeachObs: A Human-Validated Benchmark for Multimodal Teaching Observation and Model Evaluation印第安纳大学布卢明顿分校; 培材大学; 首尔大学; 梨花女子大学; 伍尔弗汉普顿大学; 高丽大学世宗校区 · 2026年


