fineweb-genre
收藏资源简介:
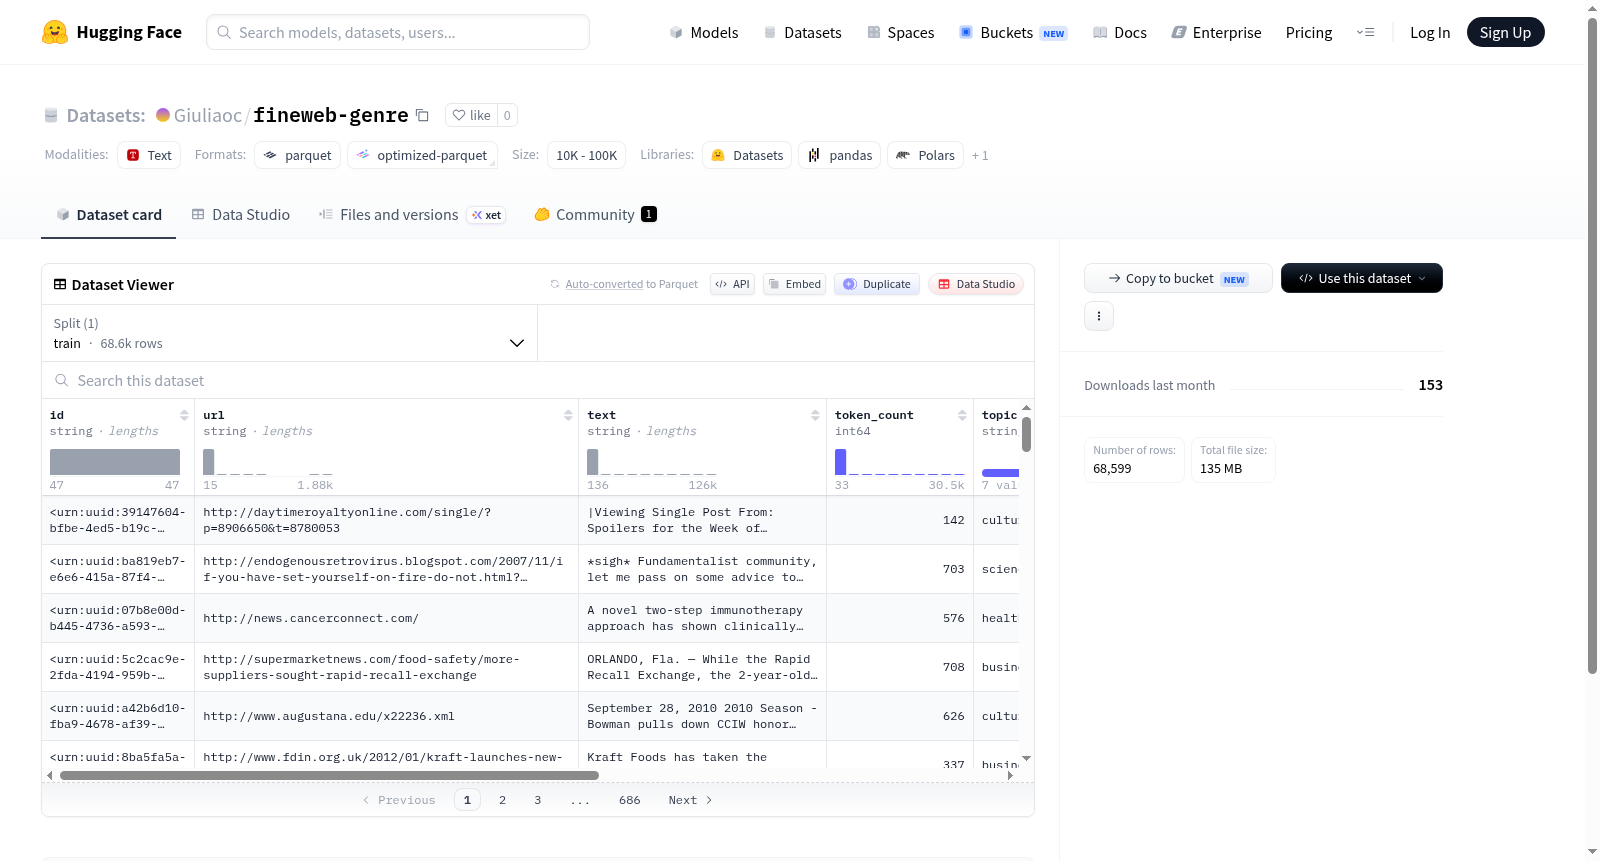
该数据集包含34,289个训练样本,每个样本包含以下字段:id(字符串标识)、url(来源链接)、text(文本内容)、token_count(文本的token数)、topic(主题标签)、genre(体裁标签)、classifier_lm(分类器或语言模型标识)。source_language和translated_text字段为空。数据集以文本数据为主,附带元数据,可用于文本分类或多标签分类任务。
The dataset contains 34,289 training samples, each with the following fields: id (string identifier), url (source link), text (text content), token_count (number of tokens in the text), topic (topic label), genre (genre label), classifier_lm (classifier or language model identifier). The source_language and translated_text fields are empty. The dataset consists mainly of text data with metadata, suitable for text classification or multi-label classification tasks.
数据集概述:fineweb-genre
该数据集是一个专门用于文本分类和主题/文体分析的中文文本数据集。其核心价值在于为每个样本提供了详细的文体(genre)和主题(topic)标注,适合用于自然语言处理中的文本分类、文体识别或主题建模等任务。
基本信息
- 数据集名称:fineweb-genre
- 数据集规模:训练集包含 68,599 条样本
- 数据大小:下载大小约 134.67 MB,数据集总大小约 222.06 MB
- 数据格式:支持通过 Hugging Face Datasets 库加载,配置名为
default
数据字段说明
每条样本包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
id |
字符串 | 样本唯一标识符 |
url |
字符串 | 来源网页链接 |
text |
字符串 | 原始文本内容 |
token_count |
整数 | 文本的 token 数量 |
topic |
字符串 | 文本所属主题 |
genre |
字符串 | 文本所属文体类别(如新闻、小说等) |
classifier_lm |
字符串 | 用于分类的语言模型标识 |
source_language |
空值 | 源语言(当前未提供) |
translated_text |
空值 | 翻译后的文本(当前未提供) |
数据集用途
- 可应用于文本分类(基于 genre 或 topic)
- 可应用于文体分析和主题建模
- 可结合
token_count进行文本长度分布统计
数据来源
数据来源于网页内容,每条样本携带原始 URL,便于追溯来源。所有样本集成于一个训练集(train),无验证集或测试集划分。