SWE-bench-Science
收藏资源简介:
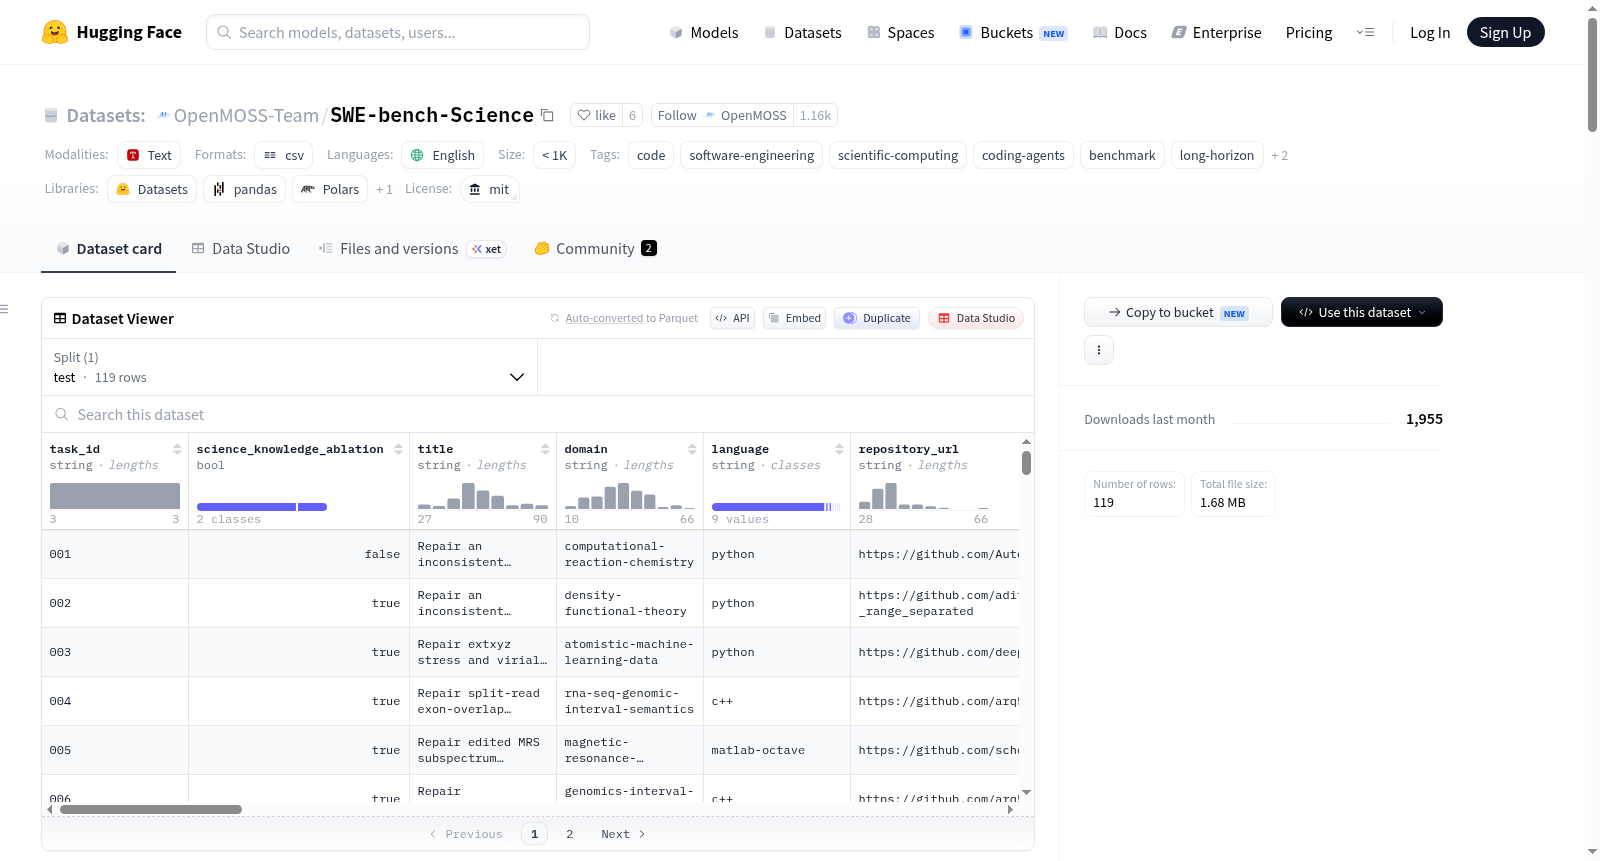
SWE-bench Science是一个用于评估编码代理在科学计算软件工程任务上表现的基准数据集。该数据集包含119个来自20个不同科学领域的任务,每个任务均提供隔离的运行环境和独立的程序验证器。数据集旨在衡量编码代理解决真实科学计算仓库中软件工程问题的能力。数据以CSV文件形式提供,每个样本包含任务ID、科学知识消融标记、标题、领域、编程语言、仓库URL、基础提交哈希、源代码许可证、许可证族标记、受限许可证标记、许可证门控、材料许可证、材料许可证来源、材料限制、材料门控、材料清单SHA256、材料来源、限制原因、环境镜像、验证器镜像、镜像平台、任务路径、状态等字段。默认选择包含96个无限制许可证的任务,另有23个受限制任务(其中18个属于GPL/LGPL/AGPL家族)。数据集还提供了91个任务的科学知识消融子集。该数据集适用于科学计算领域的编码代理评估、软件工程任务解决、长期推理能力测试等场景。数据集使用MIT许可证,但部分任务包含的第三方材料保留其原始许可证。
SWE-bench Science is a benchmark dataset for evaluating coding agents on scientific computing software engineering tasks. It contains 119 tasks from 20 different scientific domains, each with an isolated runtime environment and an independent program verifier. The dataset measures the ability of coding agents to solve software engineering problems in real scientific computing repositories. Data is provided in CSV format, with each sample including fields such as task ID, science knowledge ablation tag, title, domain, programming language, repository URL, base commit hash, source code license, license family tag, restricted license tag, license gating, materials license, materials license source, materials restrictions, materials gating, materials manifest SHA256, materials source, restriction reason, environment image, verifier image, image platform, task path, status, etc. The default selection includes 96 tasks with unrestricted licenses, plus 23 restricted tasks (18 of which are GPL/LGPL/AGPL family). A subset of 91 tasks with science knowledge ablation is also provided. The dataset is suitable for coding agent evaluation in scientific computing, software engineering task solving, long-term reasoning capability testing, etc. The dataset is licensed under MIT, but third-party materials in some tasks retain their original licenses.
SWE-bench Science 数据集概述
基本信息
- 数据集名称: SWE-bench Science
- 语言: 英语
- 许可证: MIT
- 规模: 小于1000条样本
- 标签: 代码、软件工程、科学计算、编码代理、基准测试、长时间任务
数据集内容
SWE-bench Science 是一个用于评估编码代理在科学计算软件工程任务上表现的基准数据集,包含来自20个科学领域的119个任务,每个任务配备独立的环境和程序化验证器。
关键数据指标
| 指标 | 数值 |
|---|---|
| 任务总数 | 119 |
| 科学领域 | 20 |
| 默认选择(无限制许可任务) | 96 |
| 受限选择 | 23 |
| GPL/LGPL/AGPL系列任务 | 18 |
| 环境镜像 | 119个Docker Hub镜像 |
| 验证器镜像 | 119个Docker Hub镜像 |
| 镜像平台 | linux/amd64 |
科学知识消融拆分
science_knowledge_ablation列为true的任务共91个,用于消融实验- 这些任务的发布ID为:
002-082、084、086、090、097-101、111、114 - 其余所有行的该列为
false
文件结构与功能
| 路径 | 用途 |
|---|---|
data/tasks.csv |
人类可读的任务表格(唯一权威数据源) |
data/statistics.md |
生成的发布统计信息 |
manifests/tasks.jsonl |
规范化机器可读发布清单 |
manifests/release_provenance.json |
权威配置与验证来源记录 |
selections/ |
可复现的任务选择集 |
tasks/task_NNN/ |
精简的Harbor/Pier任务包 |
tools/ |
物化、提供商、批处理和汇总工具 |
docs/run-batch.md |
完整的提供商和批处理运行参考 |
环境镜像包含基线源代码、公共测试夹具、依赖项和编译器;验证器镜像包含保留测试和评分器。数据集不包含参考答案补丁、凭证、代理轨迹或私有验证器测试。
使用与运行
快速开始
- 通过
hf download命令下载数据集到本地 - 使用
python3 tools/materialize.py物化任务(支持默认选择、指定任务ID或范围) - 通过
pier run命令运行评估(支持 Claude Code、mini-swe-agent、Codex 等代理)
受限许可说明
- 23个任务因包含GPL/LGPL/AGPL系列代码、学术非商业来源或受限第三方数据而被排除在默认选择之外
- GPL/LGPL/AGPL系列任务ID为:
003, 020, 021, 023, 032, 057, 066, 074, 075, 082, 083, 084, 085, 096, 097, 098, 100, 118 - 任务
019, 026, 035, 101, 102因其他原因受限 - 需要通过
--allow-restricted-licenses标志显式选择受限任务,且不替代上游许可证义务
许可与归属
- 数据集卡片、发布元数据和辅助工具使用MIT条款
- 任务源代码、论文、图表、测试夹具及其他第三方材料保留其各自上游许可证
- 数据集运行时独立于GitHub,下载后使用本地任务包及Docker Hub上记录的镜像摘要进行物化和评估