
遇见数据集

edbeeching/fineproofs-gpt-oss-120b

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

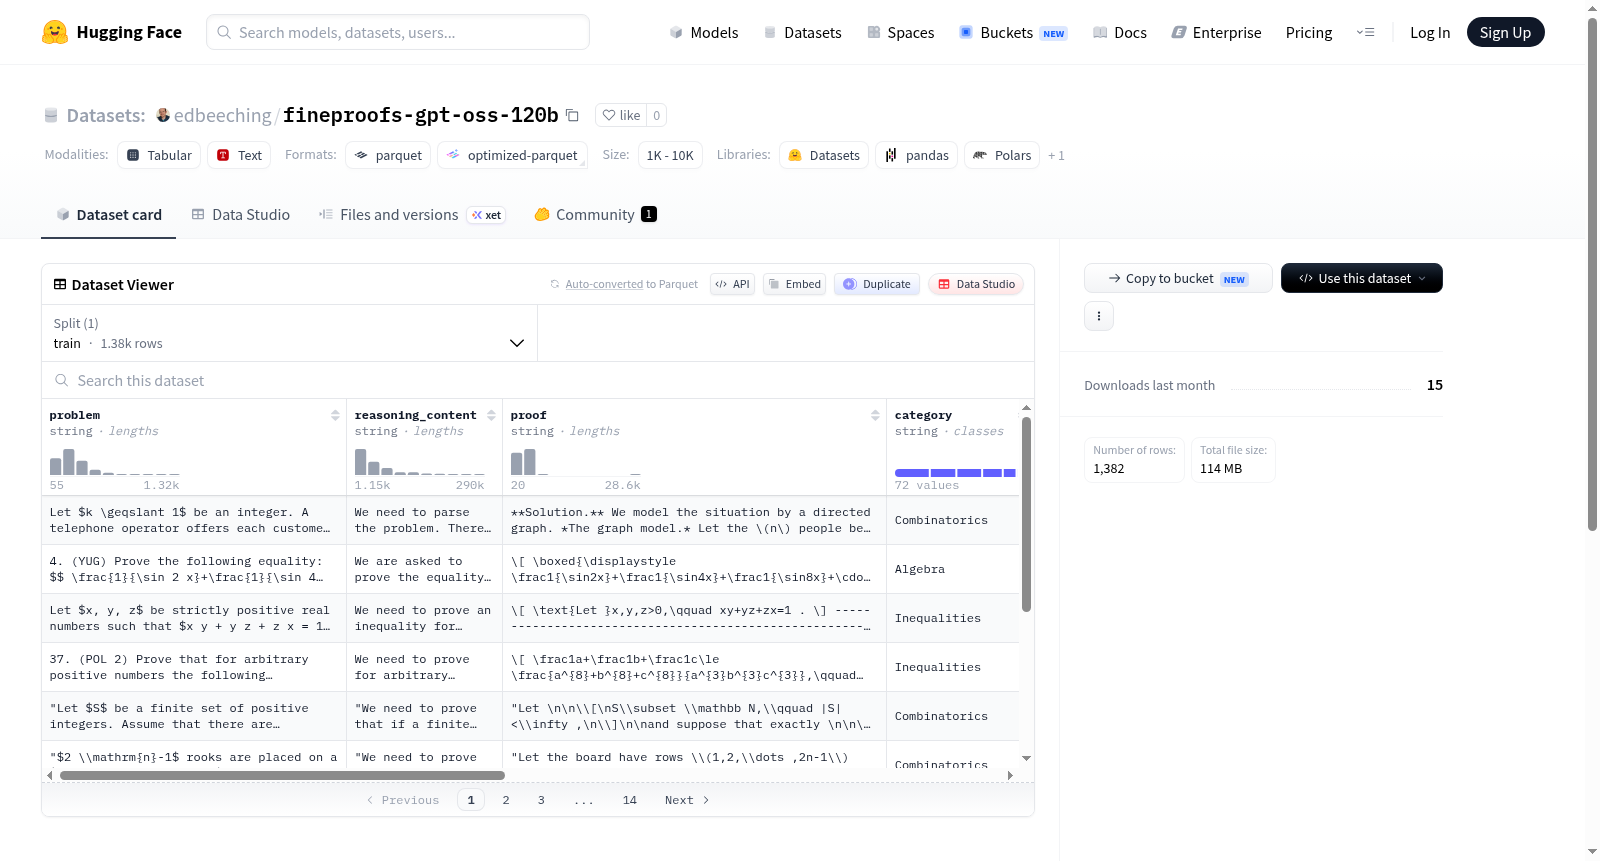
FineProofs GPT-OSS 120B是一个与FineProofs兼容的训练快照数据集,使用openai/gpt-oss-120b模型生成。数据集包含1382行数据,时间戳为2026-05-27T10:04:24Z。其模式与lm-provers/FineProofs-SFT完全匹配,包括问题、推理内容、证明、类别、竞赛、gemini-3-pro-grade、qwen3-4b-thinking-reward@128、来源和消息等字段。GPT-OSS Harmony输出被重新格式化为Qwen风格的助手消息结构。仅包含完整停止生成且非空推理和证明的数据。评分和奖励列存在但留空,因为这些生成的证明尚未评分。

FineProofs GPT-OSS 120B is a FineProofs-compatible training snapshot generated with the openai/gpt-oss-120b model. The dataset contains 1382 rows with a snapshot timestamp of 2026-05-27T10:04:24Z. Its schema exactly matches lm-provers/FineProofs-SFT, including fields such as problem, reasoning_content, proof, category, competition, gemini-3-pro-grade, qwen3-4b-thinking-reward@128, source, and messages. GPT-OSS Harmony outputs are reformatted into Qwen-style assistant messages. Only complete generations with finish_reason=stop and non-empty reasoning and proof are included. The grade and reward columns are present for schema compatibility but left null as these generated proofs have not been graded.
提供机构:
edbeeching
搜集汇总
数据集介绍
edbeeching/fineproofs-gpt-oss-120b 数据集图片
构建方式
该数据集是基于OpenAI的GPT-OSS-120B模型生成的训练快照,专为与FineProofs框架兼容而设计。构建过程严格遵循原始FineProofs-SFT数据集的模式架构,将GPT-OSS Harmony模型的输出重新格式化为Qwen风格的助手消息,即通过`<think>`标签封装推理内容,随后衔接证明部分。仅选取推理与证明均完整且生成结束原因为`stop`的样本,确保了数据的高质量与完整性。同时,为保持模式一致性,保留但置空评分列,因为这些生成的证明尚未经过人工或自动评估。
特点
该数据集包含1382个样本,每一样本涵盖问题、推理内容、证明、类别、竞赛信息、评分列及消息序列等多个字段,结构完备。其核心特色在于高质量的生成控制,仅收录完整生成的实例,保证了数据的可用性。与FineProofs生态的无缝兼容性是其另一亮点,可直接用于相关模型的训练与评估。此外,评分字段的保留为后续扩展验证提供了接口,尽管当前置空,但为未来集成自动化评估体系预留了空间。
使用方法
使用者可将其直接作为FineProofs训练管道的输入,因其模式与`lm-provers/FineProofs-SFT`完全一致。具体应用时,可加载parquet文件中的训练分割,并利用`problem`字段作为输入,`proof`或`messages`字段作为目标输出进行监督学习。由于评分列暂为空,建议在训练前根据需求自行评估或忽略这些字段。该数据集适合用于数学证明生成任务的模型微调,或作为基准测试GPT-OSS模型在形式化证明领域的性能。
背景与挑战
背景概述
随着大语言模型在数学推理与形式化证明领域的深度融合,自动生成可验证的证明已成为人工智能研究的核心前沿。FineProofs GPT-OSS 120B数据集由研究者于2026年5月27日创建,基于OpenAI的GPT-OSS-120B模型,旨在构建一个与FineProofs-SFT格式完全兼容的训练快照。该数据集聚焦于形式化数学证明的生成任务,涵盖1382条高质量样本,每条包含问题、推理链、证明文本及类别等信息,其设计初衷在于弥补现有证明生成数据集在规模与多样性上的不足,并推动AI辅助数学发现与验证的研究进程。作为一项创新性资源,该数据集为后续模型在数学推理能力上的提升提供了坚实的数据基础,并有望在自动定理证明、智能教育等领域产生广泛影响。
当前挑战
该数据集所面临的挑战是多维度的。在领域层面,核心难题是形式化证明的自动生成需兼顾逻辑严谨性与自然语言表达的灵活性,同时不同数学分支(如代数、几何、数论)的证明结构差异显著,对模型的通用性提出高要求。此外,证明的验证过程依赖外部工具或人工审核,自动化程度受限。在构建过程中,挑战主要体现在数据的纯净性和一致性上:仅保留完整生成的样本,严格过滤未终止或不完整的推理,确保每条记录包含有效的推理与证明部分;同时,为了与FineProofs-SFT模式对齐,需将模型输出重新格式化为Qwen风格的助手消息,这一转换过程易引入格式错误。更为关键的是,数据集中评分列(如gemini-3-pro-grade、qwen3-4b-thinking-reward)被置空,因为生成的证明尚未经过验证,这限制了数据在奖励模型训练中的直接应用,也凸显了自动化评估机制缺失的紧迫性。
常用场景
经典使用场景
在数学推理与自动定理证明的广阔天地中,FineProofs-gpt-oss-120b数据集以其独特身份,成为连接大规模语言模型与形式化验证的桥梁。其经典用途在于,作为FineProofs-SFT的兼容训练快照,用于微调开源模型,使其掌握生成严谨数学证明的能力。研究者利用该数据集,输入待证命题作为question,驱动模型产出结构化的think过程与终末proof,从而在数学竞赛与奥林匹克级别的问题上,锤炼模型的演绎思维与步骤推导能力,推动神经符号主义在数学文本生成中的融合。
衍生相关工作
该数据集的衍生影响波及多个前沿工作线。其一,它启发了对‘模型自生成训练数据’元学习范式的探索,即利用强大模型输出反向训练更小模型,实现知识蒸馏。其二,基于此快照,研究者开发了针对数学推理质量的奖励模型,即使原始grade列为空,也促使了无监督或弱监督评估方法的研究。其三,它推动了跨领域数据对齐工作,如将证明片段与自然语言推理桥接,为多模态数学推理系统奠定了数据基础,在自动化定理证明的竞赛中开辟了新的训练策略。
数据集最近研究
最新研究方向
基于GPT-OSS-120B模型的数学证明自动生成与FineProofs兼容性训练快照构建,聚焦于通过大语言模型合成形式化证明数据,并探索跨模型风格迁移(如将GPT-OSS输出重构为Qwen风格消息格式),以扩展高质量数学推理数据集的覆盖范围,同时为后续基于奖励模型或元评分的自动证明质量评估奠定基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

