ivirits-audio-v2-30s
收藏资源简介:
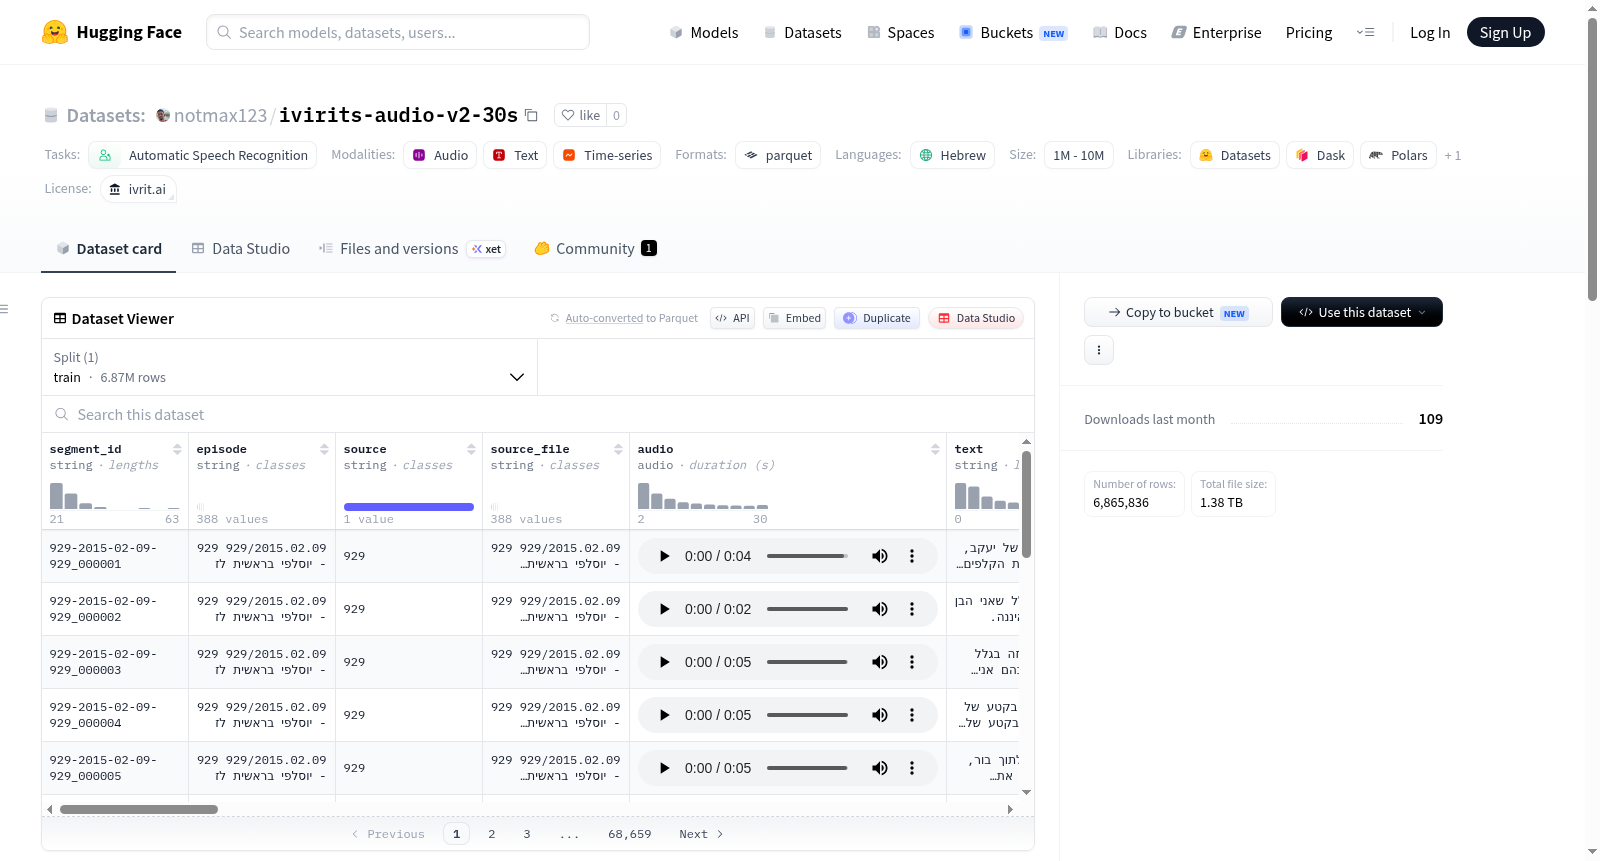
ivrit.ai audio-v2 数据集是一个面向希伯来语自动语音识别(ASR)微调的大规模语音数据集,包含超过 20,000 小时的希伯来语音频,经过 VAD(语音活动检测)切割为 2–30 秒的语音片段,并使用 Whisper 模型(ivrit-ai/whisper-large-v3-turbo)生成机器转录文本。数据来源于 ivrit-ai/audio-v2 原始数据,通过 Silero VAD 进行语音检测,对于超过 30 秒的语音区域在静默处分割,短于 2 秒的片段被丢弃。所有音频被重采样为 16 kHz 单声道 FLAC 格式,并嵌入在 Parquet 分片中。数据集包含以下字段:segment_id(稳定标识符)、episode/source(原始音频路径和来源)、audio(FLAC 音频)、text(Whisper 转录文本)、start_sec/end_sec/duration_sec(在源音频中的偏移)、mean_token_logprob/token_confidence(解码器置信度,可用于过滤)、vad_confidence_*/vad_speech_ratio(Silero 语音概率)。由于转录由机器生成且未经人工验证,建议在训练前根据 token_confidence 和 vad_speech_ratio 进行过滤。该数据集继承了 ivrit.ai 许可证。
The ivrit.ai audio-v2 dataset is a large-scale speech dataset for fine-tuning Hebrew automatic speech recognition (ASR), containing over 20,000 hours of Hebrew audio. It is segmented into 2–30 second speech clips using VAD (Voice Activity Detection) and transcribed by the Whisper model (ivrit-ai/whisper-large-v3-turbo). The data originates from ivrit-ai/audio-v2 raw data, with speech detection performed by Silero VAD. Speech regions longer than 30 seconds are segmented at silence points, and clips shorter than 2 seconds are discarded. All audio is resampled to 16 kHz mono FLAC format and embedded in Parquet shards. The dataset includes the following fields: segment_id (stable identifier), episode/source (original audio path and source), audio (FLAC audio), text (Whisper transcription), start_sec/end_sec/duration_sec (offset in the source audio), mean_token_logprob/token_confidence (decoder confidence, useful for filtering), vad_confidence_*/vad_speech_ratio (Silero speech probability). Since the transcription is machine-generated and not human-verified, it is recommended to filter based on token_confidence and vad_speech_ratio before training. The dataset inherits the ivrit.ai license.
数据集概述:ivirits-audio-v2-30s
基本信息
- 数据集名称:ivrit.ai audio-v2 — 2–30 s segments
- 语言:希伯来语(he)
- 任务类别:自动语音识别(ASR)
- 许可证:其他(继承自 ivrit.ai 许可证,详情见 ivrit.ai 许可证页面)
- 数据规模:1M < n < 10M 条记录
数据集内容
该数据集源自 ivrit-ai/audio-v2(包含超过 2 万小时的希伯来语音频),将其切分为 2–30 秒的语音片段,并附有机翻文本,可直接用于 ASR 模型微调。
构建流程
- 语音活动检测(VAD):使用 Silero VAD(ONNX)对每个解码为 16 kHz 单声道的剧集进行处理。超过 30 秒的语音区域会在窗口内最安静的足够长停顿处进行切分,确保切割点位于静音处而非词中;短于 2 秒的区域被丢弃。
- 转写:使用 ivrit-ai/whisper-large-v3-turbo 模型,通过 vLLM 服务,采用贪婪解码,语言设置为希伯来语(
language=he)。 - 打包:将 FLAC 格式的 16 kHz 单声道音频嵌入 parquet 分片文件中。
数据规模统计
| 项目 | 数值 |
|---|---|
| 语音片段数 | 约 650 万(~6.5M) |
| parquet 分片数 | 2,343 |
| 总大小 | 1.38 TB |
| 源剧集数 | 34,879 / 34,879(100%) |
| 片段长度 | 2–30 秒(硬性边界) |
数据列说明
| 列名 | 含义 |
|---|---|
segment_id |
稳定 ID,格式为 {剧集名}_{六位序号} |
episode / source |
源剧集路径及 audio-v2 中的顶级来源 |
audio |
FLAC 格式,16 kHz 单声道音频 |
text |
Whisper 模型生成的转写文本 |
start_sec / end_sec / duration_sec |
在源剧集中的时间偏移 |
mean_token_logprob / token_confidence |
解码器置信度,可用于过滤低质量片段 |
vad_confidence_* / vad_speech_ratio |
Silero 语音概率,反映片段的语音占比 |
重要说明
- 转写文本为机器生成且未经人工验证。建议在训练前基于
token_confidence、compression_ratio和vad_speech_ratio进行过滤——低token_confidence配合高compression_ratio通常是 Whisper 循环(loop)现象的典型特征。 - 不包含词级时间戳:转写通过 vLLM 解码生成,该工具不产生词级时间对齐所需的交叉注意力对齐信息。
token_logprobs提供的是逐 token 的置信度。
许可证
本数据集继承了源数据集 ivrit.ai audio-v2 的 ivrit.ai 许可证。