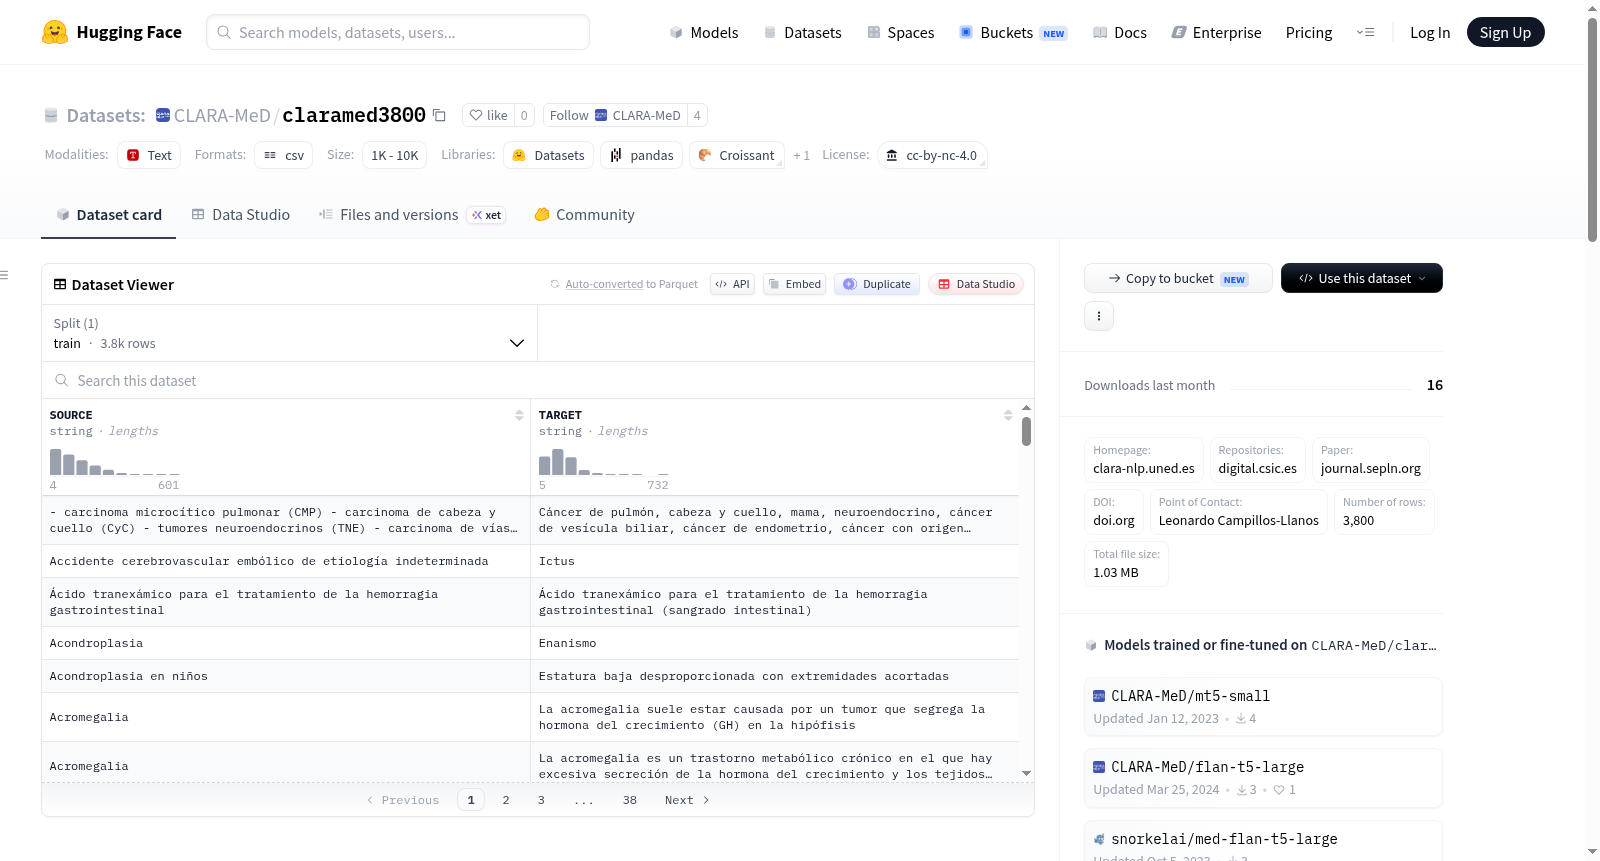
CLARA-MeD/claramed3800
收藏资源简介:
--- license: cc-by-nc-4.0 --- # Dataset Card for CLARA-MeD-3800 ## Table of Contents - [Table of Contents](#table-of-contents) - [Dataset Description](#dataset-description) - [Dataset Summary](#dataset-summary) - [Supported Tasks and Leaderboards](#supported-tasks-and-leaderboards) - [Languages](#languages) - [Dataset Structure](#dataset-structure) - [Data Instances](#data-instances) - [Data Fields](#data-fields) - [Dataset Creation](#dataset-creation) - [Source Data](#source-data) - [Annotations](#annotations) - [Personal and Sensitive Information](#personal-and-sensitive-information) - [Additional Information](#additional-information) - [Dataset Curators](#dataset-curators) - [Licensing Information](#licensing-information) - [Citation Information](#citation-information) - [Contributions](#contributions) ## Dataset Description - **Homepage:** [https://clara-nlp.uned.es/home/med/](https://clara-nlp.uned.es/home/med/) - **Repositories:** [https://github.com/lcampillos/CLARA-MeD](https://github.com/lcampillos/CLARA-MeD), [https://digital.csic.es/handle/10261/269887](https://digital.csic.es/handle/10261/269887) - **Paper:** [http://journal.sepln.org/sepln/ojs/ojs/index.php/pln/article/view/6439](http://journal.sepln.org/sepln/ojs/ojs/index.php/pln/article/view/6439) - **DOI:** [https://doi.org/10.20350/digitalCSIC/14644](https://doi.org/10.20350/digitalCSIC/14644) - **Point of Contact:** [Leonardo Campillos-Llanos](leonardo.campillos@csic.es) ### Dataset Summary A parallel corpus with a subset of 3800 sentence pairs of professional and laymen variants (149 862 tokens) as a benchmark for medical text simplification. This dataset was collected in the CLARA-MeD project, with the goal of simplifying medical texts in the Spanish language and reducing the language barrier to patient's informed decision making. ### Supported Tasks and Leaderboards Medical text simplification ### Languages Spanish ## Dataset Structure ### Data Instances For each instance, there is a string for the source text (professional version), and a string for the target text (simplified version). ``` {'SOURCE': 'adenocarcinoma ductal de páncreas' 'TARGET': 'Cáncer de páncreas'} ``` ### Data Fields - `SOURCE`: a string containing the professional version. - `TARGET`: a string containing the simplified version. ## Dataset Creation ### Source Data #### Who are the source language producers? 1. Drug leaflets and summaries of product characteristics from [CIMA](https://cima.aemps.es) 2. Cancer-related information summaries from the [National Cancer Institute](https://www.cancer.gov/) 3. Clinical trials announcements from [EudraCT](https://www.clinicaltrialsregister.eu/) ### Annotations #### Annotation process Semi-automatic alignment of technical and patient versions of medical sentences. Inter-annotator agreement measured with Cohen's Kappa (average Kappa = 0.839 +- 0.076; very high agreement). #### Who are the annotators? Leonardo Campillos-Llanos Adrián Capllonch-Carriónb Ana Rosa Terroba-Reinares Ana Valverde-Mateos Sofía Zakhir-Puig ### Personal and Sensitive Information No personal and sensitive information was used. ### Licensing Information These data are aimed at research and educational purposes, and released under a Creative Commons Non-Commercial Attribution (CC-BY-NC-A) 4.0 International License. ### Citation Information Campillos Llanos, L., Terroba Reinares, A. R., Zakhir Puig, S., Valverde, A., & Capllonch-Carrión, A. (2022). Building a comparable corpus and a benchmark for Spanish medical text simplification. *Procesamiento del lenguaje natural*, 69, pp. 189--196. ``` @article{2022claramedcorpus, title={Building a comparable corpus and a benchmark for Spanish medical text simplification}, author={Campillos-Llanos, Leonardo and Terroba Reinares, Ana R., and Zakhir Puig, Sofía, and Valverde-Mateos, Ana and Capllonch-Carri{\'o}n}, title={Procesamiento del Lenguaje Natural}, volume={69}, year={2022}, pages={189--196}, publisher={Sociedad Espa{\~n}ola para el Procesamiento del Lenguaje Natural} } ``` ### Contributions Thanks to [Jónathan Heras from Universidad de La Rioja](http://www.unirioja.es/cu/joheras) ([@joheras](https://github.com/joheras)) for formatting this dataset for Hugging Face.
--- 许可证:CC-BY-NC-4.0 --- # CLARA-MeD-3800 数据集卡片 ## 目录 - [目录](#table-of-contents) - [数据集描述](#dataset-description) - [数据集概述](#dataset-summary) - [支持任务与排行榜](#supported-tasks-and-leaderboards) - [语言](#languages) - [数据集结构](#dataset-structure) - [数据实例](#data-instances) - [数据字段](#data-fields) - [数据集构建](#dataset-creation) - [源数据](#source-data) - [标注流程](#annotations) - [个人与敏感信息](#personal-and-sensitive-information) - [附加信息](#additional-information) - [数据集策展人](#dataset-curators) - [许可信息](#licensing-information) - [引用信息](#citation-information) - [贡献致谢](#contributions) ## 数据集描述 - **主页:** [https://clara-nlp.uned.es/home/med/](https://clara-nlp.uned.es/home/med/) - **仓库地址:** [https://github.com/lcampillos/CLARA-MeD](https://github.com/lcampillos/CLARA-MeD), [https://digital.csic.es/handle/10261/269887](https://digital.csic.es/handle/10261/269887) - **相关论文:** [http://journal.sepln.org/sepln/ojs/ojs/index.php/pln/article/view/6439](http://journal.sepln.org/sepln/ojs/ojs/index.php/pln/article/view/6439) - **DOI:** [https://doi.org/10.20350/digitalCSIC/14644](https://doi.org/10.20350/digitalCSIC/14644) - **联系方式:** [Leonardo Campillos-Llanos](leonardo.campillos@csic.es) ### 数据集概述 本数据集为平行语料库,包含3800组专业医学文本与通俗文本的句子对(共计149862个Token(Token)),可作为医学文本简化任务的基准数据集。本数据集源自CLARA-MeD项目,旨在实现西班牙语医学文本的简化,破除语言壁垒,助力患者做出知情决策。 ### 支持任务与排行榜 医学文本简化 ### 语言 西班牙语 ## 数据集结构 ### 数据实例 每个数据实例包含源文本(专业版本)字符串与目标文本(简化版本)字符串。 {'SOURCE': '胰腺导管腺癌', 'TARGET': '胰腺癌'} ### 数据字段 - `SOURCE`:字符串类型,存储专业版本的医学文本。 - `TARGET`:字符串类型,存储简化后的通俗医学文本。 ## 数据集构建 ### 源数据 #### 源语言文本的创作者 1. 来自[CIMA](https://cima.aemps.es)的药品说明书与产品特性摘要 2. 来自[美国国家癌症研究所(National Cancer Institute)](https://www.cancer.gov/)的癌症相关信息摘要 3. 来自[EudraCT](https://www.clinicaltrialsregister.eu/)的临床试验公告 ### 标注流程 #### 标注过程 对医学文本的专业版本与患者友好版本进行半自动化对齐。采用科恩卡帕系数(Cohen's Kappa)评估标注者间一致性,平均卡帕值为0.839 ± 0.076,一致性极高。 #### 标注者名单 Leonardo Campillos-Llanos、Adrián Capllonch-Carrión、Ana Rosa Terroba-Reinares、Ana Valverde-Mateos、Sofía Zakhir-Puig ### 个人与敏感信息 本数据集未使用任何个人与敏感信息。 ## 附加信息 ### 数据集策展人 无公开信息 ### 许可信息 本数据集仅用于研究与教育目的,采用知识共享署名-非商业性使用4.0国际许可协议(CC-BY-NC-4.0)发布。 ### 引用信息 Campillos-Llanos, L., Terroba Reinares, A. R., Zakhir Puig, S., Valverde-Mateos, A., & Capllonch-Carrión, A. (2022). 构建西班牙语医学文本简化的可比语料库与基准数据集. *Procesamiento del lenguaje natural(自然语言处理)*, 69, 第189-196页. @article{2022claramedcorpus, title={构建西班牙语医学文本简化的可比语料库与基准数据集}, author={Campillos-Llanos, Leonardo and Terroba Reinares, Ana R., and Zakhir Puig, Sofía, and Valverde-Mateos, Ana and Capllonch-Carrión, Adrián}, journal={Procesamiento del lenguaje natural(自然语言处理)}, volume={69}, year={2022}, pages={189--196}, publisher={Sociedad Española para el Procesamiento del Lenguaje Natural(西班牙自然语言处理学会)} } ### 贡献致谢 感谢来自拉里奥哈大学的Jónathan Heras([http://www.unirioja.es/cu/joheras](http://www.unirioja.es/cu/joheras),GitHub账号[@joheras](https://github.com/joheras))为本数据集适配Hugging Face格式。
数据集概述
数据集名称
CLARA-MeD-3800
数据集摘要
CLARA-MeD-3800是一个包含3800对专业和非专业(简化)版本的西班牙语医学文本的平行语料库。该数据集旨在简化医学文本,减少患者理解医学信息的语言障碍。
支持的任务
医学文本简化
语言
西班牙语
数据集结构
数据实例
每个实例包含两个字段:
SOURCE: 包含专业版本的字符串。TARGET: 包含简化版本的字符串。
数据字段
SOURCE: 专业版本的医学文本。TARGET: 简化版本的医学文本。
数据集创建
源数据
- 来源包括药品传单、产品特性概要、癌症相关信息摘要和临床试验公告。
标注过程
- 采用半自动方式对技术版本和患者版本的医学句子进行对齐。
- 标注者间一致性通过Cohens Kappa测量,平均Kappa值为0.839。
标注者
- Leonardo Campillos-Llanos
- Adrián Capllonch-Carrión
- Ana Rosa Terroba-Reinares
- Ana Valverde-Mateos
- Sofía Zakhir-Puig
个人和敏感信息
- 数据集中不包含个人和敏感信息。
许可证信息
- 数据集遵循Creative Commons Non-Commercial Attribution (CC-BY-NC-A) 4.0国际许可证。
引用信息
@article{2022claramedcorpus, title={Building a comparable corpus and a benchmark for Spanish medical text simplification}, author={Campillos-Llanos, Leonardo and Terroba Reinares, Ana R., and Zakhir Puig, Sofía, and Valverde-Mateos, Ana and Capllonch-Carri{o}n}, title={Procesamiento del Lenguaje Natural}, volume={69}, year={2022}, pages={189--196}, publisher={Sociedad Espa{~n}ola para el Procesamiento del Lenguaje Natural} }