
遇见数据集

RADAR

收藏
Hugging Face2026-07-06 更新2026-07-07 收录
官方服务:

资源简介:

RADAR数据集是一个用于训练腹部CT诊断通用视觉-语言模型的大规模医学影像数据集。该数据集旨在支持开发能够实现专家级诊断性能的人工智能模型,覆盖广泛的临床任务。数据集包含超过40万次增强腹部CT检查,从中提取了1500万个解剖层面的图像-文本对。数据直接从临床报告中学习,无需人工标注,涵盖了18个解剖结构和146个影像学发现。数据集包含CT图像和对应的临床报告文本,形成视觉-语言对,适用于医学影像诊断、视觉-语言预训练、腹部CT分析等任务。数据经过预处理,包括图像调整大小和解剖结构分割掩码的生成。

The RADAR dataset is a large-scale medical imaging dataset for training general vision-language models for abdominal CT diagnosis. It aims to support the development of AI models with expert-level diagnostic performance, covering a wide range of clinical tasks. The dataset includes over 400,000 enhanced abdominal CT examinations, from which 15 million image-text pairs at the anatomical level are extracted. Data is learned directly from clinical reports without manual annotation, covering 18 anatomical structures and 146 imaging findings. The dataset contains CT images and corresponding clinical report texts, forming vision-language pairs, suitable for tasks such as medical image diagnosis, vision-language pre-training, and abdominal CT analysis. Data is preprocessed, including image resizing and generation of anatomical structure segmentation masks.

创建时间:
2026-07-03
原始信息汇总
  • 数据集名称:RADAR(RADAR: An Expert-Level Generalist AI for Abdominal CT Diagnosis)
  • 许可证:CC BY-NC-SA 4.0
  • 语言:英语
  • 标签:视觉语言预训练、医学、CT诊断
  • 数据集规模:包含超过40万例增强腹部CT检查,以及1500万个体素级别的图像-文本对
  • 数据来源:直接来自临床报告,无需人工标注
  • 覆盖范围:涵盖18个解剖结构和146种影像学发现
  • 模型性能:在多个中心和多种场景的内部及外部评估中,实现了高诊断性能和稳健的泛化能力。在读者研究中,AI辅助使26名放射科医生的诊断灵敏度提高了约10%
  • 预训练模型与支持文件:提供多个预训练模型检查点,包括RADAR预训练、RADAR+从头训练、RADAR+微调等,以及中英文BERT分词器和模型、视觉分支(UNet)检查点。另提供可选的CT图像和解剖掩码数据(用于演示)
  • 相关链接:数据集页面地址为 https://huggingface.co/datasets/radar-generalist/RADAR
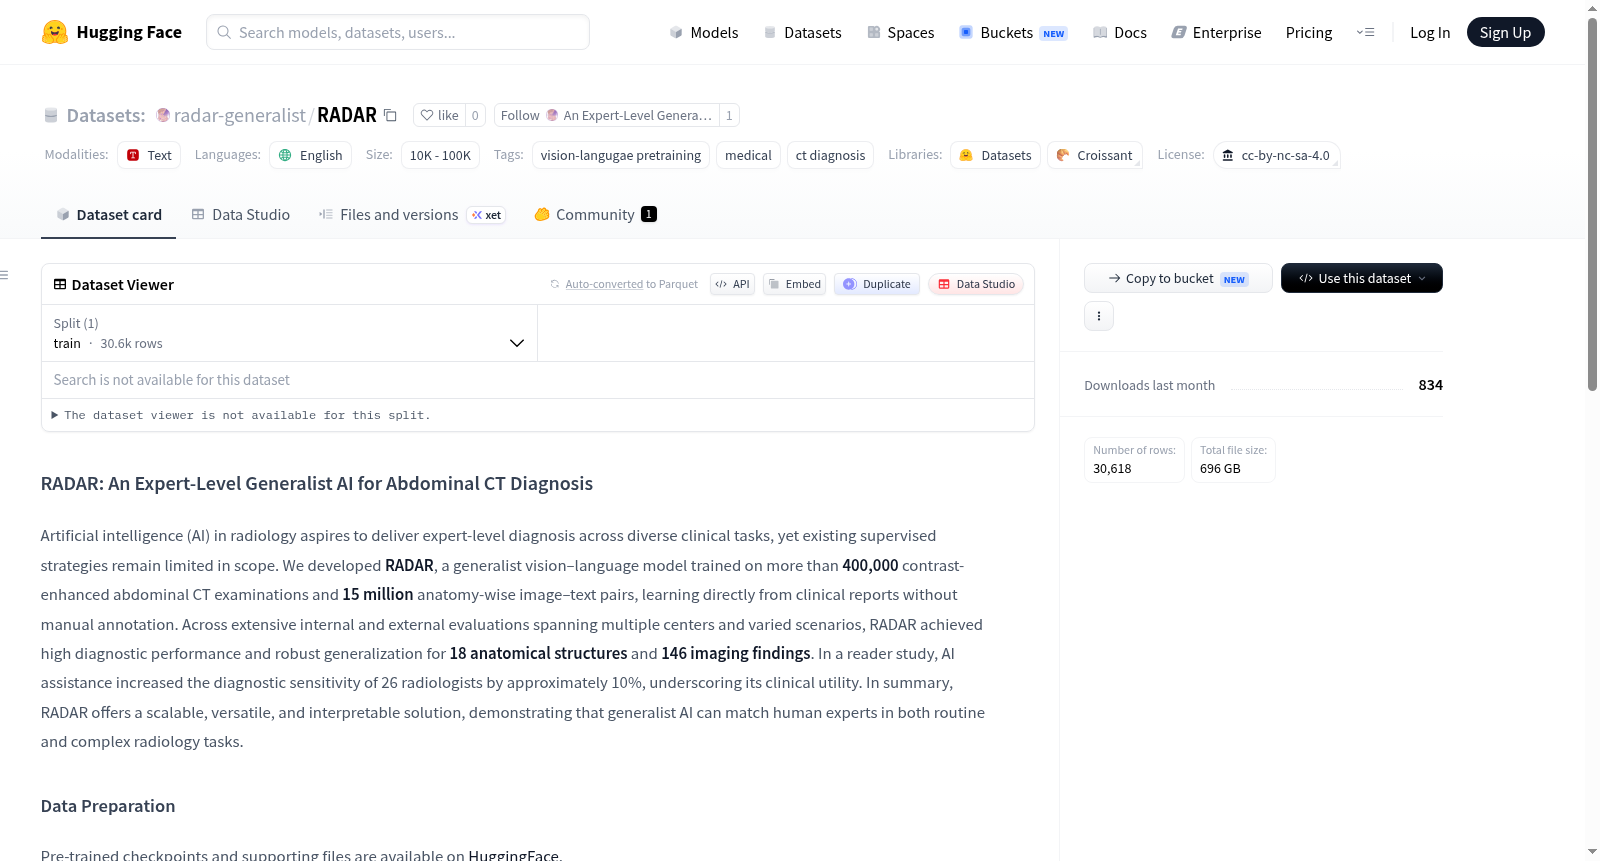
搜集汇总
数据集介绍
RADAR 数据集图片
构建方式
RADAR数据集基于超过40万次腹部增强CT检查构建,通过自动化流程从临床放射学报告中提取信息,生成了约1500万个解剖学图像-文本对。其构建无需人工标注,直接利用现有医疗记录中的结构化报告与影像数据,实现了大规模、低成本的训练数据准备。该过程依赖于对CT图像进行标准化预处理,并借助TotalSegmentator工具自动生成解剖结构掩膜,最终形成与文本描述对应的精细化配对数据。
特点
RADAR数据集的核心特点在于其通用性与临床级诊断能力,覆盖18个解剖结构和146种影像学发现,支持多中心、多场景下的腹部CT诊断任务。其视觉-语言预训练模型直接学习临床报告中的专家知识,无需人工标注,确保了数据的高效利用与可扩展性。此外,在读取研究中,该数据集训练的模型将26名放射科医生的诊断灵敏度提升了约10%,彰显了其显著的临床辅助价值。
使用方法
使用RADAR数据集需从HuggingFace下载预训练模型检查点及配套文件,包括BERT分词器与视觉分支UNet权重。数据准备阶段需将CT图像重采样至统一间距并生成解剖掩膜,然后加载预训练检查点以初始化模型。用户可依据提供的演示数据集快速上手,通过调用标准接口对腹部CT影像进行推理,实现多结构、多发现的自动化诊断分析。
背景与挑战
背景概述
医学影像人工智能领域长期致力于实现与人类专家媲美的诊断能力,然而传统监督学习策略因其功能局限而难以覆盖多样化的临床任务。在此背景下,RADAR数据集于2024年发布,由国际研究团队基于超过40万例腹部增强CT扫描及1500万条解剖学影像-文本对构建而成,旨在开发一种能够直接从临床报告中学习、无需人工标注的通用视觉-语言模型。该数据集覆盖18个解剖结构与146种影像学发现,并通过多中心、多场景的内部与外部验证展现出卓越的诊断性能与泛化能力。一项包含26名放射科医生的读片研究显示,RADAR辅助使诊断灵敏度提升约10%,凸显了其在临床实践中的潜在价值。RADAR的诞生标志着通用型人工智能在腹部CT诊断领域迈出了关键一步,为构建可扩展、多用途且可解释的医学影像分析系统奠定了坚实基础。
当前挑战
RADAR数据集面临的核心挑战首先在于解决医学影像诊断领域的根本问题——如何突破传统模型在临床任务中功能受限的瓶颈,实现从单一任务到多解剖结构、多影像发现的通用诊断能力。具体而言,需应对异质性临床报告中的噪声干扰、不同成像协议与设备间的域差异,以及罕见病症样本稀少带来的学习不平衡。其次,在数据集构建过程中,面临从超过40万例CT检查中自动提取高质量、语义一致的影像-文本对的艰巨任务,这要求精确对齐解剖学区域与相关描述,同时避免人工标注的主观偏差与高昂成本。此外,确保模型在长程依赖和三维空间结构上的鲁棒性,以及缓解大规模预训练中的灾难性遗忘问题,亦构成技术层面的显著挑战。
常用场景
经典使用场景
RADAR数据集专为腹部CT诊断的视觉-语言预训练而构建,涵盖超过40万例增强CT检查和1500万解剖学级别的图像-文本对。其经典使用场景在于训练一个通用型放射学AI模型,能够同时处理18个解剖结构和146种影像学发现,无需人工标注即可从临床报告中自主学习。这一特性使其成为跨科室、跨协议、跨设备的多任务诊断研究的理想数据基石。
衍生相关工作
基于RADAR数据集,衍生了一系列相关研究工作,包括RADAR+(在Merlin-CT-Train数据集上从头训练的增强版本)、VisionBranch(基于UNet的视觉分支预训练)以及解剖级分割与诊断联合模型。这些工作探索了视觉-语言预训练在医学影像中的拓展方向,推动了多模态医学AI从单任务向通用型、从有监督向弱监督的演进,启发后续研究者构建更轻量、更高效的临床AI系统。
数据集最近研究
最新研究方向
在医学影像分析领域,RADAR数据集引领了从专用模型向通用型人工智能的范式转变。其核心在于构建了一个基于超过40万例增强腹部CT检查与1500万解剖学图像-文本对的视觉-语言预训练模型,直接利用临床报告进行学习,无需人工标注。这一方向突破了传统监督学习在泛化能力上的局限,在18个解剖结构和146项影像学发现上展现出专家级的诊断性能。近期研究热点聚焦于该数据集在跨中心、多场景下的鲁棒泛化能力验证,以及在读片人试验中AI辅助将26名放射科医师的诊断灵敏度提升约10%的临床价值。RADAR的提出不仅为放射学通用人工智能树立了新标杆,其可扩展、可解释的解决方案也推动了智能诊断从实验室走向临床广泛部署的进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

