
mms-tts-uig-script_arabic-UQSpeech
收藏官方服务:
资源简介:
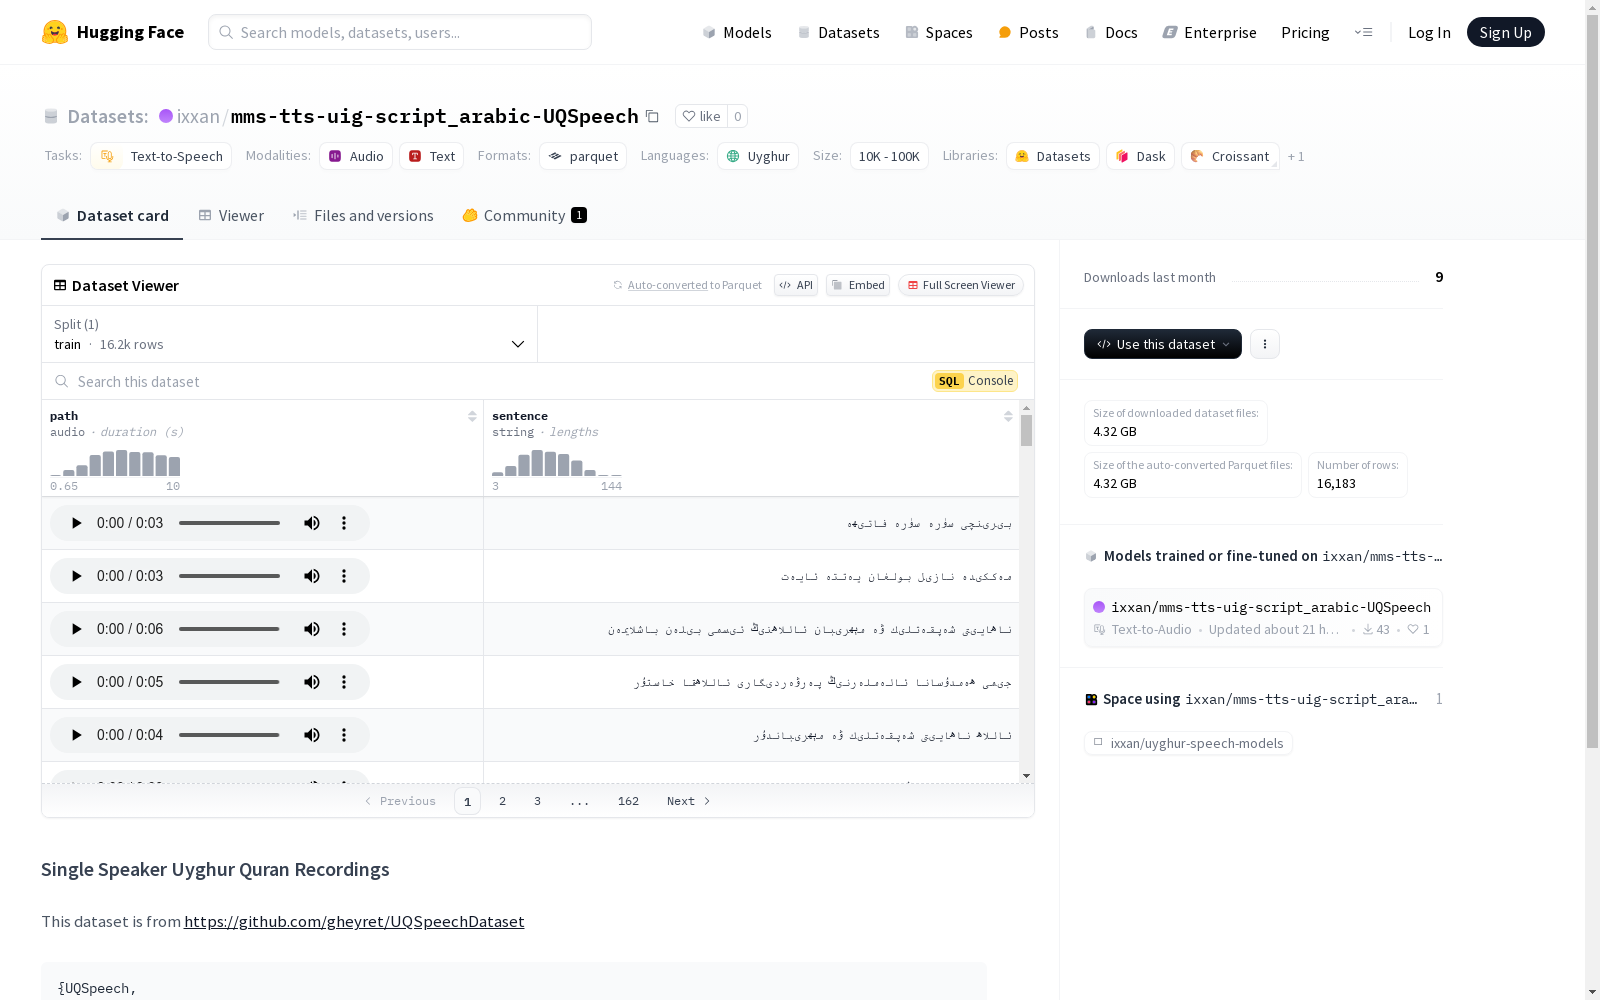
该数据集名为Single Speaker Uyghur Quran Recordings,包含维吾尔语的单说话者古兰经录音。数据集的特征包括音频路径和句子文本,音频采样率为16000Hz。数据集只有一个训练分割,包含16183个样本,总大小为4345803734.966字节。数据集的任务类别是文本到语音转换,语言为维吾尔语(ug)。数据集来自GitHub上的UQSpeechDataset项目,作者为Gheyret Kenji,发布于2019年。
The dataset named Single Speaker Uyghur Quran Recordings contains single-speaker Quran recordings in Uyghur. Its features include audio paths and sentence texts, with an audio sampling rate of 16000 Hz. The dataset only has one training split, comprising 16183 samples with a total size of 4345803734.966 bytes. The task category of this dataset is text-to-speech, and the language is Uyghur (ug). This dataset originates from the UQSpeechDataset project hosted on GitHub, authored by Gheyret Kenji, and was released in 2019.
创建时间:
2024-12-25
搜集汇总
数据集介绍
构建方式
该数据集来源于UQSpeech项目,由Gheyret Kenji于2019年创建,旨在提供高质量的维吾尔语《古兰经》朗读录音。数据集的构建过程包括从公开资源中收集音频文件,并对其进行标准化处理,确保音频采样率为16000Hz。每个音频文件均配有对应的文本句子,形成了音频与文本的配对数据。数据集以训练集的形式发布,包含16183个样本,总大小约为4.35GB。
特点
该数据集的核心特点在于其专注于单一说话者的维吾尔语《古兰经》朗读录音,具有高度的语言和文化特异性。音频文件的采样率为16000Hz,确保了音质的清晰度与一致性。每个音频文件均与对应的文本句子精确匹配,为文本到语音(TTS)任务提供了高质量的标注数据。数据集的规模适中,适合用于训练和评估维吾尔语TTS模型,同时也为语言学和语音学研究提供了宝贵的资源。
使用方法
该数据集主要用于文本到语音(TTS)任务的训练与评估。用户可以通过加载数据集中的音频文件及其对应的文本句子,构建TTS模型的输入输出对。由于数据集已标准化处理,用户可直接使用其提供的音频采样率和文本格式,无需额外预处理。此外,数据集还可用于维吾尔语语音合成技术的研究与开发,以及跨语言语音模型的迁移学习实验。通过结合深度学习框架,用户能够高效地利用该数据集进行模型训练与性能优化。
背景与挑战
背景概述
mms-tts-uig-script_arabic-UQSpeech数据集由Gheyret Kenji于2019年创建,主要聚焦于维吾尔语的文本到语音(TTS)转换任务。该数据集的核心研究问题在于如何高效地将维吾尔语文本转化为自然流畅的语音输出,特别是在宗教文本如《古兰经》的诵读场景中。数据集包含了16183条训练样本,采样率为16000Hz,总大小约为4.3GB。这一数据集的发布为维吾尔语语音合成领域提供了宝贵的资源,推动了该语言在语音技术中的应用与发展。
当前挑战
mms-tts-uig-script_arabic-UQSpeech数据集面临的挑战主要体现在两个方面。首先,维吾尔语作为一种低资源语言,其语音数据的稀缺性使得模型的训练和优化变得尤为困难,尤其是在保持语音的自然性和准确性方面。其次,数据集的构建过程中,如何确保录音质量的一致性以及文本与语音的精确对齐,也是一个技术难点。此外,宗教文本的特殊性要求语音合成模型在发音和语调上具备更高的精确度,这进一步增加了数据处理的复杂性。
常用场景
经典使用场景
在语音合成领域,mms-tts-uig-script_arabic-UQSpeech数据集为研究者提供了一个高质量的维吾尔语单说话者语音样本库。该数据集特别适用于开发基于深度学习的文本到语音(TTS)系统,尤其是在处理维吾尔语这种资源相对稀缺的语言时,能够显著提升模型的准确性和自然度。
解决学术问题
该数据集有效解决了维吾尔语语音合成研究中数据稀缺的问题。通过提供大量高质量的语音样本,研究者能够更深入地探索维吾尔语的语音特性,优化语音合成模型的表现。这不仅推动了维吾尔语语音技术的发展,也为其他低资源语言的语音合成研究提供了宝贵的参考。
衍生相关工作
基于该数据集,研究者们已经开发了多种先进的维吾尔语语音合成模型。这些模型在语音质量、自然度和适应性方面取得了显著进展,进一步推动了维吾尔语语音技术的研究和应用。此外,该数据集还激发了更多关于低资源语言语音合成的研究,促进了该领域的多元化发展。
以上内容由遇见数据集搜集并总结生成


