PhageBench
收藏资源简介:
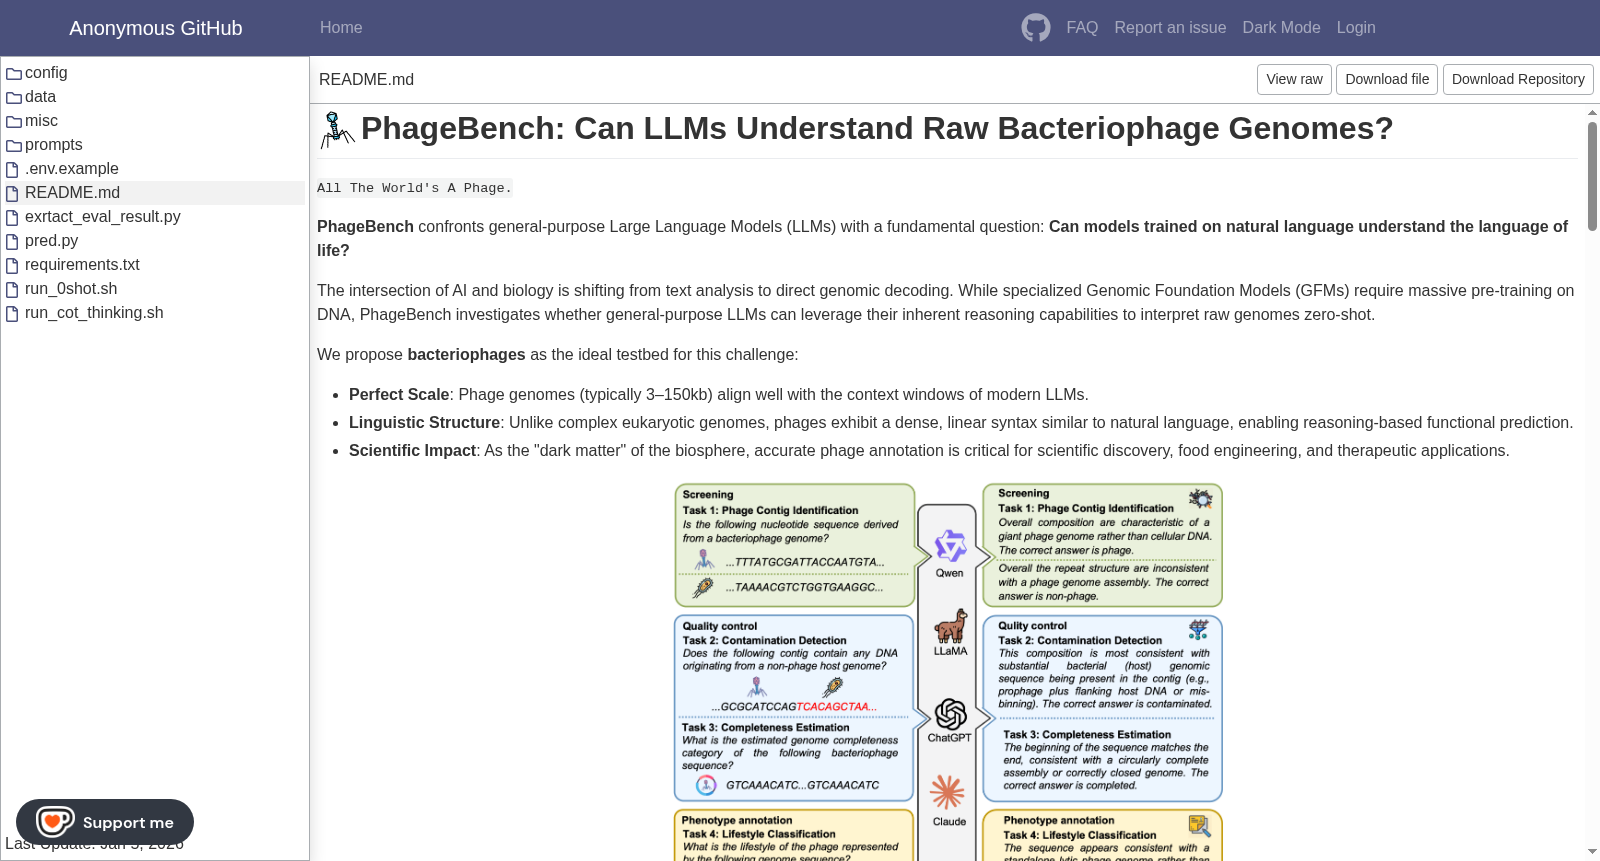
PhageBench是由香港科技大学·广州团队构建的首个专注于噬菌体基因组理解的基准数据集,涵盖筛选、质量控制和表型注释三大阶段的5项核心任务。该数据集包含5600条高质量样本,序列长度分布在0.5-50千碱基对之间,数据源自权威基因组数据库并经过严格过滤。通过模拟生物信息学专家工作流程,数据集采用标准化多选题格式构建,重点解决噬菌体基因组原始序列的识别、污染检测、完整性评估及宿主预测等关键问题,为评估通用大语言模型在非自然语言领域的推理能力提供了创新平台。
PhageBench is the first benchmark dataset dedicated to bacteriophage genome understanding, constructed by the Guangzhou Team of the Hong Kong University of Science and Technology. It covers five core tasks across three major stages: screening, quality control, and phenotype annotation. This dataset contains 5,600 high-quality samples, with sequence lengths ranging from 0.5 to 50 kilobase pairs (kbp). The data is sourced from authoritative genomic databases and has undergone rigorous filtering. Built by simulating the workflow of bioinformatics experts, the dataset is formatted as standardized multiple-choice questions, focusing on key issues including recognition of raw bacteriophage genome sequences, contamination detection, integrity assessment, and host prediction. It provides an innovative platform for evaluating the reasoning capabilities of general large language models (LLMs) in non-natural language domains.
PhageBench 数据集概述
数据集基本信息
- 数据集名称:PhageBench
- 核心研究问题:探究通用大语言模型(LLMs)能否理解原始噬菌体基因组。
- 数据规模:包含 5,600 个高质量样本。
- 最后更新日期:2026年1月5日。
数据集设计理念
- 测试对象:通用大语言模型(LLMs),旨在评估其零样本解释原始基因组的能力。
- 选择噬菌体的原因:
- 规模适中:噬菌体基因组(通常为3–150kb)与现代LLMs的上下文窗口长度匹配良好。
- 结构类似语言:噬菌体基因组展现出密集、线性的句法结构,类似于自然语言,便于进行基于推理的功能预测。
- 科学重要性:噬菌体作为生物圈的“暗物质”,其准确注释对于科学发现、食品工程和治疗应用至关重要。
任务构成
数据集涵盖三个阶段的五个核心任务:
- 筛查阶段
- 任务1:噬菌体重叠群识别(区分噬菌体与细菌、质粒等环境噪音)。
- 质量控制阶段
- 任务2:污染检测(识别宿主信号)。
- 任务3:完整性评估(评估基因组完整性)。
- 表型注释阶段
- 任务4:生活方式分类(裂解性 vs. 温和性)。
- 任务5:宿主预测(识别宿主范围)。
数据特征
- 序列长度:范围从0.5kb到50kb,确保评估的真实性。
- 数据格式:所有数据均标准化为JSON格式,包含样本ID、任务类型、问题、原始DNA序列、选项、正确答案及元数据。
- 数据来源:数据源自权威数据库(如RefSeq, PhageScope),具有高置信度。
评估方法
- 评估设置:通过标准化的多项选择题挑战LLMs,确保可靠解析和评估。
- 关键步骤:
- 安装环境并加载数据(数据位于
data文件夹,包含task1.json至task5.json)。 - 运行模型推理(使用
pred.py脚本,可指定模型和任务,支持零样本和思维链设置)。 - 导出结果(使用
extract_eval_result.py汇总结果)。
- 安装环境并加载数据(数据位于
- 模型要求:需确保模型的上下文长度足以处理数据集中最长的DNA序列(50kb)。
基准测试结果
- 结果呈现:展示了多个模型在零样本思维链设置下,在五个任务上的准确率(%)及平均表现。
- 表现突出模型:
- Gemini-3-flash 在任务1、2、4、5及平均准确率上取得最佳性能。
- GPT-5.2 在任务3上取得最佳性能,并在任务1、2及平均准确率上表现次优。
- 基线:随机猜测的准确率作为基线参考。
项目结构
项目主要目录与文件如下:
config/:模型路径与最大长度配置文件。data/:五个任务的JSON数据文件。misc/:相关图片文件。prompts/:零样本及思维链提示词文件。- 核心脚本:包括环境配置示例、预测脚本、结果提取脚本及运行脚本。