
遇见数据集

Y-J-Ju/RegOps-Bench

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

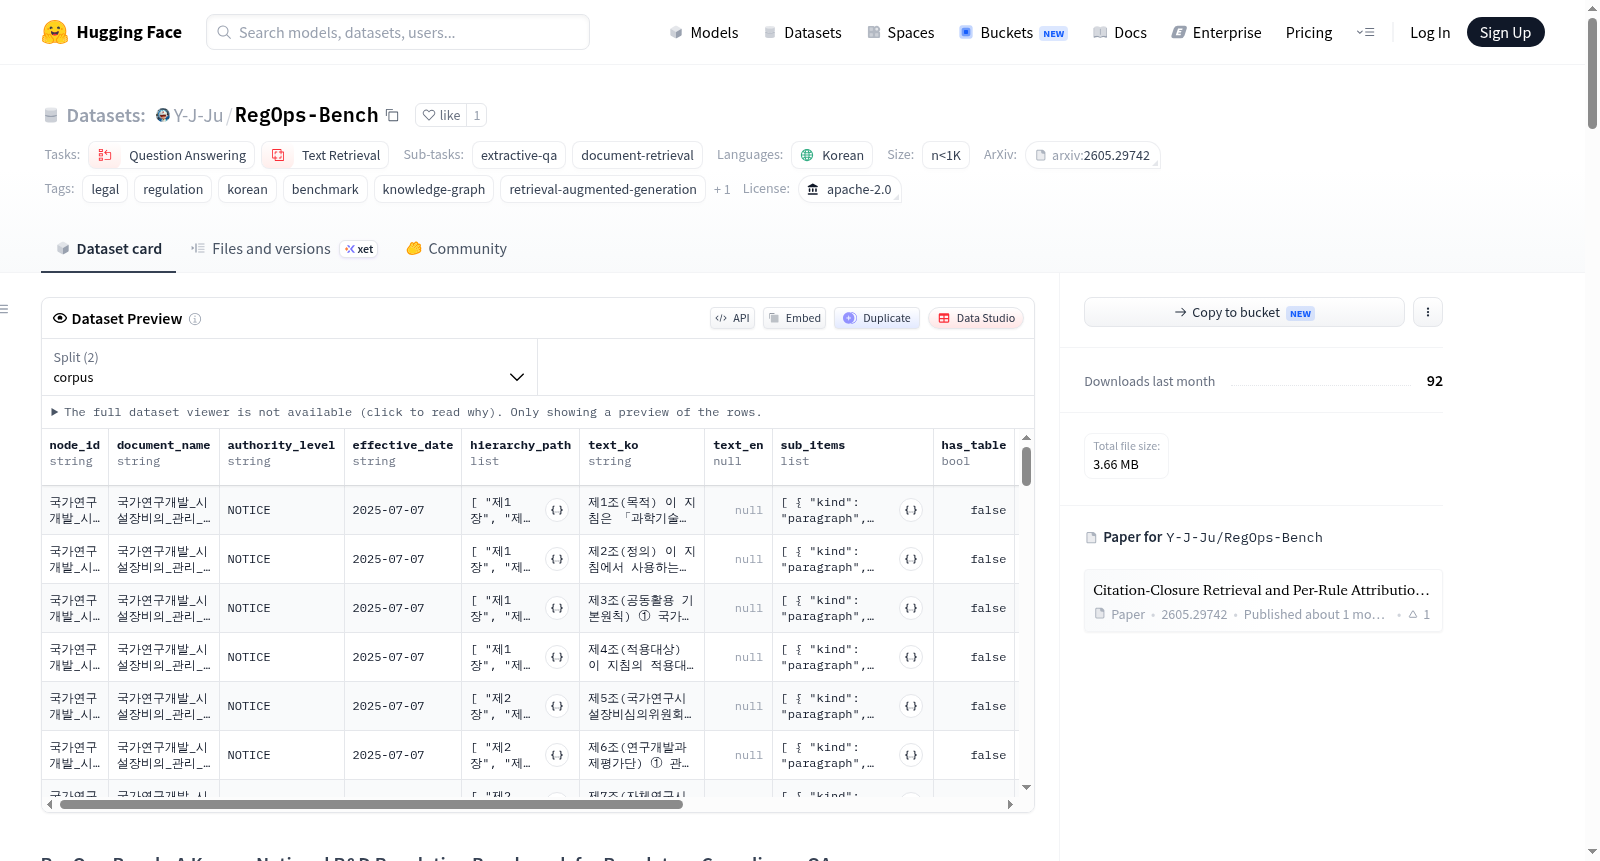
RegOps-Bench是一个用于评估检索增强系统的韩国国家研发法规合规性问答基准。该数据集专注于韩国国家研发法规,包括《국가연구개발혁신법》(国家研发创新法)及相关法令、规则、通知和操作手册。数据集包含两个部分:corpus(语料库)包含718篇法规文章,作为问答系统的检索来源;test(测试集)包含250个问答对,每个问题都针对研究人员或管理员在韩国进行政府资助研究时面临的特定程序决策(如人员成本计算、设备采购、差旅费报销、间接成本规则等)。与传统的多跳或法律问答不同,每个问题都需要在多层权威结构(法规→法令→规则→通知→手册)中进行结构化程序查找和证据集闭合,并附有条款级别的真实引用。数据集还标注了难度级别(L1:单条款事实查找;L2:单文档内多面推理;L3:跨文档引用遍历;L4:条件/例外配对推理与程序链)、问题类型(如多面、单条款、一般原则等)和机构特定子集(如大学、政府出资机构等)。数据来源于韩国国家法律信息中心(국가법령정보센터)和IITP的FAQ文档,语言为韩语,部分内容提供英文翻译。

RegOps-Bench is a Regulatory Compliance QA benchmark for evaluating retrieval-augmented systems on Korean national R&D regulations (국가연구개발혁신법 and related decrees, rules, notices, and operational manuals). The dataset consists of two parts: a corpus split with 718 regulatory articles for retrieval, and a test split with 250 QA pairs. Each question targets a specific procedural decision a researcher or administrator would face when conducting government-funded research in Korea — e.g., personnel cost calculation, equipment procurement, travel expense reimbursement, indirect-cost rules. Unlike conventional multi-hop or legal QA, every question requires structured procedural lookups and evidence-set closure across a multi-tiered authority structure (statute → decree → rule → notice → manual), with ground-truth citations attached at the article and clause level. The dataset includes difficulty levels (L1: single-clause factual lookup; L2: multi-facet reasoning within a single document; L3: cross-document reference traversal; L4: conditional/exception-paired reasoning with procedural chains), question types (e.g., multi_facet, single_clause, general_principle), and an institution-specific subset (e.g., university, government-funded). Data is sourced from the Korean National Law Information Center and IITP FAQ documents, primarily in Korean with some English translations.
提供机构:
Y-J-Ju
搜集汇总
数据集介绍
Y-J-Ju/RegOps-Bench 数据集图片
构建方式
RegOps-Bench的构建基于韩国国家研发法规的多层级权威体系,涵盖法律、施行令、规则、告示及操作手册等12份规范性文件。研究团队首先从韩国国家法令信息中心采集718篇条款文本,构建精细的语料库。随后,针对研究人员或行政人员在政府资助研究过程中面临的实际程序性决策场景(如人员经费计算、设备采购等),设计了250个问答对。每个问答均标注了目标难度等级(L1至L4),并关联至特定条款节点,形成结构化的引用闭包。数据集的构建融合了知识图谱与人工验证,确保了问题的真实性与引用链的完整性。
特点
该数据集的核心特点在于其独特的引用闭包检索机制与多层级归因要求。与传统的多跳或法律问答不同,每个问题需跨多个权威层级(法律→施行令→规则→告示→手册)进行结构化程序性查询,并实现证据集封闭。数据集引入了四级难度分类(L1单条款事实查找至L4条件推理链),其中57%的问答对具有条件依赖属性,考验系统对前置条件的判断能力。此外,22个问题针对特定机构类型(大学、政府出资机构等)设计,评估系统在不同监管情境下的适应性。
使用方法
使用RegOps-Bench时,可通过Hugging Face的datasets库直接加载'corpus'与'test'两个分割。'corpus'包含718篇法规条款,作为检索源;'test'包含250个带标准答案的问答对。评估流程采用检索增强生成范式:系统首先从语料库中检索相关条款,再基于检索结果生成答案,并与标注的引用节点进行对比。数据集提供了便捷的Python接口,支持快速加载与评测。研究者可参考RefWalk框架作为基线,通过对比检索召回率与引用准确性指标,衡量系统在法规合规问答上的表现。
背景与挑战
背景概述
RegOps-Bench是由研究团队在EMNLP 2026背景下构建的韩国国家研发法规合规性问答基准数据集,旨在评估检索增强系统在多层级权威结构下的法规遵从能力。该数据集以韩国《国家研发创新法》及相关法令、规则、通知和操作手册为核心,涵盖人员成本计算、设备采购、差旅费报销等研究行政场景中的程序性决策问题。与传统的多跳或法律问答不同,本数据集要求模型在法规层级体系(法律→法令→规则→通知→手册)中进行结构化程序性查找与证据集闭合,并精确到条款级别进行引用溯源。这一基准的提出填补了现有系统在复杂法规推理领域的评估空白,为法规合规性问答提供了标准化的测试平台。
当前挑战
RegOps-Bench面临的核心挑战源于法规问答任务的独特复杂性。首先,领域问题在于现有检索增强生成系统在扁平化引用边、碎片化检索扩展及脆弱的事后归因下难以应对跨文档引用遍历与程序性链式推理需求,尤其是面对条件性条款(如时间、资格、数量或审批类前置条件)时表现欠佳。其次,数据集构建过程中,需将12份来源文档(含法律、法令、规则、通知、手册)按层级结构组织为718条条款语料,并人工设计250个涵盖L1至L4难度的问答对,确保每个问题具有可验证的条款级引用以及跨文档关联性,这一过程对语料规范化、难度划分和答案验证提出了严苛要求。
常用场景
经典使用场景
RegOps-Bench作为针对韩国国家研发法规的合规性问答基准,其最经典的使用场景是评估检索增强生成(RAG)系统在复杂多层次法规结构下的检索与推理能力。该数据集精心设计了L1至L4四个难度层级,从单条款事实查找到跨文档引用遍历与条件性程序推理,模拟研究人员或行政人员在政府资助研究项目中面临的具体程序决策,如人员成本计算、设备采购、差旅费报销及间接费用规则等。每一个问题均要求系统在法令、施行令、规则、告示及手册构成的五级权威体系中完成结构化程序查找与证据集闭合,并附加条款级别的真实引用。这一场景不仅测试了系统对韩国国家研发创新法及其配套法规的精准理解,更揭示了传统RAG系统在扁平化引用边、碎片化检索扩展及脆弱的事后归因等方面的根本性瓶颈。
实际应用
在实际应用层面,RegOps-Bench直接服务于韩国政府资助研发项目的合规性管理自动化。数据集涵盖N>70篇法规条文,覆盖6部法令/施行令、4部规则、1部告示及1部手册,其250个问答对映射了研究人员和行政人员在项目执行中的高频程序困境,如间接成本计算规则、研究设施设备管理标准、增值税法适用例外等。借助此基准,政府机构与研发管理平台可部署基于RAG的智能合规助手,自动解析申请人所属机构类型(大学、政府出资研究机构、非营利、营利组织),并依据20%的条件性问题实现动态程序路径推荐。大韩民国法务部及科学技术信息通信部等机构正积极推动此类系统,以降低每年数千亿韩元的研究经费违规风险,提升行政效率。此外,该数据集的开源许可(Apache-2.0)和韩国开放政府许可证确保了广泛的商业与学术使用,已吸引多家法律科技初创公司将其集成至研发管理数字化转型方案中。
衍生相关工作
RegOps-Bench的问世催生了一系列具有影响力的衍生工作。其中最具代表性的是RefWalk框架,该框架以共享主题锚点为核心,跨文档遍历引用关系,通过基于最大值的多视角候选融合与每规则归因机制,显著提升了检索召回率与引用准确性,为合规性QA设立了强基线。研究团队进一步在EMNLP 2026上发表了配套论文,详细阐述了引用闭合检索与每规则归因的理论基础,并与HIPAA数据集进行对比评估,揭示现有系统在扁平结构规则上的饱和现象。此外,该数据集还激发了针对法律领域小样本学习的研究,如基于RegOps-Bench的指令微调实验,以及多语言跨域合规性问答的迁移学习探索。韩国学术界围绕该基准形成了活跃的竞赛生态,包括自动评估管道构建和可解释性维度分析,推动了合规性问答从单一基准向系统化评测体系演进,为后续金融、医疗等领域的类似基准设计提供了方法论参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

