
playwright_with_chunk_google_map_huggingface_379_d4a19c_watchlist
收藏数据链接:
官方服务:
资源简介:
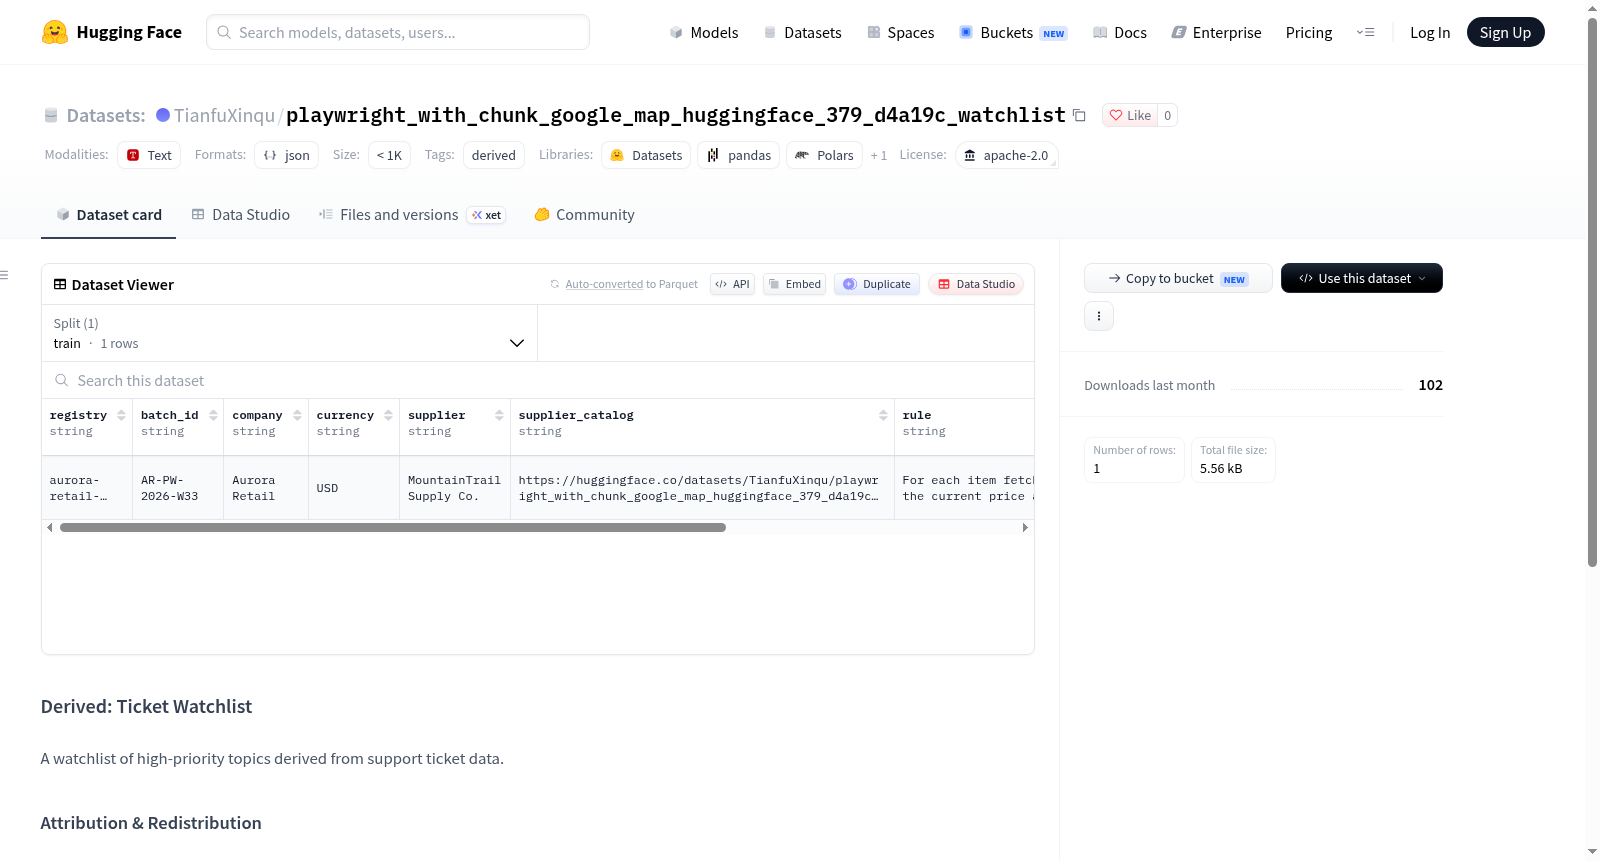
该数据集是一个衍生数据集,名为“Ticket Watchlist”(票据观察列表),由客户支持票据日志(2025年)生成。数据集聚焦于从支持票据数据中提取的高优先级主题,旨在为关注关键问题的用户提供快速参考。数据集遵循Apache-2.0许可证,允许在注明上游来源(TianfuXinqu/github_fetch_huggingface_terminal_9046_nxauzm_upstream_support_tickets)的前提下进行再分发。
This dataset is a derivative dataset named Ticket Watchlist, generated from customer support ticket logs (2025). It focuses on high-priority topics extracted from the support ticket data, aiming to provide quick reference for users concerned with critical issues. The dataset is licensed under Apache-2.0, allowing redistribution with attribution to the upstream source (TianfuXinqu/github_fetch_huggingface_terminal_9046_nxauzm_upstream_support_tickets).
创建时间:
2026-08-14
原始信息汇总
数据集概述:Ticket Watchlist(工单关注列表)
基本信息
- 数据集名称:Ticket Watchlist(工单关注列表)
- 许可证:Apache-2.0
- 数据集标签:derived(衍生数据集)
- 数据来源:由上游支持工单数据衍生而来
数据集内容
本数据集是从客户支持工单数据中衍生出的高优先级主题关注列表,用于跟踪和监控客户支持中需要重点关注的主题领域。
来源与归属
上游数据源
| 项目 | 详情 |
|---|---|
| 上游来源 | 客户支持工单日志(2025年) |
| 来源仓库 | TianfuXinqu/github_fetch_huggingface_terminal_9046_nxauzm_upstream_support_tickets |
| 许可证 | Apache-2.0 |
再分发说明
- 本数据集允许在 Apache-2.0 许可证下进行再分发
- 再分发时必须对上游数据源进行署名归属
搜集汇总
数据集介绍
构建方式
该数据集通过对客户支持工单日志进行系统性筛选与提炼,聚焦高优先级议题的识别与归类。其构建过程依托于上游工单数据源,运用自然语言处理技术对原始工单内容进行语义分析,提取出具有潜在高风险或高关注度的主题,进而形成结构化的观察清单。此方法旨在从海量支持交互中剥离噪声,保留具有决策参考价值的关键信号,为后续风险预警与资源调配提供数据基础。
特点
数据集以高优先级主题清单为核心形态,具备明确的衍生属性与来源可追溯性。其内容源自真实客户支持场景,涵盖工单中涌现的紧迫议题,呈现出主题粒度适中、语义聚合度高的特点。数据规模与结构适配于监控类任务,便于快速识别异常波动或重复出现的痛点。同时,该数据集采用Apache-2.0许可,允许在保留上游署名前提下进行再分发与二次开发,兼顾开放性与合规性。
使用方法
使用者可将该数据集作为监控与预警系统的输入层,结合时间序列分析或主题演化追踪,实时捕捉支持工单中的高优先级信号。在具体操作中,可将其与上游工单数据联动,通过比对观察清单与新增工单的语义相似度,触发告警或分流机制。该数据集亦适用于评估客服响应策略的有效性,或作为训练分类模型的弱监督标签源。再分发时需遵循Apache-2.0条款,明确标注上游来源及本数据集的衍生关系。
背景与挑战
背景概述
在客户支持服务领域,高效识别与优先处理高优先级议题始终是提升响应效率与用户满意度的核心命题。随着自然语言处理与数据驱动决策的深度融合,基于真实工单日志构建结构化衍生数据集成为优化服务流程的关键路径。playwright_with_chunk_google_map_huggingface_379_d4a19c_watchlist数据集于2025年由相关研究团队基于TianfuXinqu/github_fetch_huggingface_terminal_9046_nxauzm_upstream_support_tickets上游工单日志衍生构建,旨在提炼高优先级主题形成可复用的监控清单。该数据集以Apache-2.0协议开放共享,为支持票务系统的智能监控与优先级调度提供了标准化参考,对推动客户服务领域的自动化决策与资源优化配置具有积极的实践意义。
当前挑战
该数据集所应对的领域问题在于从海量非结构化支持工单中准确辨识高优先级议题,其本质是面向服务运营场景的文本分类与主题抽取任务,要求模型兼顾语义理解的细粒度与业务优先级的敏感性。构建过程中面临多重挑战:上游工单数据可能存在标注噪声、主题分布不均衡与语义歧义,影响衍生清单的可靠性;高优先级判定的主观性与业务场景依赖性增加了标签一致性的维持难度;派生数据集需在Apache-2.0许可框架下严格遵循署名与再分发规范,对数据溯源与合规管理提出较高要求;此外,如何在保护用户隐私的同时保留议题的可辨识度,亦是构建环节中亟待平衡的技术难题。
常用场景
经典使用场景
在客户支持与技术服务管理领域,该数据集作为一种主题监视列表,典型应用于从海量支持工单日志中筛选高优先级议题。通过预设关注标签,研究者和工程师能够快速定位频繁出现或紧急程度较高的技术问题,例如系统故障、功能缺失或安全漏洞,进而构建优先级排序模型。其设计思路契合文本挖掘中的主题追踪任务,为后续的自动分类、趋势监测及异常预警提供了结构化的聚焦样本,尤其适用于需要动态跟踪客户反馈热点演变的场景。
实际应用
在实际业务场景中,该数据集可嵌入企业客户支持系统,用于自动生成动态监视面板,辅助运维团队优先处理高频或高危问题。例如,通过对工单中提及的“登录失败”、“支付超时”等主题进行持续跟踪,可提前预警潜在的系统性风险,优化资源调度。同时,该数据集亦可用于训练工单路由模型,将新提交的工单自动分配给相应领域的专家,从而缩短响应时间。其衍生自真实日志的特性使其在客服机器人、知识库构建以及服务质量评估等环节均具有直接的落地价值。
衍生相关工作
该数据集衍生了若干经典工作,包括基于主题模型的工单优先级排序框架、融合注意力机制的文本分类网络以及面向客户支持领域的预训练语言模型微调方法。部分研究利用该监视列表构建了多任务学习基准,同时进行情感分析与紧急度预测;亦有工作将其作为外部知识注入检索增强生成系统,以提升客服问答的准确性。这些衍生工作不仅验证了数据集在跨任务泛化上的潜力,还促进了开源社区对客户支持文本分析工具链的标准化与迭代。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


