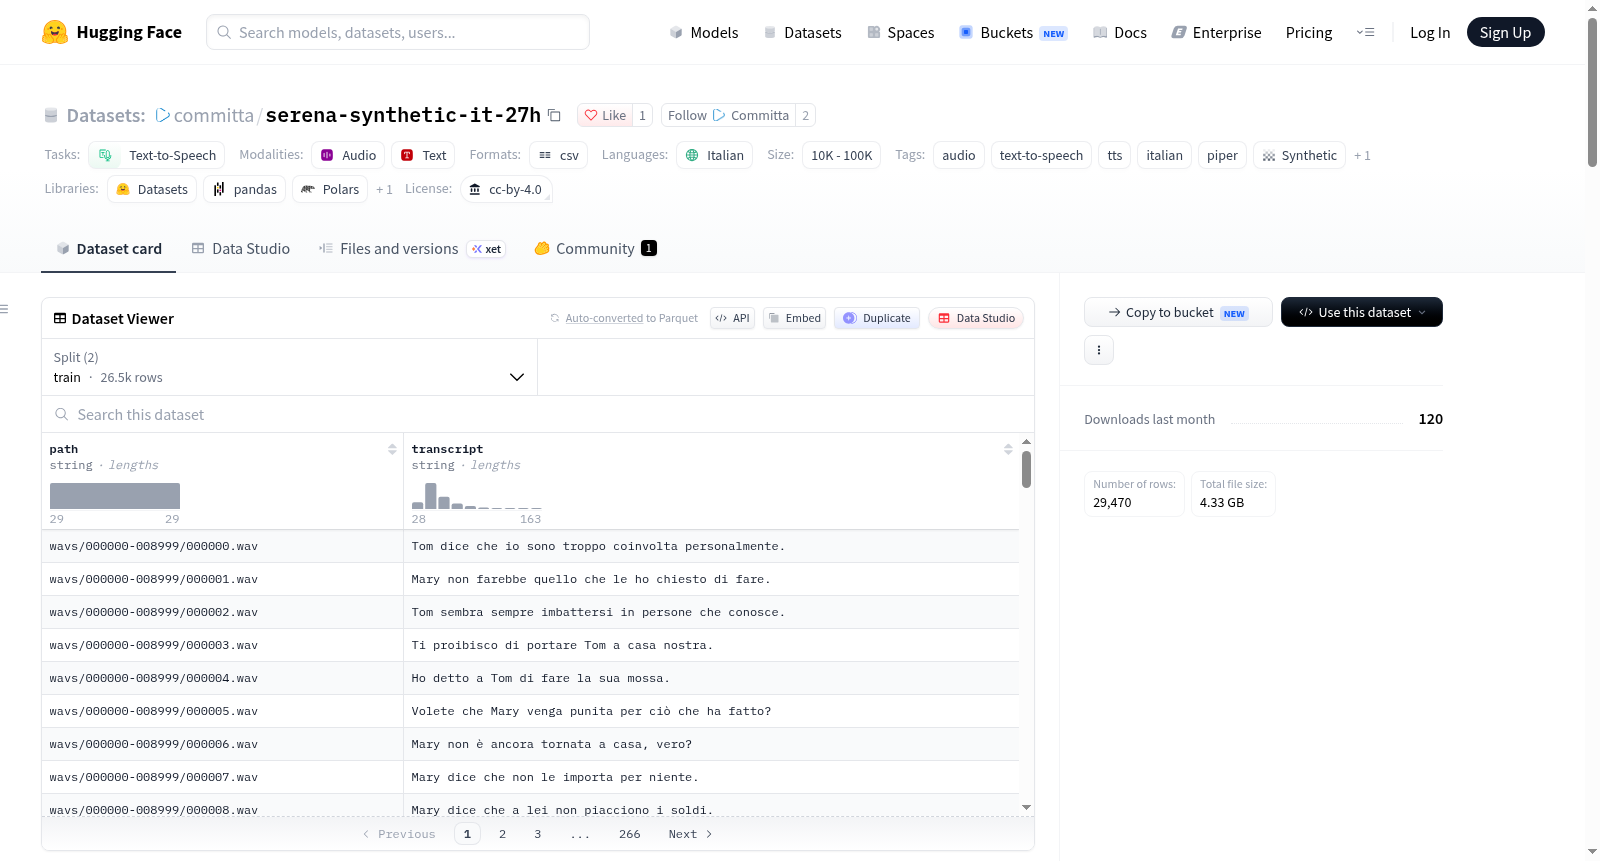
serena-synthetic-it-27h
收藏资源简介:
这是一个用于文本转语音(TTS)训练的意大利语合成语音数据集,名为“serena-synthetic-it-27h”。数据集由Qwen3-TTS-1.7B-Base模型通过语音克隆模式生成,包含约29,500个音频片段,总时长约27.3小时(98,099秒)。所有音频均为22.05 kHz单声道16位WAV格式,经过-23 LUFS响度归一化和静音修剪。数据集中只有一个固定的合成说话人声音,以保持跨片段一致性。元数据采用Piper兼容的格式,路径和文本以竖线分隔。训练集包含26,523个片段,验证集包含2,947个片段。语料库由两部分组成:约90%来自Tatoeba意大利语句子(经改编,包括替换英文名为意大利名、编辑更正和重音修复),约10%由多个LLM(Claude Sonnet、GPT-4o、Qwen、Gemini、DeepSeek)原创生成,涵盖对话、技术和文学风格。每个片段都经过两阶段自动验证:ASR词错误率≤0.25,音素错误率≤0.30,最终平均音素错误率为0.168。数据集文件结构包括README、LICENSE(CC-BY-4.0)、report.json、两个元数据CSV文件及按子目录组织的WAV文件。该数据集可直接用于Piper TTS训练,也可通过Python/datasets库加载。所有音频均为合成生成,不涉及真实人物声音,适用于TTS模型训练和研究。
A synthetic Italian speech dataset for text-to-speech (TTS) training, named serena-synthetic-it-27h. The dataset was generated by the Qwen3-TTS-1.7B-Base model in voice cloning mode, containing approximately 29,500 audio clips totaling about 27.3 hours (98,099 seconds). All audio is in 22.05 kHz mono 16-bit WAV format, normalized to -23 LUFS loudness and trimmed for silence. The dataset features a single fixed synthetic speaker voice for consistency across clips. Metadata is in Piper-compatible format with pipe-separated paths and text. The training set has 26,523 clips, and the validation set has 2,947 clips. The corpus consists of about 90% from Tatoeba Italian sentences (adapted with English names replaced by Italian names, editorial corrections, and accent fixes) and about 10% originally generated by multiple LLMs (Claude Sonnet, GPT-4o, Qwen, Gemini, DeepSeek) covering conversational, technical, and literary styles. Each clip underwent two-stage automatic validation: ASR word error rate ≤ 0.25 and phoneme error rate ≤ 0.30, with a final average phoneme error rate of 0.168. The dataset file structure includes README, LICENSE (CC-BY-4.0), report.json, two metadata CSV files, and WAV files organized in subdirectories. The dataset can be used directly for Piper TTS training or loaded via the Python/datasets library. All audio is synthetically generated, involving no real human voices, suitable for TTS model training and research.
数据集概述:serena-synthetic-it-27h
这是一个用于文本转语音(TTS)训练的人工合成意大利语单说话人语音数据集,采用 CC-BY-4.0 许可协议发布。数据集由 Qwen3-TTS-1.7B-Base 模型通过声音克隆模式生成,格式为 Piper 兼容,适合直接用于 Piper 等 TTS 模型的训练。
基本信息
| 属性 | 值 |
|---|---|
| 音频片段数 | 训练集 26,523 条 / 验证集 2,947 条,共约 29.5k 条 |
| 总时长 | 约 27.3 小时(98,099 秒) |
| 采样率 | 22,050 Hz 单声道,16-bit WAV |
| 响度 | 归一化至 -23 LUFS,已做静音修剪 |
| 语言 | 意大利语 |
| 说话人 | 1 个(单一固定合成参考音色,保证跨片段一致性) |
| 元数据格式 | `wavs/000000-008999/NNNNNN.wav |
生成方式与来源
- 生成工具:使用 qwen3-tts-dataset-generator 端到端流水线(生成→验证→发音检查→归一化→发布)。
- 生成模型:Qwen3-TTS-1.7B-Base(
Qwen/Qwen3-TTS-12Hz-1.7b-Base),bfloat16 精度,通过 ICL(上下文学习)从固定参考片段进行声音克隆,禁用了 x-vector-only。 - 指令:"Read in a calm, neutral tone."
- 采样参数:
temperature=0.4,top_k=50,top_p=1.0,repetition_penalty=1.05,max_new_tokens=512,seed=42,do_sample=true。
语料构成与来源标注
句子语料共 29,475 句,由两部分混合而成:
- 约 90% 改编自 Tatoeba 句子(意大利语,CC-BY 2.0 FR,源自官方导出文件),进行了改编处理:将英语/美国常见人名替换为意大利语人名,并进行了编辑性修正和重音修复。属于衍生/改编作品,并非逐字复制。
- 约 10% 为 LLM 原创句子,涵盖会话、技术和文学等语域,专门为语料库撰写(使用的模型:Claude Sonnet、GPT-4o、Qwen、Gemini、DeepSeek;有一个生产批次在质量审查后被排除)。
语料库使用确定性 seed=42 洗牌组装;人名替换和 LLM 批次验证报告包含在 qwen3-tts-dataset-generator 项目中。
质量控制与验证
每个音频片段均通过两阶段自动化验证:
- 单词级:ASR(faster-whisper
large-v3)词错误率必须 ≤ 0.25。 - 音素级:使用 espeak-ng 音素识别(
facebook/wav2vec2-xlsr-53-espeak-cv-ft)与音素化参考文本进行比对,音素错误率(PER)必须 ≤ 0.30。
最终语料库的音素 PER 分布统计(n = 29,475):
| 统计量 | PER |
|---|---|
| 平均值 | 0.168 |
| 中位数 | 0.167 |
| p75 | 0.208 |
| p90 | 0.247 |
文件结构
README.md LICENSE CC-BY-4.0(见上方来源标注部分) report.json 生成/报告元数据(模型、采样、统计) metadata_train.csv | path|transcript(26,523 行) metadata_val.csv | path|transcript(2,947 行) wavs/000000-008999/ | 8,996 个片段 wavs/009000-017999/ | 9,000 个片段 wavs/018000-026999/ | 8,999 个片段 wavs/027000-029474/ | 2,475 个片段
音频文件分布在最多 9,000 个文件的子目录中,以满足 Hugging Face Hub 对单目录提交文件数不超过 10,000 的限制。
metadata_*.csv 中的路径相对于仓库根目录,因此该文件夹可直接作为 Piper 数据集目录使用。
使用方法
- Piper 训练:元数据格式为 Piper 原生格式(
wavs/NNNNNN.wav|transcript)。训练时将拆分文件合并为单个metadata.csv,并将仓库根目录作为--dataset-dir传入。详见 Piper 文档。 - Python / datasets 库加载:布局为纯文件而非
AudioFolder,需手动加载,示例代码如下:
python import pandas as pd from datasets import Dataset, Audio
df = pd.read_csv("hf://datasets/committa/serena-synthetic-it-27h/metadata_train.csv", sep="|", names=["audio", "text"]) ds = Dataset.from_pandas(df).cast_column("audio", Audio(sampling_rate=22050))
音频样本
- 样本 1:
https://huggingface.co/datasets/committa/serena-synthetic-it-27h/resolve/main/wavs/000000-008999/000000.wav - 样本 2:
https://huggingface.co/datasets/committa/serena-synthetic-it-27h/resolve/main/wavs/009000-017999/012345.wav - 样本 3:
https://huggingface.co/datasets/committa/serena-synthetic-it-27h/resolve/main/wavs/018000-026999/021234.wav
伦理考虑
所有音频均为合成内容:由文本转语音模型输出,不复制任何真实人物的声音。不存在同意问题,但需注意录音可能被用于构建声音克隆工具,应妥善对待该数据集。
许可证
数据集以 CC-BY-4.0 发布(见 LICENSE 文件)。来源标注:
- 音频:由流水线生成,版权归数据集作者所有。
- 约 90% 的文本:改编自 Tatoeba 句子(CC-BY 2.0 FR,https://tatoeba.org),经过修改(人名替换、修正、重音)。
- 约 10% 的文本:LLM 原创句子,版权归数据集作者所有。