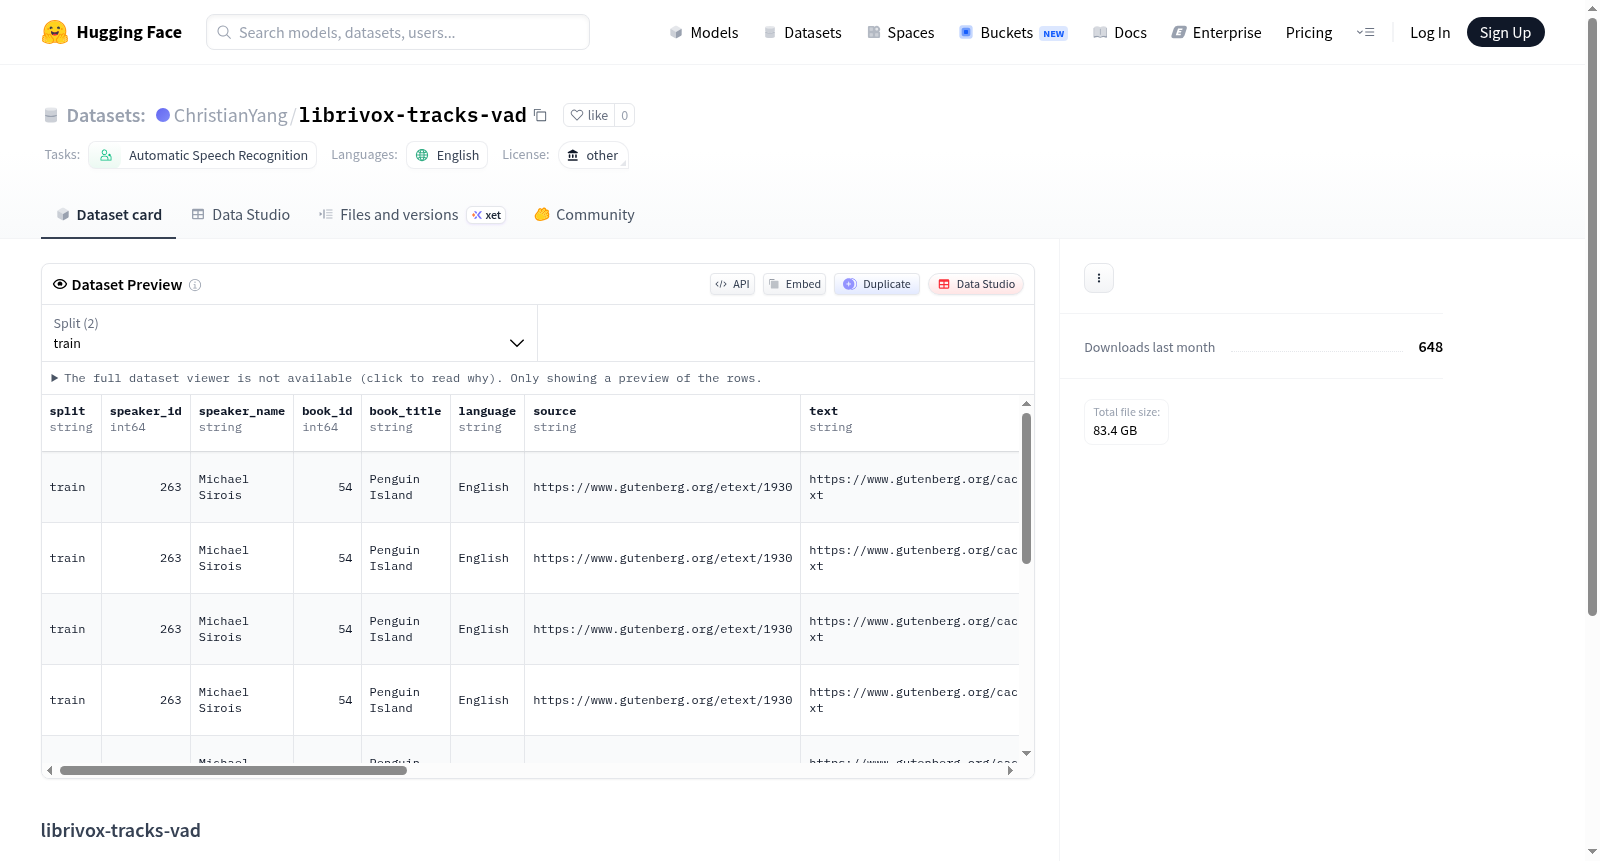
librivox-tracks-vad
收藏资源简介:
librivox-tracks-vad数据集是从`pykeio/librivox-tracks`经过单朗读者过滤和Silero VAD分割处理生成的。该数据集适用于自动语音识别任务,语言为英语。数据以Parquet格式存储,包含训练集的所有话语(`split`始终为`train`),每条记录包含源元数据、单声道WAV音频数据(`audio_bytes`)和采样率(`sampling_rate`)。数据收集遵循一个全局总音频时长预算(具体参见运行清单或脚本参数,默认为`(2442/5994)*3600 * multiplier`秒)。
The librivox-tracks-vad dataset is generated from `pykeio/librivox-tracks` after single-reader filtering and Silero VAD segmentation. This dataset is suitable for automatic speech recognition tasks and is in English. The data is stored in Parquet format, containing all utterances from the training set (where `split` is always `train`), with each record including source metadata, mono WAV audio data (`audio_bytes`), and sampling rate (`sampling_rate`). Data collection follows a global total audio duration budget (see the run list or script parameters for details, default is `(2442/5994)*3600 * multiplier` seconds).
数据集概述:librivox-tracks-vad
- 数据集名称: librivox-tracks-vad
- 任务类别: 自动语音识别(automatic-speech-recognition)
- 语言: 英语(en)
- 许可证: 其他(other)
数据集来源与处理
本数据集基于 pykeio/librivox-tracks 数据集构建,经过了以下处理步骤:
- 单读者过滤: 仅保留由单一位读者朗读的音频片段。
- VAD 分割: 使用 Silero VAD(语音活动检测)技术对原始音频进行分割。
数据文件
- 数据位置:
data/train-*.parquet - 数据切分: 所有数据均属于
train切分(split始终为train)。 - 采集规则: 数据收集直到达到预设的全局总音频预算为止。默认预算为
(2442/5994)*3600 * multiplier秒。
每条数据包含的字段
每行数据存储以下内容:
- 源元数据: 原始录音的来源信息。
- 单声道 WAV 数据: 以
audio_bytes字段存储的音频二进制数据。 - 采样率: 以
sampling_rate字段表示。