
遇见数据集

introvoyz041/CritPt

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

CritPt(Complex Research using Integrated Thinking – Physics Test,读作critical point)是首个旨在测试大语言模型在未发表的研究级推理任务上的基准,广泛覆盖现代物理研究领域,包括凝聚态物理、量子物理、原子分子与光学物理、天体物理、统计物理、核物理、高能物理、数学物理、流体动力学、非线性动力学和生物物理。该数据集由来自全球30多个领先机构的50多名物理研究人员(包括资深博士生、博士后、教授和研究科学家)精心设计。CritPt的挑战旨在反映适合物理初级博士生的全面研究项目的深度和复杂性。数据集中的所有问题都是新创建的、在发布前未被大语言模型见过、定义明确具有无歧义的约束和定义、可基于公开知识解决(即不需要机密或私人信息),并且需要深度理解前沿物理研究背景和精确的多步推理与执行。该数据集是包含70个挑战的测试集。每个问题都具有抗猜测性和机器可验证的答案,可通过针对高级物理特定输出格式高度定制的自动评分流程进行评估。

CritPt (Complex Research using Integrated Thinking – Physics Test; reads as critical point) is the first benchmark designed to test LLMs on unpublished, research-level reasoning tasks that broadly covers modern physics research areas, including condensed matter, quantum physics, atomic, molecular & optical physics, astrophysics, statistical physics, nuclear physics, high energy physics, mathematical physics, fluid dynamics, nonlinear dynamics and biophysics. It is crafted by a team of 50+ physics researchers from 30+ leading institutions worldwide, including senior Ph.D. students, postdocs, professors and research scientists. CritPt challenges are designed to reflect the depth and complexity of full-scale research projects suitable for junior Ph.D. students in physics. All problems in CritPt are newly created and unseen by LLMs prior to this release, well-posed with unambiguous constraints and definitions, feasible to solve with the publicly available knowledge (i.e., no confidential or private information is needed), and requiring a deep understanding of the frontier physics research context and precise multi-step reasoning and execution. This dataset is the test set of 70 challenges. Every problem admits a guess-resistant and machine-verifiable answer and can be evaluated by an automated grading pipeline heavily customized for advanced physics-specific output formats.
提供机构:
introvoyz041
搜集汇总
数据集介绍
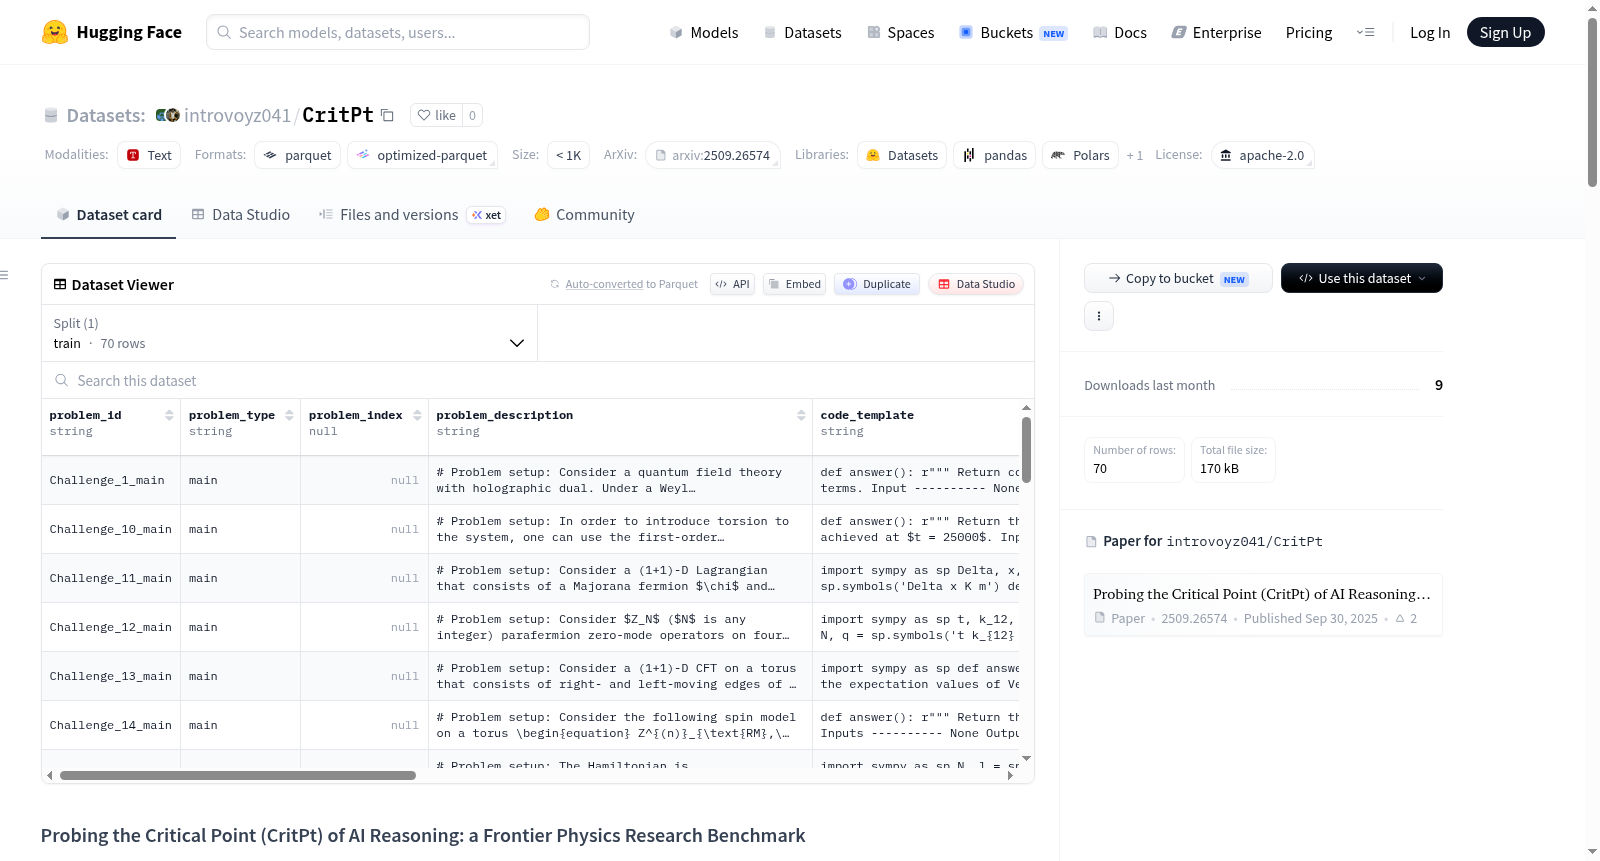
introvoyz041/CritPt 数据集图片
构建方式
CritPt(Complex Research using Integrated Thinking – Physics Test)是由来自全球30余所顶尖机构的50余位物理学研究者(包括资深博士生、博士后、教授及科研人员)共同构建的前沿物理学推理基准。其全部题目均为首次公开发布,由领域专家基于自身前沿研究设计,每道题平均耗费40小时以上的专业精力进行构思与审校,确保其质量与原创性。数据集包含70道测试题,覆盖凝聚态物理、量子信息科学、原子分子与光物理、高能物理等11个现代物理研究方向,并设有防猜测机制与机器可验证的答案,可通过自动化评分管线进行评测。
使用方法
CritPt数据集被严格限定为仅用作测试集,用以评估大语言模型在研究级物理问题上的真实推理能力,严禁用于模型训练或公开解题并散布答案,以维护基准的完整性与社区的集体努力。其自动化评测流程可通过GitHub上提供的专门评估管线(CritPt_Eval)进行,该管线针对物理学科特有的输出格式进行了高度定制。用户可通过运行该管线对自有模型进行评测,其结果将反映模型在70道挑战题上的平均准确率,并参考官方排行榜进行对比分析。
背景与挑战
背景概述
随着大型语言模型(LLM)在数学推理与代码生成等领域取得显著进展,评估其在未经训练的、前沿科学问题上的真实推理能力成为亟需攻克的难题。针对这一需求,由来自全球30余所顶尖机构的50余位物理学研究者(涵盖资深博士生、博士后、教授及科研人员)于2025年共同构建了CritPt(Complex Research using Integrated Thinking – Physics Test)基准。该基准以“临界点”为名,囊括凝聚态物理、量子信息、高能物理、天体物理、统计物理等11个现代物理学研究方向,包含70道全新设计且未公开的研究级推理任务。每个问题平均耗费专家40小时以上的设计与审查精力,并配备了防猜测与机器可验证的自动化评分系统,旨在精准评估LLM对前沿物理语境的理解与多步推理执行能力,为AI在科学领域的应用树立量尺。
当前挑战
CritPt面对的挑战涵盖领域问题的复杂性与基准构建的双重维度。在领域问题层面,传统基准多聚焦于事实检索或简单推理,而CritPt要求模型具备对未发表的、研究级物理问题的深度理解与精确的多步推理能力,这对LLM的符号操作、物理直觉与跨领域知识整合提出了严苛考验——当前最优模型GPT-5(配合代码与网络工具)的准确率仅12.6%,多数旗舰模型更接近随机水平。在构建过程中,团队需设计出定义清晰、边界明确且仅依赖公开知识即可求解的问题,同时确保答案对随机猜测具有鲁棒性;此外,每个问题需兼顾11个学科的覆盖广度与跨领域融合特性(46.5%的问题涉及多个子领域),这对专家协作、问题质量审核与自动化评估管道的定制构成了显著挑战。
常用场景
经典使用场景
CritPt数据集作为首个面向未发表、博士级别研究推理能力的物理学基准,经典使用场景在于系统性评估前沿大语言模型对跨现代物理学分支——包括凝聚态物理、量子信息、原子分子光物理、高能物理、天体物理等11个领域的深度理解与多步推理能力。该基准包含70道由全球50余位物理学专家耗时平均40小时以上精心设计的新创题目,每道题均具备明确的约束条件和可机器验证的答案,旨在通过严苛的自动化评分管线,揭示模型在复杂科研语境下的推理临界点。
解决学术问题
CritPt数据集直击当前大语言模型在高级科学推理评估中面临的“基准污染”与任务同质化困境——传统测试集往往包含已公开题目或局限于浅层知识回忆。该基准通过提供全新、未公开且需跨学科前沿知识整合的物理学研究级问题,首次为学术界建立了一个可信且具有挑战性的推理能力标尺。它系统性地解答了‘当前AI究竟具备多深的科学推理深度’这一核心疑问,其极低的模型准确率(如顶尖模型o3仅1.4%)有力揭示了现有AI在真实研究场景中的显著局限性,从而为AI能力发展进程提供了关键参照。
实际应用
在实际科研与产业应用中,CritPt数据集作为评估与筛选工具,协助前沿科学家精准判断哪些AI模型适合辅助特定物理问题的建模、计算或策略设计,例如在凝聚态理论中探索新材料相变或在量子计算中优化算法实现。同时,它是验证AI辅助发现科学假设、设计实验方案等高级功能的压力测试平台,促使大模型研发团队基于其反馈改进模型在长链条逻辑推理、多领域知识融合与精确数值执行方面的缺陷,推动构建更可靠的科学计算与推理代理人系统。
数据集最近研究
最新研究方向
在人工智能与基础科学交叉的前沿领域,CritPt基准测试的诞生标志着对大型语言模型推理能力的评估迈入了全新阶段。该数据集由全球30余所顶尖机构的50余位物理学家共同打造,覆盖凝聚态物理、量子信息、高能物理等11个现代物理学分支,包含70道精心设计、未公开的研究级挑战题。其核心创新在于要求模型具备跨领域知识整合与多步精密推理的能力,而当前最强模型如GPT-5的最高准确率仅为12.6%,揭示了现有AI在科学推理深度上的显著瓶颈。CritPt不仅为追踪推理型模型的演进提供了黄金标准,更通过自动评分管道确保了评估的客观性与可重复性,正逐步成为衡量AI科学素养的试金石。该工作已在arXiv发布,并引起了学术界对AI能否触及‘临界点’——即进行真正原创性科学推理——的深刻反思。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

