
rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns128_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu
收藏数据链接:
官方服务:
资源简介:
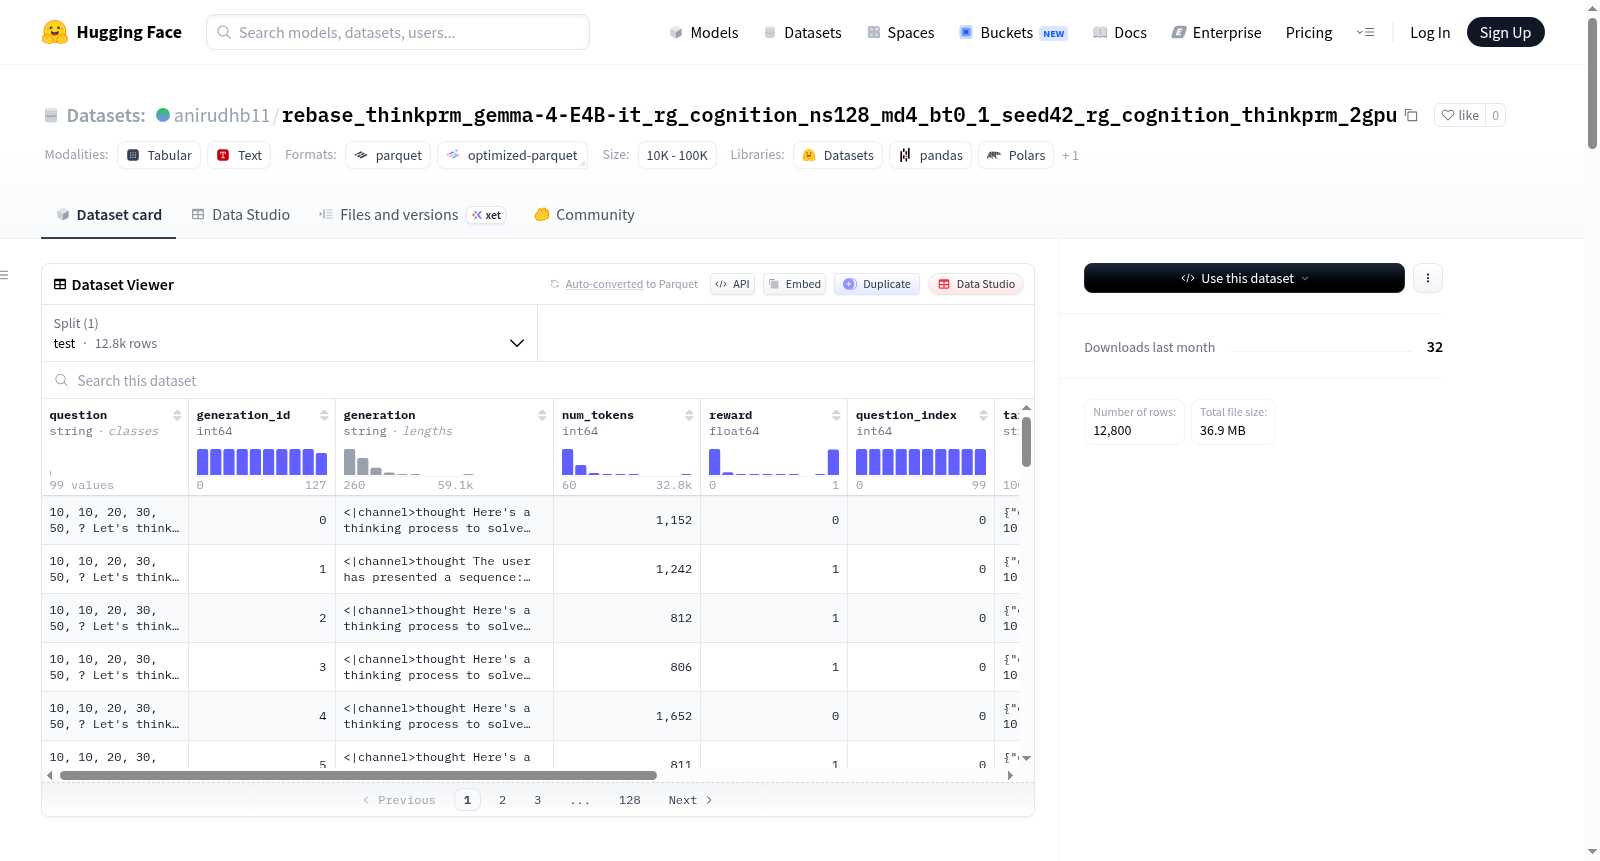
该数据集包含12,800个测试样本,主要用于生成任务和评估模型性能。数据集包含多个特征字段,包括问题(question)、生成ID(generation_id)、生成内容(generation)、令牌数量(num_tokens)、奖励(reward)、问题索引(question_index)、目标(target)、任务(task)、VF预测(vf_prediction)和级别(level)。数据集的下载大小为36,923,712字节,总大小为146,059,641字节。此外,数据集提供了丰富的聚合指标,包括平均响应令牌数、生成阶段时间、通过率(pass@1到pass@128)以及不同级别的策略输出令牌数等,这些指标来自10个分片的加权平均值。
创建时间:
2026-05-05
原始信息汇总
数据集概述
该数据集名为 rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns128_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu,托管于 Hugging Face Datasets 平台。
数据集特征
数据集包含以下字段:
- question: 问题文本(字符串类型)
- generation_id: 生成ID(整数类型)
- generation: 生成的输出(字符串类型)
- num_tokens: 生成的Token数量(整数类型)
- reward: 奖励值(浮点数类型)
- question_index: 问题索引(整数类型)
- target: 目标答案(字符串类型)
- task: 任务名称(字符串类型)
- vf_prediction: 价值函数预测值(浮点数类型)
- level: 层级标签(整数类型)
数据集划分与规模
- 划分: 仅包含测试集(test)
- 测试集样本数: 12,800 条
- 数据集总大小: 146,059,641 字节(约 139.3 MB)
- 下载大小: 36,923,712 字节(约 35.2 MB)
汇总指标
数据集提供了基于10个分片的聚合指标,部分关键指标如下:
- maj@1: 0.470671(多数投票准确率,k=1)
- maj@128: 0.492209(多数投票准确率,k=128)
- pass@1: 0.445703(通过率,k=1)
- pass@128: 0.66(通过率,k=128)
- avg_response_tokens: 2,835.09(平均响应Token数)
- total_time_s: 6,501.44(总耗时,秒)
- total_generated_output_tokens: 20,118,400(总生成输出Token数)
- total_judge_output_tokens: 16,489,400(总评判输出Token数)
- total_policy_output_tokens: 3,629,010(总策略输出Token数)
注意: 所有指标均为按分片行数加权的平均值。
搜集汇总
数据集介绍
构建方式
该数据集名为rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns128_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu,其构建过程融合了强化学习与过程奖励模型的先进理念。数据集通过让Gemma-4-E4B-it模型在推理过程中执行多层级搜索(搜索深度为4,分支数为128)来生成候选解答,并利用ThinkPRM作为过程奖励模型对每个推理步骤进行评分。数据集中包含了每一轮生成的问题、对应的解答文本、奖励值以及价值函数预测值,通过评估生成结果的质量与多样性,最终筛选出高质量样本构建而成。
使用方法
该数据集适用于强化学习与推理模型的训练与评估。用户可将数据加载为HuggingFace Dataset对象,利用其中的question字段作为输入,generation字段作为候选输出,reward与vf_prediction字段作为奖励信号,训练策略模型或价值函数。由于数据已按test划分并包含12,800个样本,可直接用于模型性能的基准测试。此外,任务类型与难度等级字段支持分场景评估,而多层级搜索结构则适合用于分析模型在不同推理深度下的表现差异,为优化搜索策略提供参考。
背景与挑战
背景概述
在大型语言模型(LLM)理性推理与奖励建模的交叉领域,如何通过过程监督(process supervision)提升模型在复杂认知任务中的表现已成为研究焦点。该数据集由研究团队基于Gemma-4-E4B-it模型构建,旨在探索具备推理能力(RG)的ThinkPRM(Thinking Process Reward Model)在组合优化与多步推理中的效果。数据集创建于2024年,依托于对思维链(Chain-of-Thought)与蒙特卡洛树搜索(MCTS)的融合,核心研究问题在于检验通过分层奖励分配(如4级奖励结构)和多候选采样(如128条生成路径)能否显著改善模型在数学推理等任务中的准确性与鲁棒性。该数据集通过maj@k、pass@k和w_best@k等指标系统评估性能,其对改进LLM的理性决策与可信度度量具有潜在推动力。
当前挑战
该数据集主要面临两方面的挑战。领域问题方面,传统基于答案的奖励模型难以捕捉推理过程中的局部正确性,导致模型在需要深度推理的任务中表现不稳定,如平均maj@1仅为0.47,表明仅依靠单一推理路径的准确性不足。构建过程方面,大规模生成与评估伴随着高计算开销,例如单次生成平均需2835个响应token,且总生成时间超过6500秒,同时4级奖励机制引入了复杂的评分时间分配(如第1级评分耗时2167秒)。此外,低共享度(如平均唯一答案数@128仅为17.27)暗示模型在面对多样化推理路径时存在收敛瓶颈,这对数据集的复现与推广构成了阻碍。
常用场景
经典使用场景
在大型语言模型推理能力评估的学术前沿,rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns128_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu数据集为验证模型在复杂认知推理任务中的表现提供了关键基准。其经典使用场景在于通过多轮生成与奖励信号标注,度量模型在数学推理、逻辑演绎等需要深度思考的领域中的准确性。研究者可借助该数据集的多样本生成机制与评分体系,系统性地分析模型从单一尝试到多次采样过程中的正确率变化,从而深入理解推理模型的涌现能力。
解决学术问题
该数据集有效回应了当前学术研究中关于语言模型推理鲁棒性与自我一致性评估的难题。通过提供覆盖不同推理层次的生成样本及对应的精细奖励分数,它使研究者能够量化模型在简单至复杂推理路径上的置信度差异。这一设计显著推动了自回归模型在可解释性分析、错误模式识别以及思维链优化等方向的研究进展,为构建更可靠的推理系统奠定了实证基础,对人工智能基础理论的深化具有重要意义。
实际应用
在实际应用层面,该数据集主要服务于需要高精度逻辑推理的自动化系统,例如智能教育中的数学题解答评估、法律文书中的证据链推断,以及科学文献的知识提取与验证。其奖励分数可直接作为训练信号,用于强化学习或偏好对齐阶段,从而提升AI助手在考试辅导、决策支持等场景下的输出质量。通过多轮推理轨迹的记录,工程师能够调试和优化模型在特定领域中的思考流程,减少事实性错误。
数据集最近研究
最新研究方向
在大型语言模型推理能力强化学习的前沿探索中,rebase_thinkprm_gemma-4-E4B-it_rg_cognition_ns128_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu数据集聚焦于基于过程奖励模型(Process Reward Model, PRM)的思维链(Chain-of-Thought)优化。该数据集通过多轮分层推理与自我反思机制,结合奖励信号对模型输出进行细粒度评估,旨在提升模型在数学推理与复杂认知任务中的表现。其核心创新在于引入“思考层级”概念,通过高低层级搜索策略与多数投票(maj@k)机制,系统性地评估了多种采样策略下的推理正确率与多样性。研究结果表明,在128次采样下,pass@128达到0.66,且maj@64准确率突破0.513,展现了过程监督相较于传统结果监督在降低推理方差、提升模型鲁棒性方面的显著优势。这一数据集为可解释、可回溯的智能推理系统研究提供了关键基准,预示着语言模型具备更深层次的链式思维与自我纠错能力的发展方向。
以上内容由遇见数据集搜集并总结生成


