
遇见数据集

FineWeb-Edu-Ar

收藏
arXiv2024-11-10 更新2024-11-13 收录
官方服务:

资源简介:

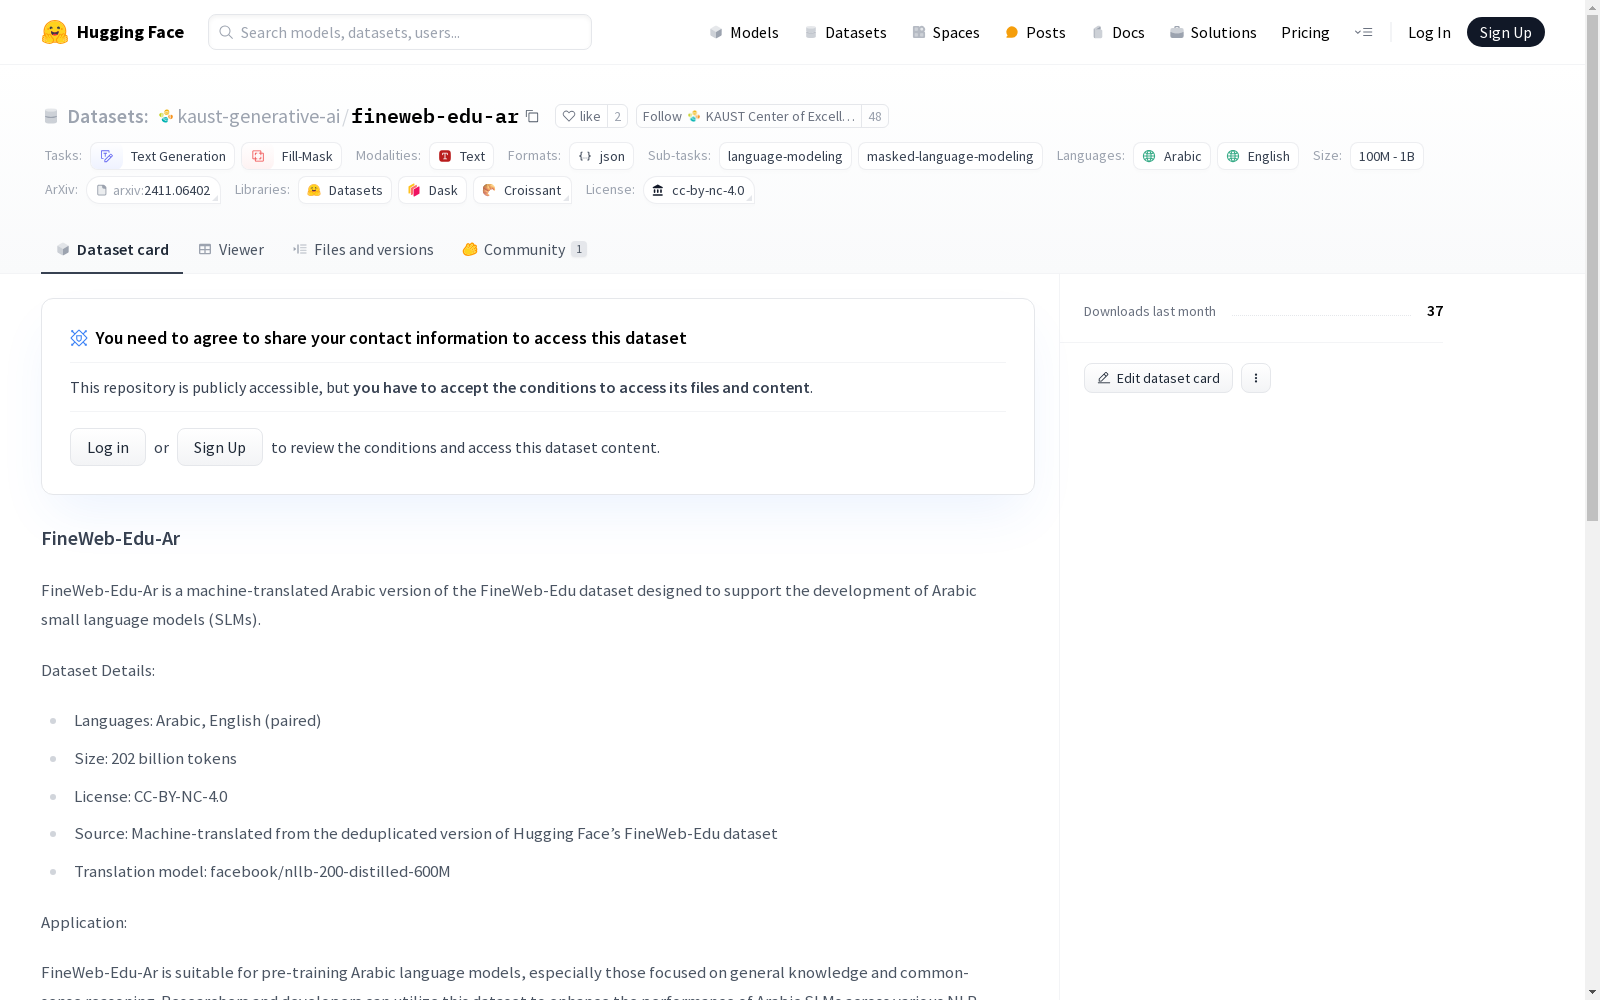
FineWeb-Edu-Ar是由沙特数据与人工智能管理局和阿卜杜拉国王科技大学合作创建的机器翻译数据集,旨在支持阿拉伯语小语言模型的训练。该数据集包含189,405,457条记录,总计202亿个阿拉伯语训练的token,是从HuggingFace的FineWeb-Edu数据集中机器翻译而来。数据集的创建过程包括使用NLLB模型进行翻译,并通过滑动窗口技术处理文本以减少成本和碳排放。FineWeb-Edu-Ar主要用于支持阿拉伯语小语言模型的预训练,旨在解决阿拉伯语高质量教育数据稀缺的问题。

FineWeb-Edu-Ar is a machine translation dataset jointly created by the Saudi Authority for Data and Artificial Intelligence and King Abdullah University of Science and Technology (KAUST), aiming to support the training of small Arabic language models. This dataset contains 189,405,457 records, with a total of 20.2 billion Arabic training tokens, and is machine-translated from HuggingFace's FineWeb-Edu dataset. The dataset development process adopts the NLLB model for translation, and applies a sliding window technique to text processing in order to reduce costs and carbon emissions. FineWeb-Edu-Ar is primarily used to support the pre-training of small Arabic language models, with the goal of addressing the scarcity of high-quality educational data for the Arabic language.
创建时间:
2024-11-10
搜集汇总
数据集介绍
FineWeb-Edu-Ar 数据集图片
构建方式
FineWeb-Edu-Ar数据集的构建基于机器翻译技术,具体是将HuggingFace的FineWeb-Edu数据集从英语翻译成阿拉伯语。这一过程采用了多种流行的英阿翻译模型,包括Facebook的NLLB模型和赫尔辛基大学的OPUS模型。数据集的生成采用了滑动窗口技术,将文本分割为200个token的片段进行翻译,以减少计算成本和碳排放。最终,数据集包含了189,405,457个翻译后的段落,总计202亿个阿拉伯语token。
特点
FineWeb-Edu-Ar数据集的主要特点在于其规模和多样性。作为公开可用的最大阿拉伯语机器翻译数据集,它包含了202亿个阿拉伯语token,为阿拉伯语小语言模型的预训练提供了丰富的资源。此外,数据集的翻译质量经过严格评估,确保了高准确性和流畅性,适合用于各种自然语言处理任务。
使用方法
FineWeb-Edu-Ar数据集适用于阿拉伯语小语言模型的预训练和微调。研究者和开发者可以利用该数据集训练模型,以提高其在阿拉伯语处理任务中的表现。数据集可在HuggingFace平台上获取,同时其生成代码也公开在GitHub上,便于用户进行定制和扩展。此外,数据集的CC-BY-NC-4.0许可证允许非商业用途的使用,促进了学术研究和教育应用的发展。
背景与挑战
背景概述
随着大型语言模型(LLMs)的不断发展和扩展,其对数据的需求也随之增加,特别是在多语言环境中,高质量且易于获取的数据稀缺性尤为突出。为此,Sultan Alrashed、Dmitrii Khizbullin和David R. Pugh等研究人员在沙特数据与人工智能管理局(SDAIA)和阿卜杜拉国王科技大学(KAUST)的支持下,于2024年创建了FineWeb-Edu-Ar数据集。该数据集通过机器翻译技术,将HuggingFace的FineWeb-Edu数据集翻译成阿拉伯语,旨在支持阿拉伯语小型语言模型(SLMs)的预训练。FineWeb-Edu-Ar数据集包含202亿个阿拉伯语训练的token,是目前公开可用的最大阿拉伯语机器翻译数据集之一,对阿拉伯语NLP领域的发展具有重要意义。
当前挑战
FineWeb-Edu-Ar数据集的构建面临多重挑战。首先,阿拉伯语作为低资源语言,其高质量教育相关数据的稀缺性限制了SLMs的发展。其次,机器翻译过程中,如何确保翻译的准确性、语法和语义的完整性是一个复杂的问题。此外,数据集的生成涉及大量的计算资源和碳排放,如何在保证翻译质量的同时,优化资源使用和减少环境影响,是另一个亟待解决的挑战。最后,尽管数据集提供了大量的语言无关知识,但其知识领域主要集中在英语国家,可能缺乏足够的阿拉伯语国家区域性事实,这需要在未来的研究中进一步探讨和完善。
常用场景
经典使用场景
FineWeb-Edu-Ar数据集的经典使用场景主要集中在支持阿拉伯语小语言模型(SLMs)的预训练。通过提供大规模的机器翻译文本,该数据集使得研究人员能够在计算资源有限的情况下,训练出高质量的阿拉伯语语言模型。这些模型在边缘设备上的应用尤为突出,满足了在计算约束环境中对高效语言处理的需求。
解决学术问题
FineWeb-Edu-Ar数据集解决了阿拉伯语小语言模型在预训练阶段面临的高质量数据稀缺问题。通过机器翻译技术,将大量高质量的英语文本转化为阿拉伯语文本,填补了阿拉伯语领域在教育相关数据上的空白。这不仅提升了阿拉伯语语言模型的性能,还为相关研究提供了丰富的数据资源,推动了阿拉伯语自然语言处理领域的发展。
衍生相关工作
FineWeb-Edu-Ar数据集的发布催生了一系列相关研究工作,特别是在阿拉伯语机器翻译和小语言模型训练方面。例如,研究人员基于该数据集开发了多种翻译模型,并对这些模型的性能进行了深入分析。此外,该数据集还启发了其他低资源语言数据集的构建方法,推动了多语言自然语言处理技术的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

