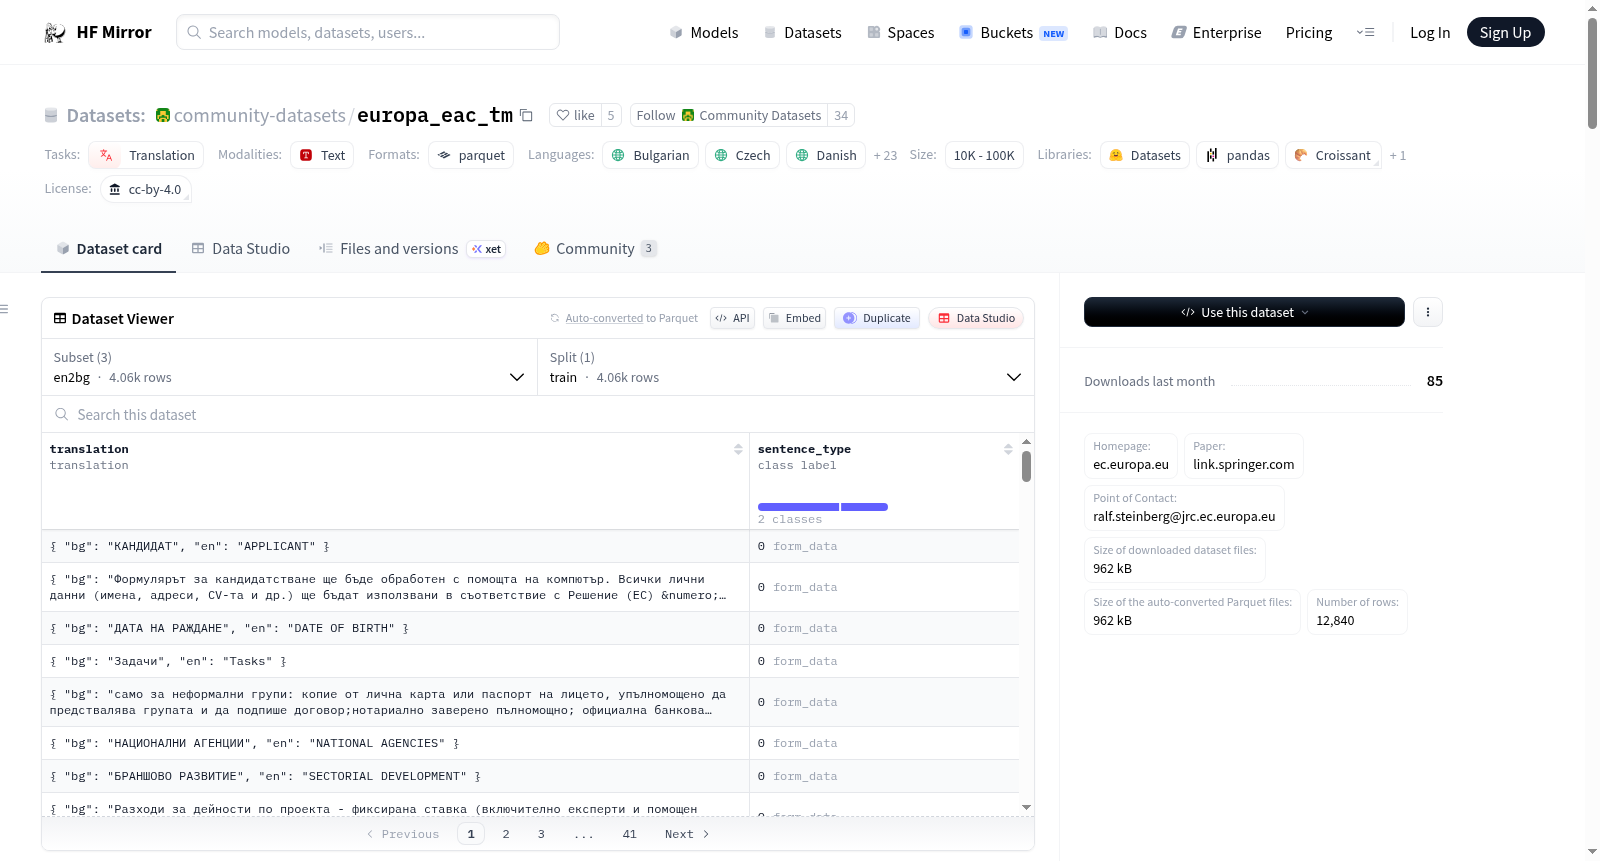
community-datasets/europa_eac_tm
收藏资源简介:
该数据集是一个从英语到多达25种语言的手动翻译语料库,由欧盟的教育和文化总局(EAC)于2012年发布。数据集主要用于机器翻译任务,支持的语言包括保加利亚语、捷克语、丹麦语、荷兰语、爱沙尼亚语、德语、希腊语、芬兰语、法语、克罗地亚语、匈牙利语、冰岛语、意大利语、拉脱维亚语、立陶宛语、马耳他语、挪威语、波兰语、葡萄牙语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语、西班牙语、瑞典语和土耳其语。数据集的句子类型分为两种:表单数据和参考数据。数据集的结构包括翻译句子和句子类型字段,数据仅包含训练集。
This dataset is a corpus of manually produced translations from English to up to 25 languages, released in 2012 by the European Unions Directorate General for Education and Culture (EAC). The dataset is primarily used for machine translation tasks and supports languages including Bulgarian, Czech, Danish, Dutch, Estonian, German, Greek, Finnish, French, Croatian, Hungarian, Icelandic, Italian, Latvian, Lithuanian, Maltese, Norwegian, Polish, Portuguese, Romanian, Slovak, Slovenian, Spanish, Swedish, and Turkish. The datasets sentence types are divided into two categories: form data and reference data. The dataset structure includes translation sentences and sentence type fields, and the data only contains a training set.
数据集卡片:Europa Education and Culture Translation Memory (EAC-TM)
数据集描述
数据集摘要
该数据集是一个由专家手动生成的翻译语料库,包含从英语到多达25种其他语言的翻译。数据集由欧洲联盟的教育和文化总司(EAC)于2012年发布。
支持的任务和排行榜
text2text-generation:该数据集可用于训练机器翻译模型。机器翻译模型通常使用BLEU、ROUGE或SacreBLEU等指标进行评估。可以使用mBART模型进行此任务。该任务有活跃的排行榜,通常根据BLEU分数对模型进行排名。
语言
数据集中的句子最初是用英语编写的,然后翻译成其他语言。句子来自电子表格:EAC的终身学习计划(LLP)和青年行动计划的分散行动的申请和报告表格。电子表格的内容分为两种类型:(a)下拉菜单的标签和内容(称为“表单数据”)和(b)复选框(称为“参考数据”)。
数据集包含从英语翻译成保加利亚语、捷克语、丹麦语、荷兰语、爱沙尼亚语、德语、希腊语、芬兰语、法语、克罗地亚语、匈牙利语、冰岛语、意大利语、拉脱维亚语、立陶宛语、马耳他语、挪威语、波兰语、葡萄牙语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语、西班牙语、瑞典语和土耳其语的句子。
语言代码:
bgcsdadeelenesetfifrhrhuisitltlvmtnlnoplptroskslsvtr
数据集结构
数据实例
json { "translation": { "en": "Sentence to translate", "<target_language>": "Phrase à traduire" }, "sentence_type": 0 }
数据字段
translation:包含待翻译的英语句子和翻译后的句子。sentence_type:整数值,0表示句子是“表单数据”(从源电子表格的下拉菜单的标签和内容中提取),1表示句子是“参考数据”(从电子表格的复选框中提取)。
数据分割
数据仅包含train分割。
数据集创建
数据收集和规范化
EAC-TM是在翻译电子表格的背景下构建的:EAC的终身学习计划(LLP)和青年行动计划的分散行动的申请和报告表格。所有文档和句子最初都是用英语编写的,然后翻译成其他语言。
电子表格的内容分为两种类型:(a)下拉菜单的标签和内容(称为“表单数据”)和(b)复选框(称为“参考数据”)。由于数据类型的不同,这两个集合是分开的。例如,标签可以是“国家”、“请指定您的祖国”等,而参考数据的例子是“德国”、“基础/一般计划”、“教育和文化”等。
数据包含在2008年底至2012年7月之间进行的翻译。
源语言生产者
文本由终身学习计划和青年行动计划的国家机构的员工翻译。他们通常是教育/青年和欧盟计划领域的专业人士。他们不是专业翻译,但通常是目标语言的母语者。
注释
注释过程
句子由人工手动翻译。
注释者
文本由终身学习计划和青年行动计划的国家机构的员工翻译。他们通常是教育/青年和欧盟计划领域的专业人士。他们不是专业翻译,但通常是目标语言的母语者。
数据集配置
配置名称:en2bg
- 特征:
translation:包含英语和保加利亚语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含664244字节和4061个示例。
- 下载大小:332039字节
- 数据集大小:664244字节
配置名称:en2cs
- 特征:
translation:包含英语和捷克语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含365983字节和3351个示例。
- 下载大小:3521416字节
- 数据集大小:365983字节
配置名称:en2da
- 特征:
translation:包含英语和丹麦语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含422079字节和3757个示例。
- 下载大小:3521416字节
- 数据集大小:422079字节
配置名称:en2de
- 特征:
translation:包含英语和德语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含579566字节和4473个示例。
- 下载大小:3521416字节
- 数据集大小:579566字节
配置名称:en2el
- 特征:
translation:包含英语和希腊语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含491346字节和2818个示例。
- 下载大小:3521416字节
- 数据集大小:491346字节
配置名称:en2es
- 特征:
translation:包含英语和西班牙语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含555210字节和4303个示例。
- 下载大小:308680字节
- 数据集大小:555210字节
配置名称:en2et
- 特征:
translation:包含英语和爱沙尼亚语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含247284字节和2270个示例。
- 下载大小:3521416字节
- 数据集大小:247284字节
配置名称:en2fi
- 特征:
translation:包含英语和芬兰语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含150560字节和1458个示例。
- 下载大小:3521416字节
- 数据集大小:150560字节
配置名称:en2fr
- 特征:
translation:包含英语和法语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含575571字节和4476个示例。
- 下载大小:321064字节
- 数据集大小:575571字节
配置名称:en2hu
- 特征:
translation:包含英语和匈牙利语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含454802字节和3455个示例。
- 下载大小:3521416字节
- 数据集大小:454802字节
配置名称:en2is
- 特征:
translation:包含英语和冰岛语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含268194字节和2206个示例。
- 下载大小:3521416字节
- 数据集大小:268194字节
配置名称:en2it
- 特征:
translation:包含英语和意大利语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含270634字节和2170个示例。
- 下载大小:3521416字节
- 数据集大小:270634字节
配置名称:en2lt
- 特征:
translation:包含英语和立陶宛语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含358844字节和3386个示例。
- 下载大小:3521416字节
- 数据集大小:358844字节
配置名称:en2lv
- 特征:
translation:包含英语和拉脱维亚语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含437487字节和3880个示例。
- 下载大小:3521416字节
- 数据集大小:437487字节
配置名称:en2mt
- 特征:
translation:包含英语和马耳他语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含178675字节和1722个示例。
- 下载大小:3521416字节
- 数据集大小:178675字节
配置名称:en2nb
- 特征:
translation:包含英语和挪威语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含85833字节和642个示例。
- 下载大小:3521416字节
- 数据集大小:85833字节
配置名称:en2nl
- 特征:
translation:包含英语和荷兰语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含188531字节和1805个示例。
- 下载大小:3521416字节
- 数据集大小:188531字节
配置名称:en2pl
- 特征:
translation:包含英语和波兰语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含515976字节和4027个示例。
- 下载大小:3521416字节
- 数据集大小:515976字节
配置名称:en2pt
- 特征:
translation:包含英语和葡萄牙语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含422125字节和3501个示例。
- 下载大小:3521416字节
- 数据集大小:422125字节
配置名称:en2ro
- 特征:
translation:包含英语和罗马尼亚语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含345468字节和3159个示例。
- 下载大小:3521416字节
- 数据集大小:345468字节
配置名称:en2sk
- 特征:
translation:包含英语和斯洛伐克语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含306049字节和2972个示例。
- 下载大小:3521416字节
- 数据集大小:306049字节
配置名称:en2sl
- 特征:
translation:包含英语和斯洛文尼亚语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含577524字节和4644个示例。
- 下载大小:3521416字节
- 数据集大小:577524字节
配置名称:en2sv
- 特征:
translation:包含英语和瑞典语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含304954字节和2909个示例。
- 下载大小:3521416字节
- 数据集大小:304954字节
配置名称:en2tr
- 特征:
translation:包含英语和土耳其语的翻译。sentence_type:包含句子类型的分类标签。
- 分割:
train:包含328267字节和3198个示例。
- 下载大小:3521416字节
- 数据集大小:328267字节