life-event-benchmark-v2-dialogues
收藏资源简介:
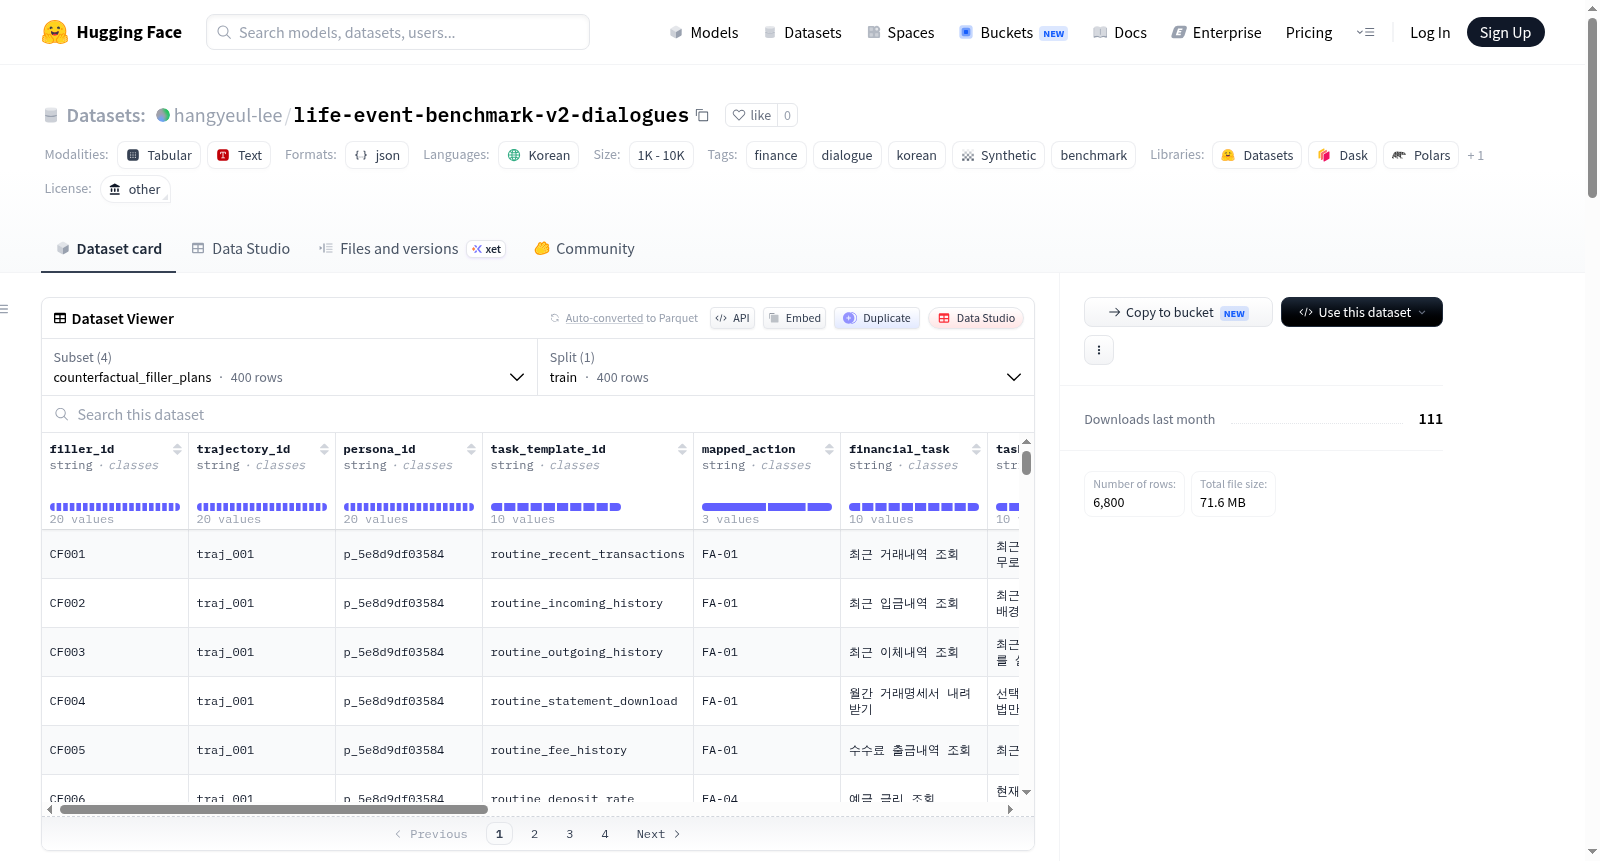
Life-Event Benchmark v4 — Korean Financial Dialogues 是一个用于状态优先金融生活事件记忆基准测试的合成韩语银行对话数据集。该数据集模拟了客户与助理之间的简短对话,每个对话都与一个模拟人物生活轨迹中的特定时间点相关联。数据集包含20个独立的人物/轨迹(persona_id从traj_001到traj_020),每个轨迹有300个规范会话,总计6000个规范会话。此外,还包含400个反事实填充会话(每个轨迹20个),这些会话作为评估控制项,用于信号消融实验,不包含任何生命周期事件或记忆更新。数据由Claude Sonnet 5(Anthropic提供)生成,版本为v4。数据集分为多个配置:dialogues配置包含无答案键的对话数据,字段包括persona_id、session_id、trajectory_id、时间顺序位置、对话轮次(turns)、模型和提供者等;gold配置是基准答案键,包含标签和生成元数据,如会话类型、映射动作、金融任务、事件链接/状态、提示注释、动作解析、计划和生成元数据等;counterfactual_fillers配置包含反事实填充会话,这些会话具有特定属性(如源类型为“synthetic_reserve”、月份索引为空、包含8轮交替对话、使用相同人物风格但无生活状态事实等)。数据集完全合成,不代表真实客户对话,适用于金融对话基准测试、记忆更新任务评估和信号消融实验等场景。
Life-Event Benchmark v4 — Korean Financial Dialogues is a synthetic Korean bank dialogue dataset for state-prioritized financial life event memory benchmarking. It simulates brief dialogues between customers and assistants, with each dialogue associated with specific time points in simulated persona life trajectories. The dataset includes 20 independent personas/trajectories (persona_id from traj_001 to traj_020), each with 300 canonical sessions, totaling 6000 canonical sessions. Additionally, it contains 400 counterfactual filler sessions (20 per trajectory), which serve as evaluation controls for signal ablation experiments and do not include any life cycle events or memory updates. The data is generated by Claude Sonnet 5 (provided by Anthropic), version v4. The dataset is divided into multiple configurations: the dialogues configuration contains dialogue data without answer keys, with fields including persona_id, session_id, trajectory_id, temporal order position, dialogue turns, model, and provider; the gold configuration is the benchmark answer key, containing labels and generation metadata, such as session type, mapped actions, financial tasks, event links/states, prompt annotations, action parsing, plans, and generation metadata; the counterfactual_fillers configuration includes counterfactual filler sessions with specific attributes (e.g., source type as synthetic_reserve, month index empty, containing 8 alternating turns, using the same persona style but without life state facts). The dataset is entirely synthetic and does not represent real customer dialogues, suitable for scenarios like financial dialogue benchmarking, memory update task evaluation, and signal ablation experiments.
数据集概述
Life-Event Benchmark v4 — Korean Financial Dialogues 是一个韩语金融对话数据集,专为“状态优先的金融生活事件记忆基准”设计。每个典型会话是客户与助手的简短对话,关联于模拟人物生活轨迹中的某一点。
基本信息
- 语言:韩语(ko)
- 许可证:其他(other)
- 生成器:
claude-sonnet-5(提供商:Anthropic) - 版本:v4;反事实填充契约:
counterfactual-filler-v1
数据规模与结构
- 人物/轨迹:20个(
traj_001–traj_020,每人一个唯一persona_id) - 典型会话:6,000个(每人300个)
- 反事实填充会话:400个无时间限制的储备对话(每人20个)
- 所有数据按人物拆分为每人物一个文件,分别存放于
dialogues/和gold/目录
配置(Configs)
| 配置名 | 数据路径 | 说明 |
|---|---|---|
dialogues |
dialogues/*.jsonl |
无答案的对话数据,包含persona_id、session_id、trajectory_id、时间位置、turns、model、provider等字段 |
gold |
gold/*.jsonl |
基准答案键,包含session_type、mapped_action、financial_task、事件链接/状态、cue_annotations、action_resolution、plan、generation_metadata等标签和生成元数据 |
counterfactual_fillers |
counterfactual_fillers/v1/sessions/*.jsonl |
反事实填充会话,每个填充会话有source_kind="synthetic_reserve"、month_index=null、恰好8个交替的用户/助手回合、仅包含无链接的常规银行任务、无生活事件或记忆更新 |
counterfactual_filler_plans |
counterfactual_fillers/v1/plans/*.jsonl |
反事实填充计划,用于精确实验重建 |
连接方式:通过(trajectory_id, session_id)将dialogues与gold连接。
反事实填充库 v1
该库用于信号消融实验:固定典型前缀检查点,用中性储备对话替换选定的生活证据回合。结构如下: text counterfactual_fillers/v1/ ├── sessions/fillers_traj_001.jsonl … fillers_traj_020.jsonl ├── plans/plans_traj_001.jsonl … plans_traj_020.jsonl ├── audit/ ├── filler_generation_manifest.json └── artifact_manifest.json
每个填充会话:
- 使用
source_kind="synthetic_reserve"且month_index=null - 恰好包含8个交替的用户/助手回合
- 使用同一人物的对话风格但不含生活状态事实
- 仅包含无链接的、信息性的常规银行任务
- 无生命周期事件或记忆更新
- 由
claude-sonnet-5生成并保留每批次的生成元数据
质量控制
- 典型生成人物通过了仓库的对话QA流程
- 反事实库通过了确定性冻结计划审计:
- 20个人物文件和400/400预期填充会话
- 每人恰好20个填充会话,每个中性任务有两个实现
- 无生命周期/记忆线索、个人查找结果、跨人物捐赠者或契约违规
- 所有451个终端事件可被掩码,且无填充排除
- 审计决策、计数和SHA256哈希见
counterfactual_fillers/v1/audit/和artifact_manifest.json
注意事项
- 完全合成:没有对话代表真实客户
- 反事实填充是评估控制项,而非额外的时间序列会话
- 评估期间不重新运行填充生成;消费者应获取并固定冻结的v1工件
- 填充库控制缺失的证据;需要单独的安慰剂组来隔离任何残留的填充风格效应