
遇见数据集

lamm-mit/silkome-full-idv-grouped

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

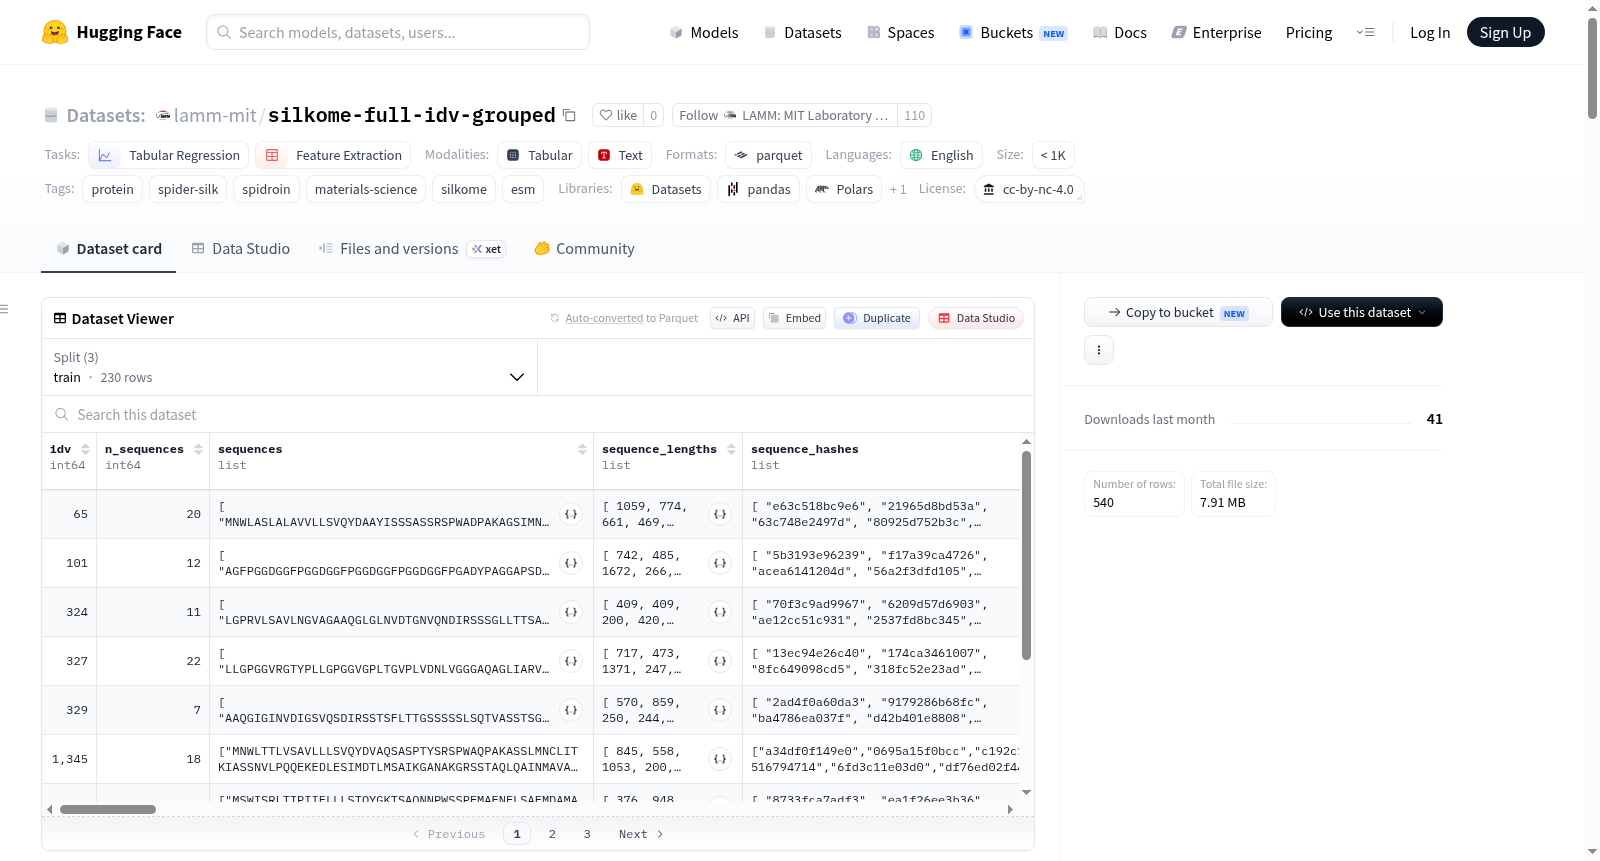
lamm-mit/silkome-full-idv-grouped 是一个按idv分组的全类别蜘蛛丝蛋白质组(Silkome)数据集,用于从所有可用的蜘蛛丝蛋白质序列类别中预测牵引丝纤维级别的机械性能(如韧性、弹性模量、强度和应变),这些序列与相同的测量纤维/性能标识符相关联。该数据集源自lamm-mit/silkome-full,但不是每行放置一个蛋白质序列,而是将具有相同idv的序列行分组为一个样本,形成从序列集到机械性能的映射。这种设计适用于ESMC嵌入模型,后接集合级聚合模型,以分析序列类别组成和序列-性能关系。

lamm-mit/silkome-full-idv-grouped is an idv-grouped all-category Silkome dataset for predicting dragline fiber-level mechanical properties from all available Silkome sequence categories associated with the same measured fiber/property identifier. This dataset is derived from lamm-mit/silkome-full. Instead of placing one protein sequence in each row, this dataset groups sequence rows with the same idv into one sample, mapping all available Silkome sequences for one idv to mechanical properties like toughness, elastic modulus, strength, and strain. This formulation is designed for ESMC embedding models followed by a set-level aggregation model, enabling analysis of sequence category composition and sequence-property relationships.
提供机构:
lamm-mit
搜集汇总
数据集介绍
lamm-mit/silkome-full-idv-grouped 数据集图片
构建方式
本数据集源自于对天然蛛丝蛋白组学(silkome)序列与拖丝纤维力学性能关联的深入研究。在构建过程中,研究者以'idv'(纤维/性能标识符)为分组依据,将来自`lamm-mit/silkome-full`数据集中所有归属于同一标识符的蛛丝蛋白序列聚合至单一样本内,形成从序列集合到纤维韧性、弹性模量、强度与应变的多对一映射。原始3563条序列行经此过程最终整合为270组样本,各组包含的序列数量从1条至31条不等,中位数为11条,平均约13条。
特点
该数据集的核心特色在于其独特的分组结构,有效克服了传统逐序列建模中训练与测试集泄露的问题,确保同一纤维来源的所有序列集在划分时不会跨集出现。数据集提供了丰富的序列元信息,包括每条序列的蛋白类别(如MaSp1、MaSp2、MiSp等)及其长度,并预设了按属性元组键确定的确定性训练/测试划分(230组训练、40组测试)。此外,为兼容不同工作流,数据集还提供了多FASTA格式文本和以25个X残基连接的串联序列作为便捷基准表示。
使用方法
推荐的使用方案是采用ESMC模型对每组内的各条序列独立提取嵌入表示,再结合可学习的蛋白类别嵌入,通过排列不变性聚合模型(如均值池化、注意力池化、DeepSets或集合变换器)整合为统一的集合级特征,最后连接至力学性能预测头。用户可通过HuggingFace的`load_dataset`接口直接加载预设的'train'与'test'分片,并访问'sequences'、'sequence_categories'等核心列。尽管提供了串联序列,但需注意其主要作为兼容性基线,并非首要生物学表示,且过长的串联长度可能超出某些ESMC模型的输入限制。
背景与挑战
背景概述
蜘蛛丝凭借其卓越的力学性能,如高强度和良好韧性,成为仿生材料科学领域的研究热点。其机械性质的背后是一类名为蛛丝蛋白(spidroin)的复杂蛋白家族,不同类别(如MaSp、MiSp等)在序列和功能上的差异深刻影响纤维性能。2022年,由Arakawa等人组成的国际研究团队基于对超过1000种蜘蛛转录组及蛋白质组数据的系统分析,构建了Spider Silkome资源库,旨在揭示蛛丝蛋白序列与其纤维力学性质之间的内在关联。在此基础之上,麻省理工学院的研究团队进一步开发了Silkome Full Idv Grouped数据集,该数据集将来自同一纤维实测样本(idv)的全部蛛丝蛋白序列进行分组,形成以纤维级力学性质为目标的回归预测任务。该数据集通过确定性分组方法划定了训练集与测试集,确保不同分组间无标识符与四维力学性质元组重叠,为评估序列集合到材料性能映射关系的泛化能力提供了严谨的基准。
当前挑战
该数据集所解决的核心领域问题在于,蜘蛛丝纤维的力学性能并非由单一蛋白序列单独决定,而是由多种蛛丝蛋白的序列特征及其相对比例共同调控,这使得传统的单序列预测模型难以有效捕获集合层面的因果信号。构建过程中,原始数据包含超过3500条序列,但有效分组样本仅270个,数据稀疏性与高维度蛋白类别特征(涵盖17种蛛丝蛋白类别)给模型训练带来严峻挑战。此外,不同分组中的序列数量差异悬殊(最少1条,最多31条),且最大拼接序列长度可达17750个残基,远超常见蛋白质语言模型的处理窗口。实验测量结果同时受到纺丝条件、后翻译修饰等非序列因素的影响,进一步加剧了从序列到性能映射中的噪声与混淆,要求模型具备更强的鲁棒性与集合级推理能力。
常用场景
经典使用场景
在蛋白质组学与材料科学交叉领域,Silkome全序列分组数据集为从多类别蛛丝蛋白序列集合预测牵丝纤维级力学性能提供了标准化基准。该数据集巧妙地将具有相同纤维样本标识符的所有可用蛛丝蛋白序列归为一组,形成从序列集合到韧性、杨氏模量、强度与断裂应变四维力学指标的映射关系。其典型使用范式是采用ESMC嵌入模型对每条序列独立编码后,通过置换不变聚合器(如均值池化、注意力池化或DeepSets)整合多重序列语义信息,从而表征复杂丝蛋白组成与纤维力学表现的深层关联。
衍生相关工作
该数据集衍生了一系列蛋白质组学与材料信息学交叉的前沿工作。最具代表性的包括SilkomeGPT框架,该研究利用生成式建模在Silkome数据集上训练条件扩散模型,实现对力学增强型蛛丝蛋白序列的创新设计。后续工作进一步探索了基于集合深度学习架构的纤维性能预测模型,以及采用图神经网络建模序列间相互作用效应的新范式。这些衍生研究共同勾勒出从序列数据到性能预测、再到理性设计的完整技术脉络,显著拓展了生物启发性材料开发的智能方法论边界。
数据集最近研究
最新研究方向
在蛋白质组学与材料科学的交叉前沿,蜘蛛丝蛋白序列与纤维力学性能的映射关系正成为研究热点。该数据集以拖丝纤维断裂韧性、杨氏模量、强度及应变率为预测目标,通过将同一纤维样本关联的全部丝蛋白序列聚合成组,构建了270个样本的多序列-属性映射基准。这一设计精准回应了学界对避免序列级数据泄露、提升模型泛化能力的迫切需求,为ESMC嵌入结合集合聚合模型(如DeepSets、Set Transformer)提供了标准评测平台。近期研究焦点已从单一序列预测转向多丝蛋白协同作用的建模,并结合大语言模型探索序列组成与力学性能的生成式设计,推动了蛛丝仿生材料从序列到宏观性能的端到端预测范式革新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

