遇见数据集

zh-tw-llm-dv/zh-tw-pythia-ta8000-v1-it1-sg-001

收藏
Hugging Face2023-05-18 更新2024-03-04 收录
官方服务:

资源简介:

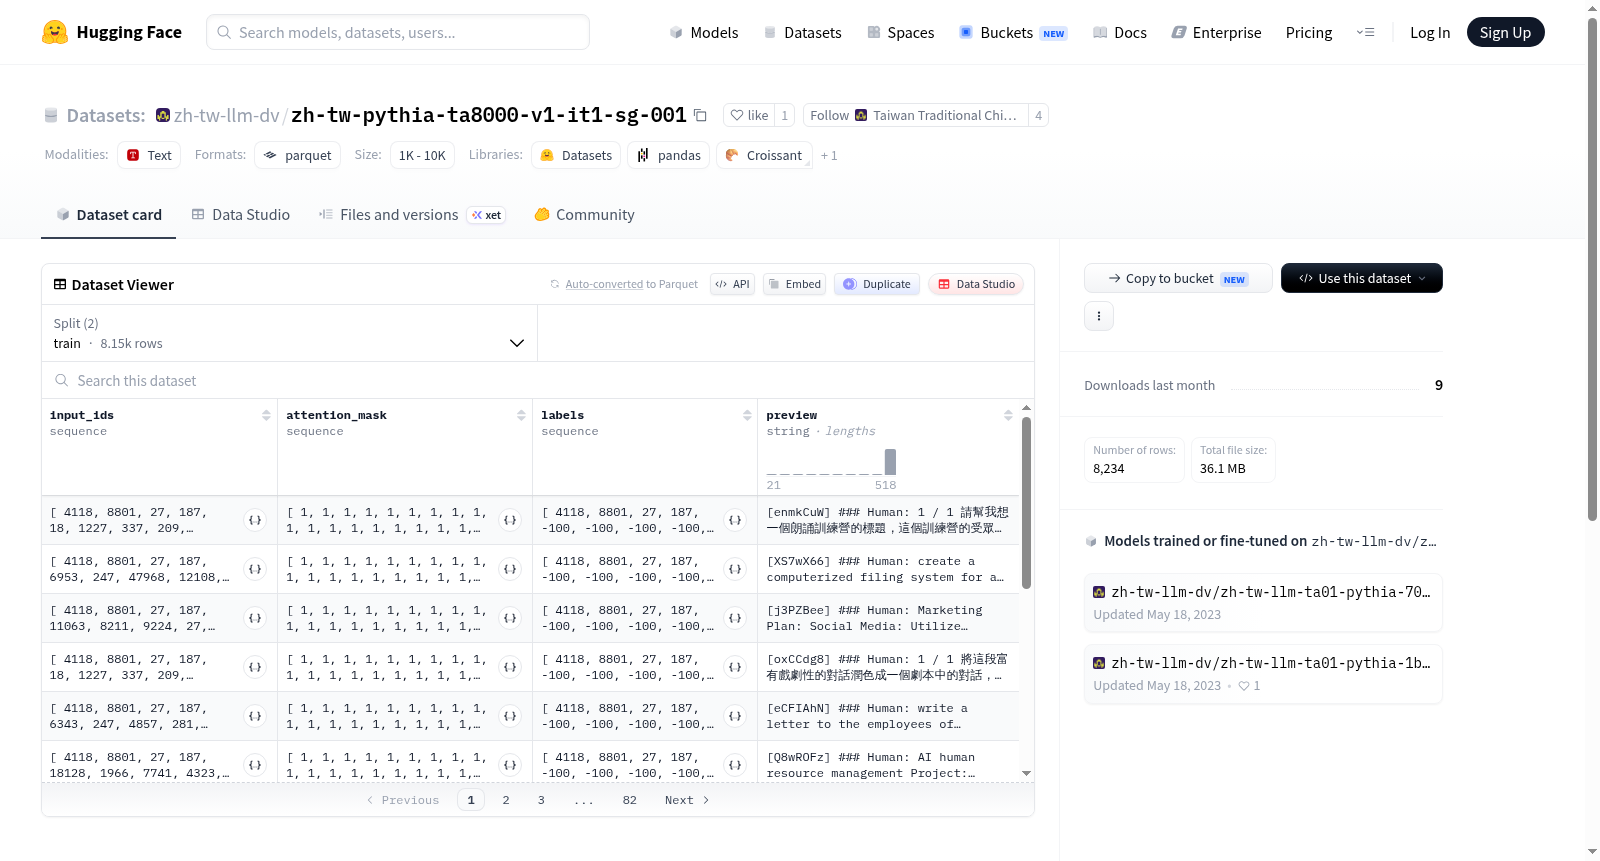
--- dataset_info: dataset_size: 125318970.0 download_size: 36093839 features: - name: input_ids sequence: int32 - name: attention_mask sequence: int8 - name: labels sequence: int64 - dtype: string name: preview splits: - name: train num_bytes: 123951700.0 num_examples: 8150 - name: test num_bytes: 1367270.0 num_examples: 84 --- # zh-tw-pythia-ta8000-v1-it1-sg-001 This dataset is a part of the `zh-tw-llm` project. * Tokenizer: `zh-tw-pythia-tokenizer-a8000-v1` * Built with: `sharegpt` * Rows: `train` `8150`, `test` `84` * Max length: `2048` * Full config: ```json {"build_with": ["sharegpt"], "preview_length": 512, "sharegpt_settings": {"source_dataset": "zetavg/ShareGPT-Processed", "train_on_inputs": false, "languages": [{"en": 0.3}, {"zh": 0.2}, "zh_Hant"], "rows_limit": 10000, "test_size": 0.01, "test_split_seed": 42, "test_rows_limit": 100}} ```

--- 数据集信息: 数据集总大小:125318970.0 字节 下载大小:36093839 字节 特征: - 输入ID(input_ids):序列类型为int32 - 注意力掩码(attention_mask):序列类型为int8 - 标签(labels):序列类型为int64 - 预览文本(preview):数据类型为string(字符串) 划分集: - 训练集(train):占用字节数123951700.0,样本数量8150 - 测试集(test):占用字节数1367270.0,样本数量84 --- # zh-tw-pythia-ta8000-v1-it1-sg-001 本数据集隶属于`zh-tw-llm`项目。 * 分词器(Tokenizer):`zh-tw-pythia-tokenizer-a8000-v1` * 构建工具:`sharegpt` * 样本规模:训练集(train)共8150条,测试集(test)共84条 * 最大序列长度:2048 * 完整配置: json {"build_with": ["sharegpt"], "preview_length": 512, "sharegpt_settings": {"source_dataset": "zetavg/ShareGPT-Processed", "train_on_inputs": false, "languages": [{"en": 0.3}, {"zh": 0.2}, "zh_Hant"], "rows_limit": 10000, "test_size": 0.01, "test_split_seed": 42, "test_rows_limit": 100}}

提供机构:
zh-tw-llm-dv
原始信息汇总

数据集概述

基本信息

  • 数据集大小: 125318970.0 字节
  • 下载大小: 36093839 字节

特征信息

  • input_ids: 序列类型为 int32
  • attention_mask: 序列类型为 int8
  • labels: 序列类型为 int64
  • preview: 数据类型为字符串

数据分割

  • 训练集:
    • 字节数: 123951700.0
    • 样本数: 8150
  • 测试集:
    • 字节数: 1367270.0
    • 样本数: 84
搜集汇总
数据集介绍
zh-tw-llm-dv/zh-tw-pythia-ta8000-v1-it1-sg-001 数据集图片
构建方式
该数据集源自zh-tw-llm项目,旨在为繁体中文语言模型的指令微调提供高质量训练资源。构建过程依托sharegpt框架,从zetavg/ShareGPT-Processed源数据集中筛选出包含英文、中文及繁体中文的多语言对话样本,其中英文占比30%、中文占比20%、繁体中文占比50%。通过设定最大序列长度2048、预览长度512等参数,对原始对话进行结构化处理,最终生成包含8150条训练样本和84条测试样本的语料库。
特点
数据集以指令微调为核心目标,每个样本均包含input_ids、attention_mask和labels三部分,分别对应分词后的输入序列、注意力掩码以及标签序列,确保模型训练时能够准确区分输入与目标输出。此外,preview字段以字符串形式提供样本预览,便于人工核查数据质量。数据集规模适中,训练集与测试集按0.01比例划分,并采用固定随机种子确保可复现性,适合中小规模模型的迭代优化。
使用方法
使用该数据集时,可直接通过HuggingFace Datasets库加载,支持按train和test两个子集进行划分。模型训练前需配合专用的zh-tw-pythia-tokenizer-a8000-v1分词器,将原始文本转换为input_ids和attention_mask格式。由于数据集已预处理好labels字段,训练时可直接采用标准的因果语言模型损失函数进行优化,无需额外标注。建议将最大序列长度设置为2048以匹配数据集配置,并关注训练集与测试集之间的分布一致性。
背景与挑战
背景概述
在大型语言模型(LLM)快速演进的浪潮中,中文繁体(zh-Hant)语言资源的稀缺性成为制约该区域自然语言处理技术发展的关键瓶颈。为填补这一空白,zh-tw-llm项目于2023年应运而生,由多位在中文NLP领域深耕的研究者共同发起,旨在构建高质量、领域适配的繁体中文语料库。该数据集作为项目第一阶段指令微调任务的核心产出,基于ShareGPT对话数据经精心筛选与转换而成,聚焦于繁体中文语境下的对话生成与理解。其设计兼顾语言纯净度与任务多样性,通过控制语言比例与样本数量,为后续模型训练提供了可靠的基础。该数据集不仅推动了繁体中文LLM的实证研究,也为多语言模型在区域性语言上的适配树立了范式,对促进中文信息处理的多元化发展具有重要影响力。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,繁体中文对话生成任务长期受限于数据稀疏性与语言歧义性,尤其是口语化表达与正式书面语之间的转换难度较大,现有模型易产生语义偏差或风格不匹配。其次,构建过程中,从ShareGPT原始数据中提取高质量繁体中文片段需要严格的语言过滤与去噪,而繁体中文与简体中文及英文的混合使用增加了标注难度。此外,数据集规模有限(训练集仅8150条),难以覆盖繁体中文的丰富方言变体与专业领域术语,可能导致模型在特定场景下泛化能力不足。如何在不引入噪声的前提下有效扩充数据、平衡语言多样性,是当前亟待解决的核心挑战。
常用场景
经典使用场景
在大型语言模型(LLM)的微调与对齐研究中,zh-tw-pythia-ta8000-v1-it1-sg-001数据集扮演着至关重要的角色。该数据集基于ShareGPT处理流程构建,专为繁体中文语境下的指令微调任务设计,其经典使用场景聚焦于提升模型在繁体中文对话、问答及任务遵循方面的能力。通过8150条训练样本与84条测试样本的精心配比,研究者能够高效地训练模型理解繁体中文的语法结构与文化表达,从而在保持2048 token上下文长度的前提下,实现更精准的指令响应。这一场景不仅验证了数据集在低资源语言(如繁体中文)上的适配性,也为后续多语言LLM的本地化优化提供了基准实验框架。
实际应用
在实际应用中,该数据集驱动的模型微调已显著提升了繁体中文智能客服、教育辅导及内容生成系统的性能。例如,在台湾地区的电商平台或银行系统中,基于此数据集微调后的模型能够更自然地处理用户用繁体中文提出的复杂查询,如退换货政策解释或理财产品推荐。此外,在繁体中文电子书摘要生成或新闻写作辅助工具中,该数据集帮助模型避免了简体中文词汇的误用,并增强了其对特定文化典故(如成语、谚语)的理解能力,从而大幅降低了人工审核成本,提升了用户体验的流畅度与本地化契合度。
衍生相关工作
围绕zh-tw-pythia-ta8000-v1-it1-sg-001数据集,学术界已衍生出多项经典工作。一方面,研究者基于其混合语言采样策略,提出了自适应语言权重调节的微调框架,用于优化多语言LLM在稀有语种上的表现;另一方面,该数据集与Pythia系列分词器(zh-tw-pythia-tokenizer-a8000-v1)的结合,催生了针对繁体中文的词汇扩展技术,有效解决了分词粒度与语义保留的平衡问题。此外,部分工作借鉴其ShareGPT处理流水线,开发了面向闽南语、客家话等台湾本土语言的指令数据集,推动了区域语言模型的系统性构建,并作为评估基准被用于对比不同微调策略在文化敏感性任务上的鲁棒性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务